Résilience opérationnelle mobile sous DORA : la bibliothèque d'exercices la plus simple pour les parcours BFSI
Un guide de la conformité DORA centré sur le mobile pour les équipes BFSI. Apprenez à définir votre périmètre, à simplifier votre processus de release et à éviter les pièges qui créent un travail de conformité inutile.
Si l'article 2 visait à faire de la conformité DORA une gouvernance de release ordinaire, celui-ci répond à la question pratique suivante, que l'on pose toujours aux équipes mobiles :
« Que se passe-t-il quand quelque chose tombe en panne ? »
Dans le mobile BFSI, cette question est rarement théorique. Une dépendance se dégrade, un fournisseur a une mauvaise journée, un changement de configuration se propage de la mauvaise façon, et soudain les clients ne peuvent plus se connecter ni valider un paiement. L'objectif de la résilience opérationnelle n'est pas de faire comme si ces choses n'arrivaient jamais. Il s'agit de s'assurer que vous avez répété les modes de défaillance qui comptent le plus, et que vous pouvez montrer ce que vous avez fait et ce que vous avez appris.
Cet article vous propose une bibliothèque d'exercices simple, centrée sur les parcours critiques du mobile. Elle est conçue pour être facile à exécuter, facile à documenter par des preuves et facile à améliorer dans le temps, sans transformer votre équipe en comité d'exercices à plein temps.
Comment utiliser cet article
Pour tirer de la valeur le plus simplement possible, choisissez quatre exercices dans la bibliothèque ci-dessous et commencez par eux. Exécutez un exercice à la fois sur un seul parcours, et gardez une sortie homogène. Utilisez le modèle de rapport d'exercice de l'étape 3, et gardez des actions de suivi petites et concrètes. Avant de commencer, assurez-vous que tout le monde s'accorde sur ce que vous cherchez réellement à rendre résilient.
Ce que signifie la « résilience opérationnelle » pour les équipes mobiles
Pour le mobile, la résilience se mesure au mieux par la question « un client peut-il mener à bien un parcours critique en toute sécurité ». Pas « le système est-il disponible ». Pas « la supervision s'est-elle déclenchée ». Les parcours vous gardent honnête parce qu'ils reflètent ce que vivent les utilisateurs.
Dans le mobile BFSI, les parcours critiques sont prévisibles :
- Connexion
- Authentification renforcée (step-up), comme l'OTP ou les validations par push
- Récupération de compte
- Paiements et virements
Quand ces parcours se dégradent, les clients le ressentent immédiatement. C'est pourquoi un programme de résilience opérationnelle centré sur le mobile commence par les parcours, puis remonte vers les dépendances.
Choisissons les parcours, puis cartographions les dépendances, car les exercices sont bien plus faciles quand tout le monde s'accorde sur ce qui est relié à quoi.
Étape 1 : choisissez vos parcours critiques, puis listez leurs dépendances
Restez simple. Commencez avec trois à cinq parcours. La plupart des équipes n'ont pas besoin de plus au départ.
Ensemble de parcours mobiles BFSI recommandé
- Connexion
- Authentification renforcée (step-up), OTP et validations par push
- Récupération de compte
- Paiements et virements
- Onboarding et KYC, s'il existe dans votre application
Pour chaque parcours, documentez les dépendances
Vous n'avez pas besoin d'un schéma parfait. Une courte liste suffit.
Exemple de liste de dépendances pour la connexion :
- Fournisseur d'identité et service de jetons
- Passerelle d'API backend
- Décision de risque ou de fraude, si elle est utilisée à la connexion
- Configuration distante ou feature flags pouvant modifier le comportement de l'authentification
- Configuration de la couche réseau mobile, y compris le certificate pinning s'il est utilisé
- Pipeline d'observabilité et de télémétrie
Cette liste de dépendances est ce qui transforme la « résilience » en quelque chose que vous pouvez tester.
Nous pouvons maintenant exécuter des exercices qui correspondent à de vrais modes de défaillance, au lieu d'un chaos générique pour le plaisir du chaos.
Étape 2 : la bibliothèque d'exercices, les scénarios qui comptent le plus dans le mobile BFSI
Voici des exercices que vous pouvez exécuter sans mise en place lourde. Chacun est lié à un parcours critique et à un schéma de dépendance qui provoque un impact client réel dans le BFSI. Commencez par trois ou quatre, exécutez-les, notez ce qui vous a surpris, puis élargissez. Vous n'essayez pas de devenir une entreprise d'ingénierie du chaos. Vous essayez de rendre les modes de défaillance les plus courants ennuyeux.
Une façon simple de garder ces exercices homogènes est de répondre chaque fois aux cinq mêmes questions : qu'avons-nous simulé, comment l'avons-nous simulé en toute sécurité, que doit faire l'application, que doit pouvoir voir et décider l'équipe, et quelles preuves conservons-nous.
Démarrage rapide : si vous n'exécutez que quatre exercices
Si vous n'exécutez que quatre exercices pour commencer, cet ensemble couvre une grande partie de la réalité du mobile BFSI :
- Dégradation du fournisseur d'identité
- Latence de l'OTP et échec de livraison
- La passerelle d'API, le WAF ou la limitation de débit bloque du trafic mobile légitime
- Erreur de configuration distante ou de feature flag
| Exercice | Parcours impacté | Ce qui casse | À quoi ressemble le « bon » résultat | Preuves à conserver |
|---|---|---|---|---|
| 1. Dégradation du fournisseur d'identité | Connexion, renouvellement du jeton | Latence d'authentification élevée, 5xx intermittents, échecs de renouvellement, échecs d'initialisation de session | Nouvelles tentatives sûres avec backoff, sans tempête de retries ; état de session propre ; UX d'erreur claire ; évaluation rapide de l'impact par version | Tableaux de bord de latence et d'erreurs d'authentification ; note d'impact par version ; journal des décisions sur les mesures d'atténuation testées |
| 2. Latence de l'OTP et échec de livraison | Authentification renforcée (step-up) | OTP retardé ou manquant, boucles de renvoi, limitation, délais d'expiration de corrélation | Limites de renvoi et délai d'attente appliqués ; aucune impasse pour l'utilisateur ; messages sûrs ; choix de repli opérationnel clair | Instantané du taux de réussite et de la latence de l'OTP ; capture des états d'expérience utilisateur ; notes de modification de suivi sur la politique de renvoi/UI |
| 3. Perturbation des validations par push | Authentification renforcée (step-up), validations | Retards/panne des push, invalidation de jetons, validations tardives après expiration | Expirations propres ; aucune validation bloquée ; état cohérent entre les tentatives ; chemin de récupération clair | Métriques de livraison des push ; instantané de la chronologie d'une validation tardive ; mises à jour du runbook pour le support/l'escalade |
| 4. La passerelle d'API, le WAF ou la limitation de débit bloque le trafic mobile | Connexion, paiements | Règle WAF déclenchée à tort, limites de débit strictes, dégradation partielle de la passerelle d'API, blocages propres à un endpoint | Gestion stable des 4xx/5xx ; nouvelles tentatives bornées ; pas d'amplification de charge ; comportement sûr de nouvelle tentative de paiement | Extrait du journal des changements de configuration ; taux d'erreur avant/après retour arrière ; note sur le comportement du client face aux 429/403 |
| 5. Répétition d'une rotation de certificat et d'un échec de pinning | Tous les parcours en réseau | Problèmes de chaîne de certificats, pin set non concordant, échecs de confiance, décalage d'horloge de l'appareil | État d'échec prévisible ; récupération répétée ; aucun contournement non sécurisé du type « on le désactive » | Extrait du runbook et améliorations ; impact délimité par version d'application ; leçons clés pour le processus de rotation |
| 6. Erreur de configuration distante ou de feature flag | Connexion, paiements, stabilité au démarrage | Mauvais déploiement de configuration, panne du service de configuration, flags périmés ou incohérents | Valeurs par défaut sûres ; garde-fous contre les mauvaises combinaisons ; démarrage stable ; retour arrière rapide et vérifiable | Instantané de la piste d'audit de configuration ; métriques avant/après retour arrière ; améliorations de suivi des valeurs par défaut/garde-fous |
| 7. Mauvaise configuration de la décision de fraude ou de risque | Connexion, step-up, paiements | Faux positifs, blocages de comptes, pics inattendus de step-up, résultats de risque incohérents | Gestion cohérente ; messages sûrs ; étape suivante claire pour l'utilisateur ; retour arrière coordonné et mesure de la récupération | Instantané des métriques de décision de risque ; mise à jour des consignes du support si nécessaire ; journal des décisions sur les changements de politique et le retour arrière |
| 8. Incident d'une dépendance tierce affectant un parcours | Paiements, onboarding/KYC, scoring de risque | Erreurs/latence du fournisseur, réponses mal formées, comportement dégradé de la dépendance | Dégradation maîtrisée ; état cohérent ; pas d'appels d'amplification répétés ; décision de repli claire | Instantané des erreurs/latence du fournisseur ; résumé de la décision de repli ; améliorations de supervision/runbook ajoutées |
Les exercices ne sont utiles que si vous capturez les bonnes preuves ; sinon, ils deviennent un événement de calendrier qui disparaît dans l'historique du chat.
Étape 3 : ce que chaque exercice doit produire, les preuves qui aident vraiment
Gardez une sortie d'exercice légère et homogène. Vous voulez quelque chose qui aide l'ingénierie à s'améliorer, aide les décideurs à comprendre le risque et alimente les preuves dont vous aurez besoin plus tard.
Le modèle minimal de rapport d'exercice
Utilisez le même modèle pour chaque exercice.
| Rapport d'exercice | Détails |
|---|---|
| Résumé de l'exercice | Parcours testé • Scénario simulé • Environnement • Participants (rôles, pas noms) |
| Moments clés | Heure de début • Heure de détection • Actions de confinement et heure • Heure de récupération |
| Impact | Expérience client • Versions d'application concernées (le cas échéant) • Remarques régionales ou propres au fournisseur |
| Décisions | Ce qui a été changé, par qui et pourquoi • Ce qui n'a pas été changé et pourquoi |
| Résultats | Ce qui a bien fonctionné • Ce qui était confus ou lent • Supervision/télémétrie manquante |
| Suivis | 1 à 3 améliorations concrètes • Un responsable pour chaque amélioration • Plan de vérification des améliorations |
C'est assez de preuves pour être utile sans devenir de la paperasse.
Passons à la partie la plus importante : transformer les leçons des exercices en contrôles de release, pour que le même problème ne vous surprenne plus.
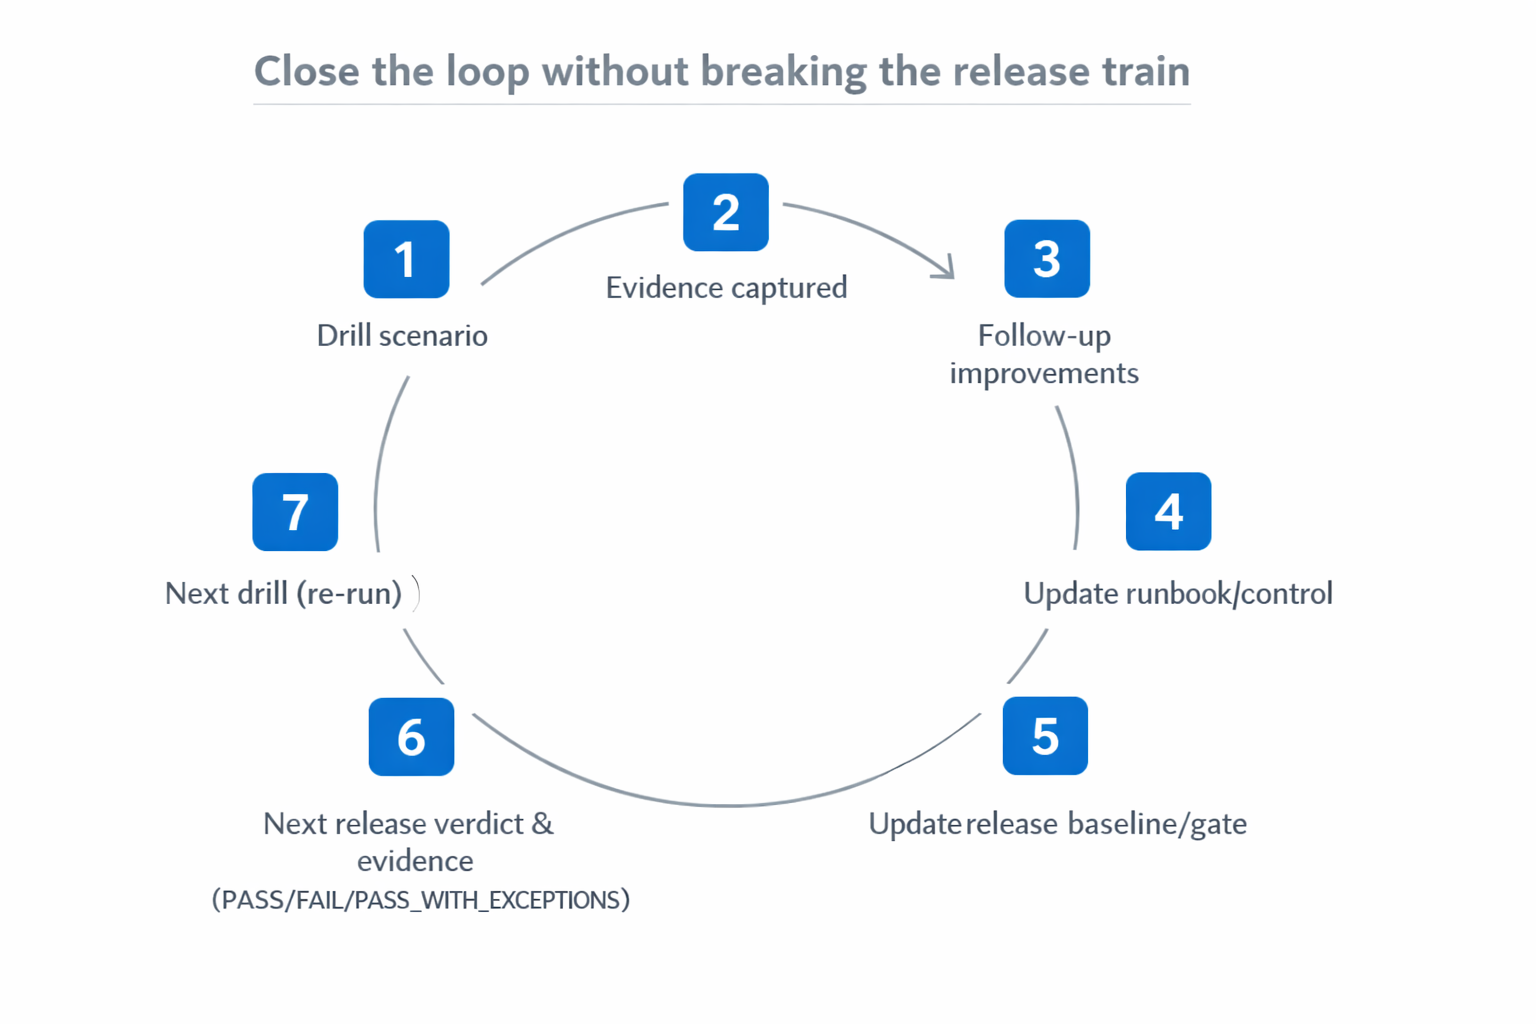
Étape 4 : bouclez la boucle, les exercices doivent modifier les contrôles de release
C'est ici que le travail de résilience devient une partie de votre programme de release, au lieu d'une activité parallèle.
Après chaque exercice, posez deux questions :
- Qu'est-ce qui aurait évité ce problème, ou réduit son impact, avant la release ?
- Que devons-nous ajouter à notre référentiel de release ou à nos runbooks pour faire mieux la prochaine fois ?
Exemples d'améliorations « de l'exercice au contrôle » :
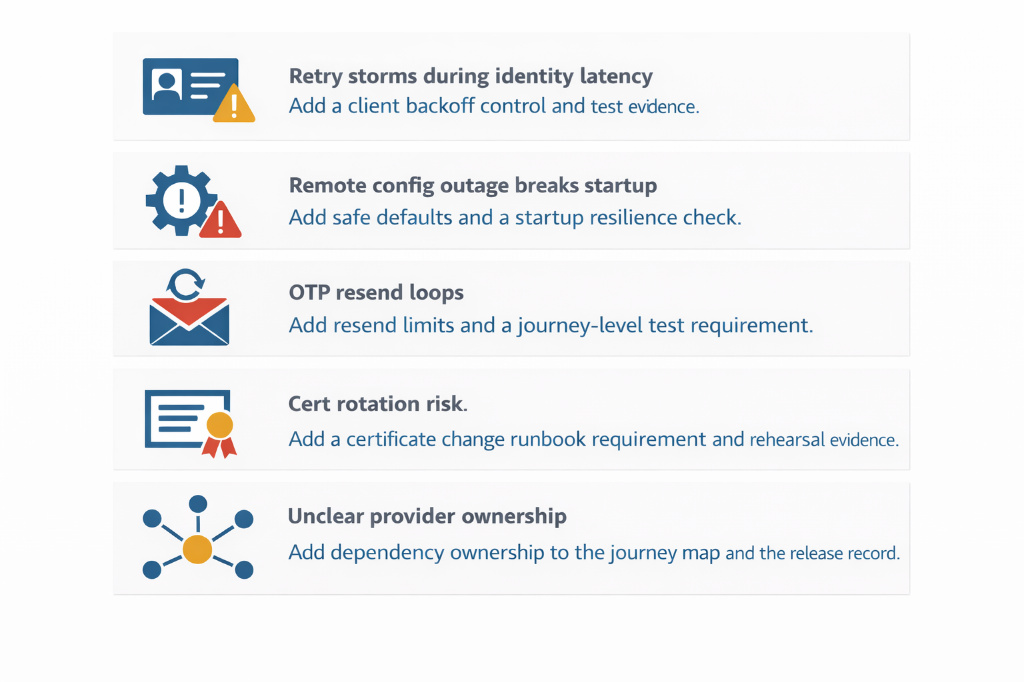
C'est aussi là que l'article 2 et l'article 3 se rejoignent. Le référentiel de release doit inclure un petit ensemble de contrôles de préparation à la résilience. Les exercices sont ce qui rend ces contrôles réels.
Un dernier détail pratique : comment exécuter les exercices sans provoquer de perturbation ni sur-concevoir le processus.
Comment mener ces exercices sans rendre votre équipe malheureuse
Quelques règles simples rendent les exercices de résilience tenables pour les équipes mobiles.
Commencez par des exercices sur table (tabletop) si les tests en conditions réelles sont risqués. Vous pouvez tout de même dérouler le scénario, valider les responsabilités et les points de décision, et améliorer les runbooks sans toucher à des systèmes proches de la production. Concentrez chaque exercice sur un seul parcours à la fois, car tout tester en même temps signifie généralement que vous n'apprenez rien de clair.
Rendez la sortie homogène en utilisant chaque fois le même modèle de rapport d'exercice, même s'il est court. Limitez volontairement les suivis. Une à trois améliorations par exercice suffisent largement, sinon les exercices créent un backlog dont personne ne veut être responsable. Enfin, rejouez un scénario plus tard. La répétition est ce qui prouve que les changements ont amélioré la résilience, et c'est ce qui fait que les exercices cessent d'être des événements ponctuels pour devenir des opérations mobiles normales.
Conclusion
La résilience opérationnelle sous DORA n'a pas à être compliquée. Pour les équipes mobiles, l'approche la plus simple consiste à se concentrer sur les parcours critiques, à s'exercer sur les modes de défaillance qui les cassent et à produire des preuves légères qui mènent à des améliorations concrètes.
Dans le prochain article, nous aborderons le domaine qui réserve le plus de surprises dans le mobile : le risque lié aux tiers. Nous traiterons l'inventaire des SDK et le contrôle des changements, les dépendances aux fournisseurs pour les parcours critiques, et la manière de constituer des dossiers de preuves faciles à relire plus tard.
À suivre : Le risque tiers DORA pour l'AppSec mobile : gouvernance des SDK et dossiers de preuves prêts pour l'audit