Resiliencia operativa móvil bajo DORA: la biblioteca de simulacros más sencilla para los recorridos del sector BFSI
Una guía de DORA centrada en el entorno móvil para los equipos del sector BFSI. Aprenda a definir su alcance, simplificar su proceso de publicación y evitar las trampas que generan trabajo de cumplimiento innecesario.
Si el artículo 2 trataba de hacer que el cumplimiento de DORA se sintiera como una gobernanza normal de las publicaciones, este aborda la siguiente pregunta práctica que siempre les hacen a los equipos móviles:
«¿Qué ocurre cuando algo falla?»
En el entorno móvil del sector BFSI, esa pregunta rara vez es teórica. Una dependencia se degrada, un proveedor tiene un mal día, un cambio de configuración se propaga en la dirección equivocada y, de repente, los clientes no pueden iniciar sesión ni aprobar un pago. El objetivo de la resiliencia operativa no es fingir que estas cosas nunca ocurren. Es asegurarse de haber ensayado los modos de fallo que más importan y de poder demostrar lo que se hizo y lo que se aprendió.
Este artículo le ofrece una biblioteca de simulacros sencilla, centrada en los recorridos críticos móviles. Está diseñada para que sea fácil de ejecutar, fácil de documentar con evidencias y fácil de mejorar con el tiempo, sin convertir a su equipo en un comité de ejercicios a tiempo completo.
Cómo usar este artículo
Si desea obtener valor de la forma más sencilla, elija cuatro simulacros de la biblioteca siguiente y empiece por ahí. Ejecute un simulacro cada vez sobre un recorrido y mantenga la salida coherente. Utilice la plantilla de informe de simulacro del paso 3 y mantenga los seguimientos pequeños y concretos. Antes de empezar, asegúrese de que todos estén de acuerdo en lo que realmente intenta mantener resiliente.
Qué significa «resiliencia operativa» para los equipos móviles
En el entorno móvil, la resiliencia se mide mejor como «¿puede un cliente completar un recorrido crítico de forma segura?». No como «¿está el sistema en funcionamiento?». Ni como «¿saltó la monitorización?». Los recorridos le mantienen honesto porque reflejan lo que experimentan los usuarios.
En el entorno móvil del sector BFSI, los recorridos críticos son previsibles:
- Inicio de sesión
- Autenticación reforzada, como OTP o aprobaciones push
- Recuperación de cuenta
- Pagos y transferencias
Cuando estos recorridos se degradan, los clientes lo notan de inmediato. Por eso un programa de resiliencia operativa centrado en el entorno móvil empieza por los recorridos y luego retrocede hasta las dependencias.
Elijamos los recorridos y después mapeemos las dependencias, porque los simulacros resultan mucho más fáciles cuando todos coinciden en qué está conectado con qué.
Paso 1: elija sus recorridos críticos y enumere sus dependencias
Manténgalo sencillo. Empiece con entre tres y cinco recorridos. La mayoría de los equipos no necesita más al principio.
Conjunto de recorridos móviles BFSI recomendado
- Inicio de sesión
- Autenticación reforzada, OTP y aprobaciones push
- Recuperación de cuenta
- Pagos y transferencias
- Incorporación y KYC, si existe en su aplicación
Documente las dependencias de cada recorrido
No necesita un diagrama perfecto. Basta con una lista breve.
Ejemplo de lista de dependencias para el inicio de sesión:
- Proveedor de identidad y servicio de tokens
- Pasarela de API del backend
- Decisiones de riesgo o fraude, si se utilizan en el inicio de sesión
- Configuración remota o feature flags que pueden cambiar el comportamiento de la autenticación
- Configuración de la capa de red móvil, incluida la fijación de certificados si se utiliza
- Pipeline de observabilidad y telemetría
Esta lista de dependencias es lo que convierte la «resiliencia» en algo que se puede probar.
Ahora podemos ejecutar simulacros que se correspondan con modos de fallo reales, en lugar de un caos genérico por el caos mismo.
Paso 2: la biblioteca de simulacros, los escenarios que más importan en el entorno móvil BFSI
A continuación se presentan simulacros que puede ejecutar sin una configuración enorme. Cada uno está vinculado a un recorrido crítico y a un patrón de dependencia que causa un impacto real en los clientes del sector BFSI. Empiece con tres o cuatro, ejecútelos, anote lo que le sorprendió y después amplíe. No se trata de convertirse en una empresa de ingeniería del caos. Se trata de conseguir que los modos de fallo más comunes resulten aburridos.
Una forma sencilla de mantener la coherencia de estos simulacros es responder siempre a las mismas cinco preguntas: qué simulamos, cómo lo simulamos de forma segura, qué debería hacer la aplicación, qué debería poder ver y decidir el equipo y qué evidencias conservamos.
Inicio rápido: si solo ejecuta cuatro simulacros
Si empieza ejecutando solo cuatro simulacros, este conjunto cubre gran parte de la realidad móvil del sector BFSI:
- Degradación del proveedor de identidad
- Latencia y fallo de entrega de OTP
- La pasarela de API, el WAF o la limitación de tasa bloquean el tráfico móvil legítimo
- Error en la configuración remota o en un feature flag
| Simulacro | Recorrido afectado | Qué falla | Cómo es un buen resultado | Evidencias que capturar |
|---|---|---|---|---|
| 1. Degradación del proveedor de identidad | Inicio de sesión, renovación de tokens | Latencia alta en la autenticación, 5xx intermitentes, fallos de renovación, fallos de arranque de sesión | Reintentos seguros con backoff, sin tormentas de reintentos; estado de sesión limpio; experiencia de error clara; evaluación rápida del impacto por versión | Paneles de latencia y errores de autenticación; nota de impacto por versión; registro de decisiones sobre las mitigaciones probadas |
| 2. Latencia y fallo de entrega de OTP | Autenticación reforzada | OTP retrasado o ausente, bucles de reenvío, limitación, tiempos de espera de correlación | Límites de reenvío y tiempos de espera aplicados; sin callejones sin salida para el usuario; mensajes seguros; alternativa operativa clara | Instantánea de la tasa de éxito y la latencia del OTP; captura de los estados de la experiencia de usuario; notas de cambios de seguimiento sobre la política de reenvío y la interfaz |
| 3. Interrupción de las aprobaciones push | Autenticación reforzada, aprobaciones | Retrasos o caída de las notificaciones push, invalidación de tokens, aprobaciones tardías tras el tiempo de espera | Tiempos de espera limpios; sin aprobaciones atascadas; estado coherente entre reintentos; ruta de recuperación clara | Métricas de entrega de notificaciones push; instantánea de la cronología de la aprobación retrasada; actualizaciones del runbook para soporte y escalado |
| 4. La pasarela de API, el WAF o la limitación de tasa bloquean el tráfico móvil | Inicio de sesión, pagos | Una regla del WAF se dispara por error, límites de tasa estrictos, degradación parcial de la pasarela de API, bloqueos específicos de endpoints | Gestión estable de 4xx/5xx; reintentos acotados; sin amplificación de la carga; comportamiento seguro de reintento de pagos | Fragmento del registro de cambios de configuración; tasa de errores antes y después de la reversión; nota sobre el comportamiento del cliente ante 429/403 |
| 5. Ensayo de rotación de certificados y fallo de la fijación de certificados | Todos los recorridos con red | Problemas en la cadena de certificados, discrepancia en el conjunto de pines, fallos de confianza, desfase horario del dispositivo | Estado de fallo predecible; recuperación ensayada; sin soluciones inseguras del tipo «desactívalo» | Extracto del runbook y mejoras; impacto delimitado por versión de la aplicación; lecciones clave para el proceso de rotación |
| 6. Error en la configuración remota o en un feature flag | Inicio de sesión, pagos, estabilidad de arranque | Despliegue de una configuración errónea, caída del servicio de configuración, flags obsoletos o incoherentes | Valores predeterminados seguros; protecciones frente a combinaciones erróneas; arranque estable; reversión rápida y verificable | Instantánea del registro de auditoría de la configuración; métricas antes y después de la reversión; mejoras de seguimiento de los valores predeterminados y las protecciones |
| 7. Configuración errónea de las decisiones de fraude o riesgo | Inicio de sesión, autenticación reforzada, pagos | Falsos positivos, bloqueos, picos inesperados de autenticación reforzada, resultados de riesgo incoherentes | Gestión coherente; mensajes seguros; siguiente paso claro para el usuario; reversión coordinada y medición de la recuperación | Instantánea de las métricas de decisiones de riesgo; actualización de la guía de soporte si es necesario; registro de decisiones sobre los cambios de política y la reversión |
| 8. Incidente de una dependencia de terceros que afecta a un recorrido | Pagos, incorporación/KYC, puntuación de riesgo | Errores o latencia del proveedor, respuestas mal formadas, comportamiento degradado de la dependencia | Degradación segura; estado coherente; sin llamadas de amplificación repetidas; decisión de alternativa clara | Instantánea de errores y latencia del proveedor; resumen de la decisión de alternativa; mejoras añadidas a la monitorización y al runbook |
Los simulacros solo son útiles si captura las evidencias adecuadas; de lo contrario, se convierten en un evento de calendario que desaparece en el historial del chat.
Paso 3: qué debe producir cada simulacro, las evidencias que realmente ayudan
Mantenga la salida de los simulacros ligera y coherente. Lo que se busca es algo que ayude a ingeniería a mejorar, que ayude a quienes toman decisiones a entender el riesgo y que respalde las evidencias que querrá más adelante.
La plantilla mínima de informe de simulacro
Utilice la misma plantilla para todos los simulacros.
| Informe del simulacro | Detalles |
|---|---|
| Resumen del simulacro | Recorrido probado • Escenario simulado • Entorno • Participantes (roles, no nombres) |
| Momentos clave | Hora de inicio • Hora de detección • Acciones de contención y hora • Hora de recuperación |
| Impacto | Experiencia del cliente • Versiones de la aplicación afectadas (si procede) • Notas regionales o específicas del proveedor |
| Decisiones | Qué se cambió, quién lo hizo y por qué • Qué no se cambió y por qué |
| Resultados | Qué funcionó bien • Qué resultó confuso o lento • Monitorización o telemetría que faltaba |
| Seguimientos | 1–3 mejoras concretas • Responsable de cada mejora • Plan de verificación de las mejoras |
Esto es suficiente evidencia para ser útil sin convertirse en papeleo.
Ahora la parte más importante: convertir las lecciones de los simulacros en controles de publicación, para que el mismo problema no vuelva a sorprenderle.
Paso 4: cierre el ciclo, los simulacros deben cambiar los controles de publicación
Aquí es donde el trabajo de resiliencia pasa a formar parte de su programa de publicación, en lugar de ser una actividad paralela.
Tras cada simulacro, plantee dos preguntas:
- ¿Qué habría evitado este problema, o reducido su impacto, antes de la publicación?
- ¿Qué deberíamos añadir a nuestra línea base de publicación o a los runbooks para hacerlo mejor la próxima vez?
Ejemplos de mejoras «del simulacro al control»:
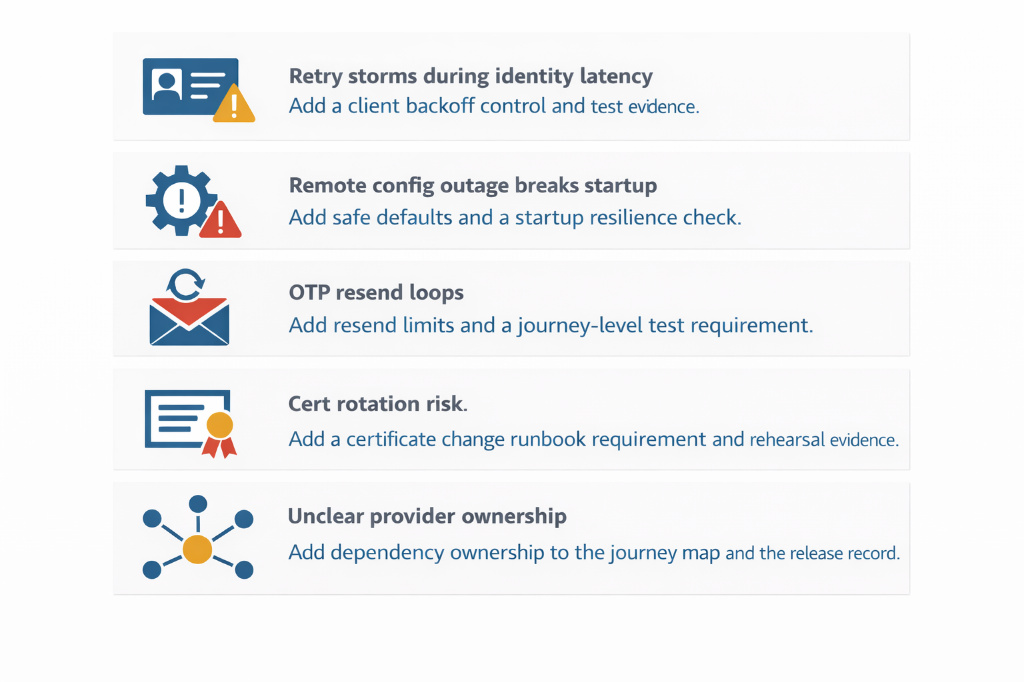
Aquí es también donde se conectan el artículo 2 y el artículo 3. La línea base de publicación debe incluir un pequeño conjunto de controles de preparación para la resiliencia. Los simulacros son los que hacen reales esos controles.
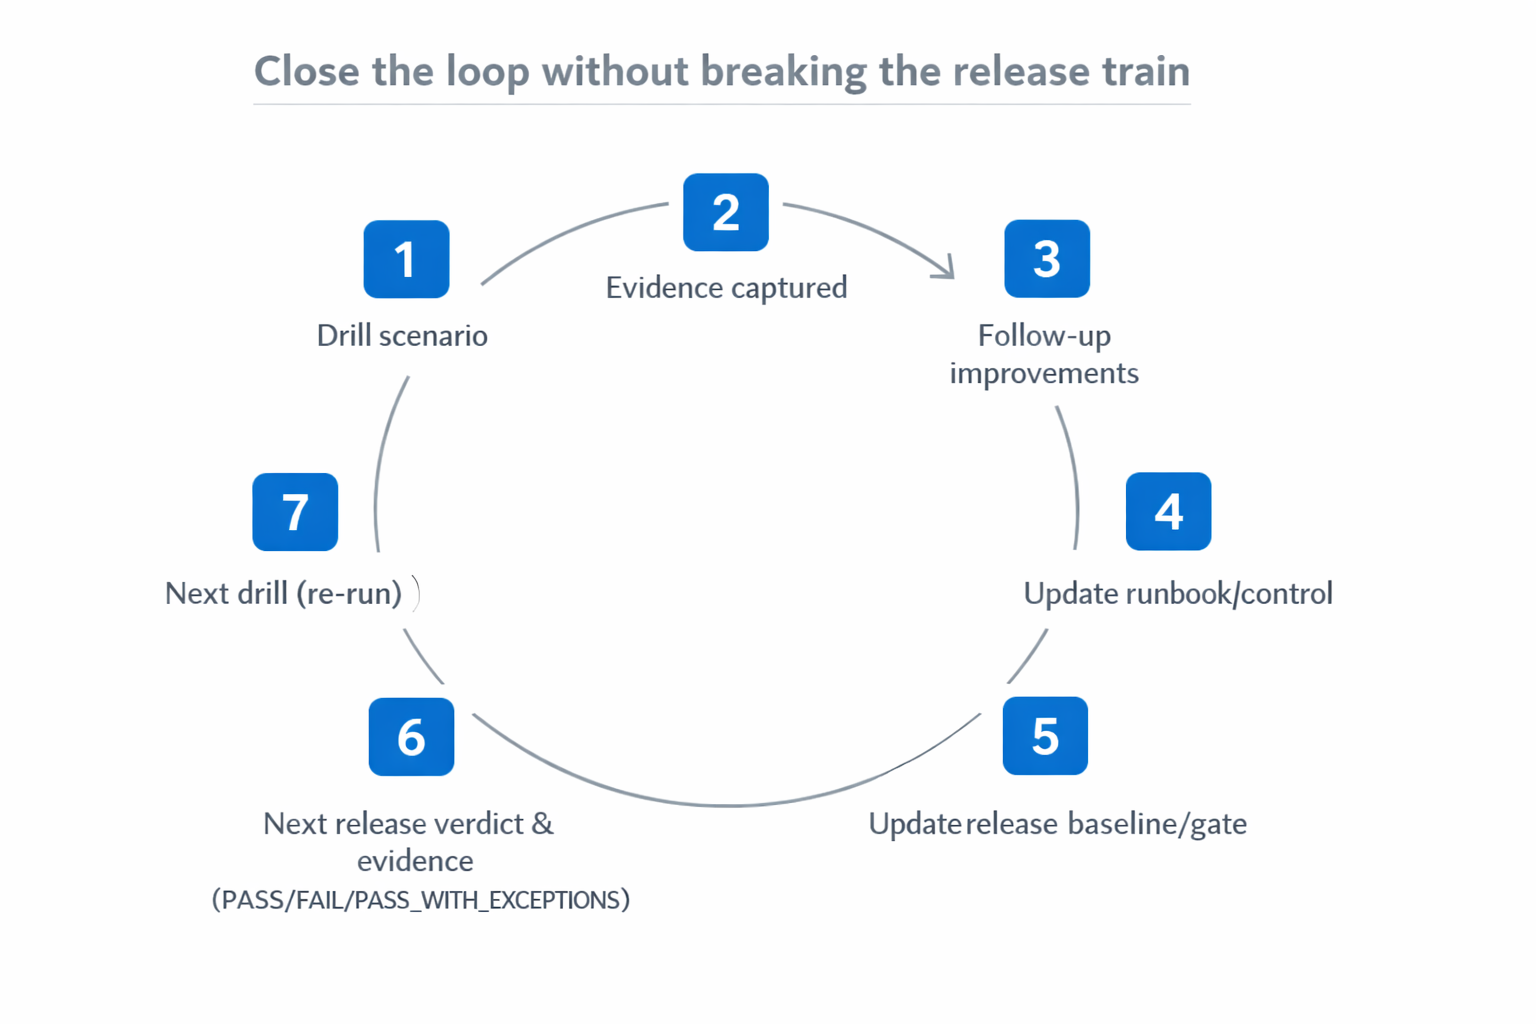
Un último detalle práctico: cómo ejecutar los simulacros sin causar interrupciones ni sobredimensionar el proceso.
Cómo ejecutar estos simulacros sin amargar a su equipo
Unas pocas reglas sencillas hacen que los simulacros de resiliencia sean sostenibles para los equipos móviles.
Empiece con simulacros de mesa si las pruebas en vivo son arriesgadas. Aun así puede recorrer el escenario, validar la responsabilidad y los puntos de decisión y mejorar los runbooks sin tocar sistemas similares a producción. Mantenga cada simulacro centrado en un solo recorrido cada vez, porque probarlo todo a la vez suele significar que no se aprende nada con claridad.
Haga que la salida sea coherente utilizando siempre la misma plantilla de informe de simulacro, aunque sea breve. Limite los seguimientos a propósito. Entre una y tres mejoras por simulacro es más que suficiente; de lo contrario, los simulacros generan una acumulación de tareas pendientes que nadie quiere asumir. Por último, vuelva a ejecutar un escenario más adelante. La repetición es la forma de demostrar que los cambios mejoraron la resiliencia, y es lo que hace que los simulacros dejen de sentirse como eventos puntuales y pasen a formar parte de las operaciones móviles normales.
Conclusión
La resiliencia operativa bajo DORA no tiene por qué ser complicada. Para los equipos móviles, el enfoque más sencillo consiste en centrarse en los recorridos críticos, practicar los modos de fallo que los interrumpen y generar evidencias ligeras que lleven a mejoras concretas.
En el próximo artículo abordaremos el área que suele generar más sorpresas en el entorno móvil: el riesgo de terceros. Trataremos el inventario de SDK y el control de cambios, las dependencias de proveedores en los recorridos críticos y cómo elaborar paquetes de evidencias que resulten fáciles de revisar más adelante.
A continuación: Riesgo de terceros bajo DORA para AppSec móvil: gobernanza de SDK y paquetes de evidencias listos para auditoría