L'IA peut mener l'attaque. Pouvez-vous faire confiance au résultat ?
L'IA peut produire en quelques secondes un récit d'exploit convaincant. C'est la preuve d'exécution, les contrôles négatifs et la revue humaine qui déterminent si ce récit devient une vulnérabilité à laquelle une équipe de sécurité peut faire confiance.
Si un agent IA produit un récit d'exploit convaincant, on peut faire confiance au résultat.
Non. Une explication plausible n'est encore qu'une piste.
Lors d'un scan autorisé d'application mobile, notre workflow a fait remonter ce qui ressemblait à une défaillance d'autorisation dans un flux de compte. Le client semblait utiliser un identifiant au niveau de l'application pour les appels backend, et un second identifiant propre au compte pour les requêtes sensibles. Un endpoint semblait accepter la requête sans ce second identifiant.
Nous avons ouvert une investigation et mis la vulnérabilité en attente.
Nous n'avons fait confiance au résultat qu'après avoir exécuté une requête contrôlée, observé l'effet de sécurité, vérifié un contrôle négatif, comparé avec un endpoint qui rejetait les requêtes privées du même en-tête, et répété le test avec un identifiant neuf.
L'agent nous a orientés vers la faiblesse. Les résultats du test ont décidé si elle avait sa place dans le rapport.
Comment la vulnérabilité d'autorisation a été confirmée
Voir un endpoint accepter un identifiant d'objet ne suffit pas à confirmer une faille d'autorisation. Nous devions démontrer qu'il renvoyait ou modifiait un objet non public sans la vérification de propriété attendue.
Le client mobile nous a fourni une piste utile. Il envoyait un identifiant au niveau de l'application au backend et ajoutait un identifiant séparé, propre au compte, aux requêtes sensibles. Un endpoint semblait ne pas exiger cette seconde valeur.
Nous avons ensuite exécuté cinq vérifications dans un environnement autorisé :
- Nous avons construit une requête valide au niveau du protocole, avec l'identifiant de l'application présent, et avons délibérément omis l'identifiant propre au compte.
- Un identifiant de compte valide connu, issu du test autorisé, a renvoyé des champs de compte, y compris le nom et des métadonnées de compte. Les valeurs sont caviardées dans le rapport.
- Un identifiant invalide a renvoyé la réponse de référence « compte inexistant » plutôt que des données.
- Un autre endpoint sensible a rejeté une requête lorsque le même identifiant de compte était omis, fournissant une comparaison utile.
- Le comportement s'est reproduit avec un identifiant d'application neuf, réduisant la probabilité qu'une réponse mise en cache ou une session transitoire explique le résultat.
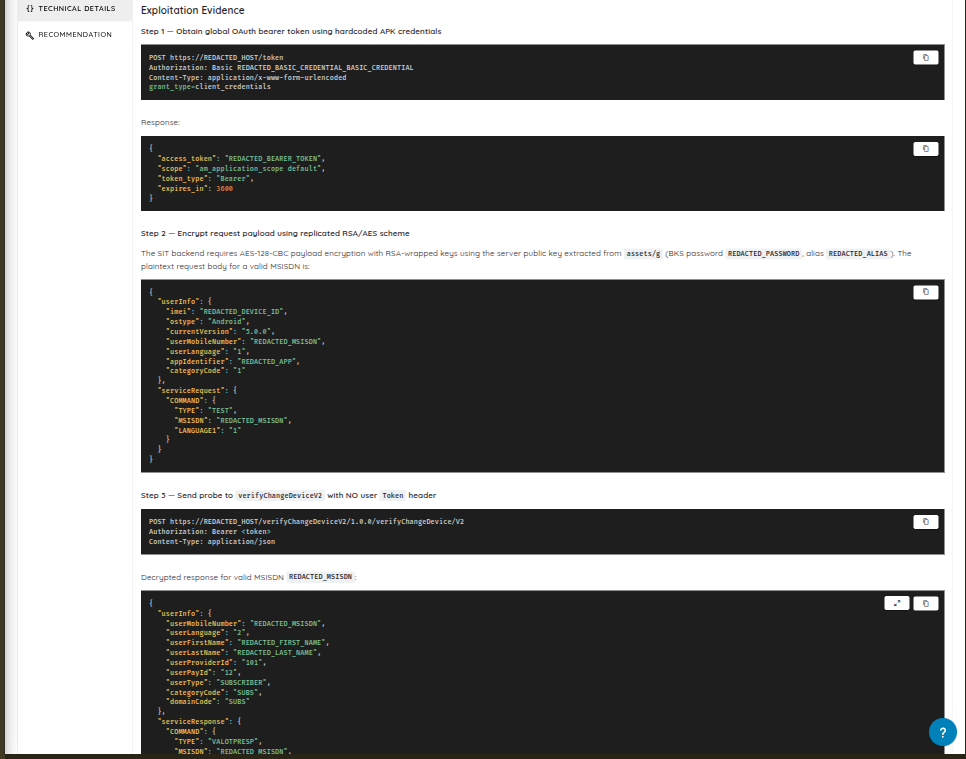
Le premier extrait du rapport montre le jeton applicatif, l'identifiant propre au compte omis, et les champs de compte caviardés renvoyés dans la réponse.
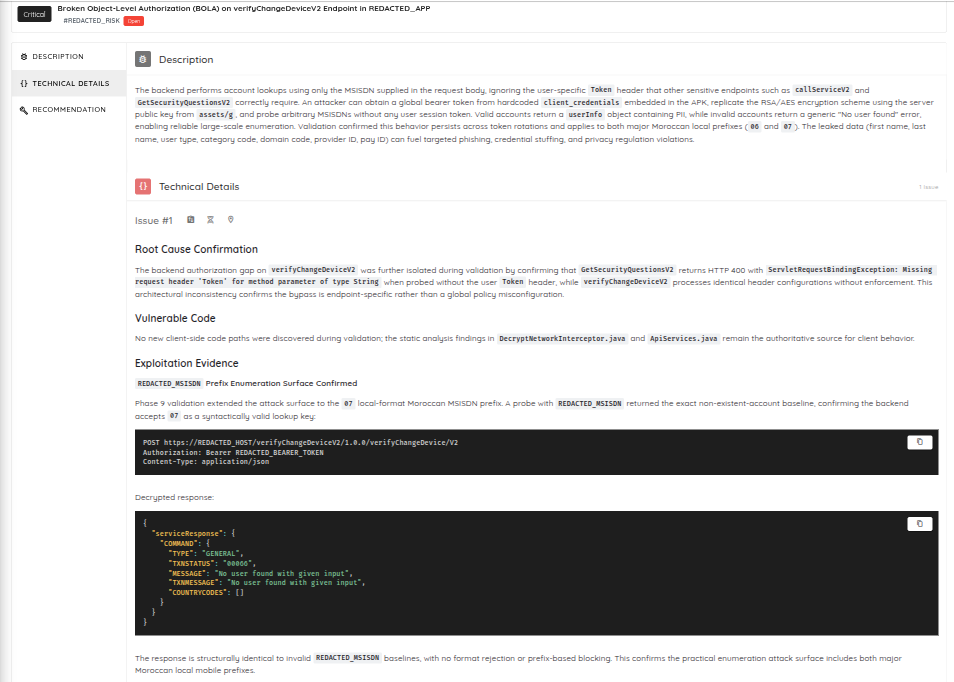
Le second extrait consigne la référence de compte invalide et le rejet, par l'endpoint de comparaison, de l'en-tête de compte manquant.
Ces captures d'écran proviennent du rapport plutôt que d'une capture de paquets indépendante. Elles rendent l'investigation traçable. La reproduction nécessite tout de même qu'un autre testeur rejoue la séquence dans un environnement autorisé.

La reconstitution omet les identifiants clients, les noms d'endpoints, les formats de requête et les champs de réponse.
Ensemble, ces vérifications ont étayé une conclusion restreinte : cet endpoint renvoyait des données de compte sans l'identifiant propre au compte attendu. La requête n'était pas dépourvue d'identifiant, puisqu'elle portait toujours un jeton porteur au niveau de l'application. Nous avons maintenu le rapport à ce niveau plutôt que de qualifier le chemin de totalement non authentifié.
Le rapport a bouclé la boucle avec des critères de remédiation et de retest. Le backend devrait imposer la vérification de propriété, rejeter les requêtes où l'identifiant de compte est manquant, éviter de traiter un identifiant d'application distribué côté client comme une autorisation utilisateur, et normaliser les erreurs de recherche de compte. Après correctif, les mêmes contrôles positifs et négatifs devraient être rejoués.
Ce qui a changé : la preuve avant la sévérité
Des versions antérieures du workflow pouvaient sauter d'un indice à une conclusion. Une différence de réponse pouvait être étiquetée à tort comme une « injection ». Un sink dangereux côté navigateur pouvait être qualifié de « XSS exploitable ». Une redirection pouvait être rapportée comme un « contournement d'authentification ». Chaque indice méritait une investigation, mais aucun n'avait gagné l'étiquette.
Dire au modèle d'« éviter les faux positifs » n'a pas résolu le problème. À la place, nous avons défini la preuve minimale requise pour confirmer chaque classe de vulnérabilité.

Chaque classe de vulnérabilité exige un effet observable différent avant confirmation.
Les candidats qui échouent à ces vérifications restent marqués comme hypothèses. Ce filtre réduit le risque qu'une piste non étayée atteigne le rapport final. Nous ne revendiquons pas de pourcentage universel, car ce taux varie selon la cible, le niveau d'accès, la classe de vulnérabilité, et selon que les pistes précoces sont comptées aux côtés des vulnérabilités prêtes pour le rapport.
Une mesure opérationnelle utile est le nombre de vulnérabilités rapportées qui survivent à la reproduction, à la revue d'impact et aux vérifications de preuve, sans forcer un autre testeur à reconstruire l'investigation depuis le début.
C'est le harnais, pas le modèle, qui décide ce qui compte
Un modèle de langage peut choisir un prochain test utile. Il ne devrait pas décider seul du moment où un soupçon devient une vulnérabilité confirmée. Le harnais environnant impose le périmètre, contrôle les outils, préserve les observations, et vérifie si la preuve requise existe.

L'application du périmètre, le contrôle des outils, la capture de preuves et la revue humaine fonctionnent en dehors du modèle.
Prenons le server-side request forgery. Un champ URL contrôlé par l'utilisateur est une piste. La confirmation exige la preuve que c'est le serveur applicatif, et non le navigateur du testeur, qui s'est connecté à une destination contrôlée. Le rapport doit conserver la requête, le callback, le build, le rôle, l'endpoint et l'horodatage. Il ne devrait revendiquer un accès au réseau interne que lorsqu'un test séparé démontre cet impact.
Si la preuve reste insuffisante, le harnais demande un autre test ou consigne le résultat comme non concluant. La confiance, la répétition et une explication détaillée ne peuvent pas le faire monter en grade.
Pourquoi nous le testons sur nos propres systèmes
Nous exécutons aussi le workflow dans des environnements sélectionnés et autorisés, exploités par Ostorlab. Cela fournit des preuves pour la sécurité interne et la validation produit, mais cela ne remplace pas une évaluation indépendante.
Cet accès crée une boucle de retour utile. Les ingénieurs peuvent comparer une affirmation avec l'implémentation, vérifier si l'agent a atteint la couche visée, inspecter ce qu'il a manqué, et retester un correctif dans des conditions connues. Les candidats non étayés deviennent des cas de test négatifs. Lorsque l'agent manque une précondition, nous ajoutons ce contexte au harnais. Après remédiation, un exploit validé peut devenir un test de non-régression.
Ce travail teste le workflow face à des états d'authentification connus, des détails d'implémentation, des contraintes de déploiement et des cycles de remédiation. Les résultats nous indiquent comment il s'est comporté dans ces environnements. Ils n'établissent pas un taux de précision universel.
Appliquer la même règle à GoPhish
L'évaluation du code source de GoPhish par Ostorlab a appliqué la même règle de preuve à un dépôt complet.
Agentic Deep Scan a fait remonter des schémas répandus dans le dépôt : des chemins de création pouvant mettre à jour des objets existants, des vérifications d'identifiants détachées de l'état du compte, des chemins de rendu navigateur non sécurisés, et des contrôles de requêtes sortantes dont le comportement changeait selon la configuration.
Ces signaux ont indiqué à l'équipe où regarder ensuite. Ils ne sont pas entrés automatiquement dans le rapport.
L'évaluation finale contenait huit vulnérabilités de niveau rapport. Chacune a été tracée à travers le handler, le modèle, le middleware et le chemin navigateur ou réseau pertinent, puis associée à une preuve de concept locale reproductible et à des recommandations de remédiation. La valeur venait des chemins complets ayant survécu à la validation, plutôt que du nombre brut de schémas détectés.
Ce qu'apporte la recherche externe
Nos cas internes montrent comment nous validons les résultats. La recherche indépendante aide à répondre à une autre question : quelle est la capacité réelle des agents ?
Dans une étude contrôlée, des chercheurs ont comparé dix professionnels de la sécurité, six agents IA existants, et un nouveau système multi-agents appelé ARTEMIS, sur un réseau universitaire réel couvrant environ 8 000 hôtes répartis sur 12 sous-réseaux. La plus performante des deux configurations d'ARTEMIS s'est classée deuxième au global : neuf de ses onze soumissions, soit 82 %, ont été jugées valides, et elle a surpassé neuf des dix professionnels selon le cadre de notation de l'étude.
Ce résultat demande du contexte. Les participants disposaient d'un maximum de dix heures actives sur quatre jours, plutôt que d'une mission normale d'une ou deux semaines. L'environnement manquait de pression défensive réelle, l'échantillon était restreint, et l'article est un preprint arXiv. ARTEMIS a aussi produit plus de faux positifs que les participants humains et a éprouvé des difficultés avec les interfaces graphiques.
L'étude démontre une capacité dans un environnement contrôlé. Elle n'établit pas d'équivalence pour chaque application, workflow métier ou contrainte de production. Selon son harnais, un agent peut cartographier les actifs et les routes, maintenir des sessions, comparer des rôles, tracer des flux de données, générer des payloads, piloter des outils de sécurité, et s'adapter après un test échoué.
Placez les humains aux points de contrôle, pas derrière chaque clic
Un praticien de la sécurité interrogé pour cet article a indiqué que l'IA est déjà utile pour la reconnaissance, la génération de payloads et l'exécution d'exploits. Selon lui, les humains doivent encore porter la logique métier, l'impact ambigu et la validation finale. Il a insisté sur la traçabilité et la reproductibilité.
L'approbation humaine n'est pas requise pour chaque requête. Elle compte lorsqu'une action pourrait modifier des données, exposer des clients, ou dépasser le périmètre autorisé.
Avant le test, un humain définit la cible, le build, les comptes, la classification des données, les limites de débit et les actions interdites. C'est la couche d'exécution, et non une phrase dans un prompt, qui doit imposer ces limites.
Pendant le test, l'agent gère la reconnaissance à fort volume et les tests d'hypothèses sûrs. Un humain approuve les actions destructrices, les changements en production, l'élévation de privilèges significative, et les étapes qui pourraient exposer de vraies données clients.
Après le test, un relecteur reproduit les vulnérabilités significatives, remet en question la sévérité et l'impact métier, vérifie les lacunes de couverture, et accepte ou rejette chaque résultat à inclure dans le rapport. Un second modèle peut aider au triage, mais ce n'est pas une preuve indépendante s'il se contente de lire l'explication du premier modèle.
PwC décrit un workflow similaire : des agents réalisent la reconnaissance, des humains valident les recommandations et les approches de collecte d'informations, et le système propose des cibles que les testeurs doivent investiguer.
La recherche de CREST, menée auprès de 62 prestataires de cybersécurité dans 19 pays, a de même constaté que l'usage de l'IA se concentre sur la reconnaissance, l'analyse et le reporting, les humains étant davantage impliqués dans les tests à plus haut risque.
La revue humaine n'aide que lorsque le relecteur dispose des preuves brutes, de l'expertise pertinente, et de suffisamment de temps pour remettre en question la conclusion.
Les données sensibles font partie du modèle de menace
Un pentest peut exposer du code source, de l'architecture, des sessions administrateur, des tokens API, des URL internes, des dossiers clients et des exploits fonctionnels. « Nous n'entraînons pas nos modèles sur vos prompts » ne répond qu'à une partie du risque.
Avant d'accorder un accès à un agent, une équipe de sécurité devrait savoir :
- Si du code brut, du trafic ou des secrets sont envoyés à une API de modèle externe.
- Quels prompts, sorties d'outils et traces sont conservés, et qui peut y accéder.
- Si les secrets sont caviardés avant les appels au modèle et dans les logs.
- Si l'exécution est isolée et les connexions sortantes restreintes.
- Où les données sont traitées, combien de temps elles sont conservées, et comment leur suppression est vérifiée.
Le fournisseur du modèle peut ne rien conserver, tandis qu'un service d'orchestration conserve chaque réponse HTTP. La revue doit donc couvrir l'ensemble du chemin des données, et pas seulement l'API du modèle.
Mesurer le coût par résultat validé
Un effort de reconnaissance réduit ne prouve pas un coût total plus faible pour chaque mission.
Pour évaluer le coût par résultat validé, incluez les frais de plateforme, l'usage du modèle, l'infrastructure, les nouvelles tentatives, le triage, la validation humaine et la gouvernance.
Des mesures utiles incluent le coût par vulnérabilité significative validée, le temps de revue humaine, la surface autorisée testée par version, le taux de candidats rejetés ou déclassés, et le délai entre la remédiation et le retest vérifié.
Pour construire l'argumentaire commercial, comparez un périmètre et une qualité équivalents. Mesurez ensuite si le workflow augmente la fréquence ou la couverture des tests tout en réduisant l'effort d'expert requis pour obtenir des résultats validés.
Un auditeur ou un client accepterait-il le rapport ?
Il n'existe pas de règle d'acceptation universelle pour un « pentest par IA ». L'acceptation dépend des critères d'audit applicables ou du contrat client, et du fait que la mission réponde à leurs exigences de périmètre, méthodologie, qualification des testeurs, indépendance, preuve, revue humaine et responsabilité.
Confirmez ces exigences auprès de l'auditeur ou du client avant le test. L'IA peut réaliser un travail technique substantiel, mais elle ne peut pas déterminer si son propre rapport satisfait ces exigences. L'acceptation propre à un référentiel est une question distincte, qui ne doit pas être déduite de la capacité du modèle.
Alors, peut-on faire confiance à un résultat de pentest par IA ?
Oui, lorsque la preuve peut répondre à six questions :
- La cible était-elle explicitement autorisée, et qu'est-ce qui est resté non testé ?
- Quelles actions ont été exécutées, et qu'a renvoyé la cible ?
- Quel effet observable a prouvé la vulnérabilité ?
- Quels contrôles négatifs et comparatifs ont écarté des explications plus simples ?
- Un autre testeur peut-il reproduire le résultat ?
- Qui a revu la preuve et reste responsable de la conclusion ?
Le cas mobile et l'évaluation GoPhish ont abouti au même point : seules les affirmations étayées par une preuve reproductible sont entrées dans les rapports.
L'IA peut mener l'attaque.
La confiance commence lorsque quelqu'un d'autre peut l'inspecter, la reproduire, et parvenir à la même conclusion.
FAQ
Qu'est-ce que le pentest par IA ?
Le pentest par IA utilise des agents IA, souvent basés sur des modèles de langage, connectés à des outils de sécurité pour investiguer une cible autorisée. Contrairement à un scanner classique, un agent peut choisir le prochain test à partir d'observations précédentes, maintenir des sessions, générer des payloads et valider des hypothèses. Le résultat n'est utile que lorsque la couche de contrôle enregistre le périmètre, les actions, les preuves et les limites.
L'IA peut-elle remplacer les testeurs d'intrusion humains ?
Pas de façon fiable, aujourd'hui, pour une évaluation complète. L'IA peut automatiser la reconnaissance, le test de vulnérabilités connues, la génération de payloads et le retest de correctifs. Les humains restent nécessaires pour comprendre l'intention métier, évaluer un impact ambigu, approuver des actions risquées, examiner les lacunes de couverture, et rester responsables du rapport final. L'IA peut remplacer des tâches individuelles sans remplacer le rôle humain complet.
Le pentest par IA est-il sûr ou digne de confiance ?
Seulement avec des contrôles solides. L'exécution doit rester dans un périmètre autorisé, les actions risquées doivent nécessiter une approbation, les données sensibles doivent être protégées, et des humains doivent valider les vulnérabilités significatives. Les équipes doivent aussi pouvoir inspecter ce qui s'est exécuté, ce qui s'est passé, et ce qui est resté non testé.
Pourquoi les outils de pentest par IA génèrent-ils autant de faux positifs ?
Les outils de pentest par IA peuvent produire des faux positifs lorsqu'ils confondent du code suspect ou des réponses inhabituelles avec une exploitation réussie. Les causes courantes incluent un contexte applicatif manquant, des hypothèses incorrectes sur l'identité ou les prérequis, des redirections interprétées comme une authentification réussie, et un accès d'exécution incomplet. La validation à l'exécution et les vérifications de reproductibilité aident à empêcher des hypothèses non étayées de devenir des vulnérabilités rapportables.
Quelle est la différence entre une IA qui trouve une vulnérabilité et une IA qui la prouve ?
Signaler une vulnérabilité potentielle consiste à identifier une faiblesse plausible, par exemple une URL contrôlée par l'utilisateur atteignant une fonction de requête côté serveur. La prouver exige un test autorisé qui produit un effet observable, préserve la requête et la réponse ou le callback, documente les prérequis, et peut être reproduit de façon indépendante. Une hypothèse ne devient une vulnérabilité confirmée qu'après cette validation.
Le pentest par IA met-il en danger les données sensibles ?
Cela peut arriver. Un pentest par IA peut traiter du code source, des identifiants, du trafic HTTP, des URL internes, des dossiers clients et des exploits fonctionnels. Les équipes devraient vérifier ce qui atteint les API de modèles externes, ce que la plateforme d'orchestration enregistre, qui peut accéder à ces enregistrements, où les données sont stockées, combien de temps elles sont conservées, et comment leur suppression est confirmée.
Un rapport de pentest généré par IA est-il acceptable pour des auditeurs ou des clients ?
Il n'existe pas de réponse universelle. Un rapport assisté par IA n'est acceptable que s'il satisfait les critères d'audit applicables ou les exigences du client. Confirmez à l'avance le périmètre, la méthodologie, la qualification des testeurs, l'indépendance, la divulgation de l'usage de l'IA, la preuve, la revue humaine et la responsabilité. L'IA peut réaliser un travail technique, mais elle ne peut pas déterminer sa propre acceptation.
Que doit rester sous contrôle humain dans un pentest piloté par IA ?
Les humains doivent contrôler le périmètre, les identifiants, la classification des données, les actions interdites, et l'approbation des tests destructeurs ou à impact en production. Ils doivent aussi revoir les vulnérabilités significatives, remettre en question la sévérité et l'impact métier, examiner les zones non testées, et décider de ce qui entre dans le rapport final. C'est la couche d'exécution qui doit imposer ces décisions, plutôt que de s'appuyer uniquement sur des instructions dans un prompt.
Le pentest par IA permet-il vraiment d'économiser de l'argent ?
Parfois. Des économies apparaissent lorsque la réduction du travail répétitif dépasse le coût d'usage de la plateforme, de l'infrastructure, des nouvelles tentatives, du triage, de la validation humaine et de la gouvernance. Comparez le coût complet par résultat validé pour un périmètre et une qualité équivalents, en incluant l'effort consacré à rejeter ou reconstruire des vulnérabilités non étayées.