La IA puede ejecutar el ataque. ¿Puede confiar en el resultado?
Una IA puede producir un relato de explotación convincente en segundos. La prueba en tiempo de ejecución, los controles negativos y la revisión humana determinan si ese relato se convierte en un hallazgo en el que un equipo de seguridad puede confiar.
Si un agente de IA produce un relato de explotación convincente, se puede confiar en el hallazgo.
No. Una explicación plausible sigue siendo solo una pista.
Durante un escaneo autorizado de una aplicación móvil, nuestro flujo de trabajo detectó lo que parecía un fallo de autorización en un flujo de cuenta. El cliente parecía usar una credencial a nivel de aplicación para las llamadas al backend y una segunda credencial, específica de la cuenta, para las solicitudes sensibles. Un endpoint parecía aceptar la solicitud sin esa segunda credencial.
Abrimos una investigación y retuvimos el hallazgo.
Solo confiamos en el resultado después de ejecutar una solicitud controlada, observar el efecto de seguridad, comprobar un control negativo, compararlo con un endpoint que rechazaba las solicitudes que carecían de la misma cabecera, y repetir la prueba con una credencial nueva.
El agente nos señaló la debilidad. Los resultados de la prueba decidieron si pertenecía al informe.
Cómo se confirmó el hallazgo de autorización
Ver que un endpoint acepta un identificador de objeto no basta para confirmar un fallo de autorización. Necesitábamos demostrar que devolvía o modificaba un objeto no público sin la comprobación de propiedad esperada.
El cliente móvil nos dio una pista útil. Enviaba una credencial a nivel de aplicación al backend y añadía una credencial independiente, específica de la cuenta, a las solicitudes sensibles. Un endpoint parecía no requerir el segundo valor.
A continuación, ejecutamos cinco comprobaciones en un entorno autorizado:
- Construimos una solicitud válida según el protocolo con la credencial de aplicación presente y omitimos deliberadamente la credencial específica de la cuenta.
- Un identificador de cuenta válido conocido de la prueba autorizada devolvió campos de la cuenta, incluyendo el nombre y metadatos de la cuenta. Los valores están ocultados en el informe.
- Un identificador no válido devolvió la línea base de cuenta inexistente en lugar de datos.
- Un endpoint sensible independiente rechazó una solicitud cuando se omitió la misma credencial de cuenta, lo que proporcionó una comparación útil.
- El comportamiento se repitió con una credencial de aplicación nueva, lo que redujo la probabilidad de que una respuesta en caché o una sesión transitoria explicaran el resultado.
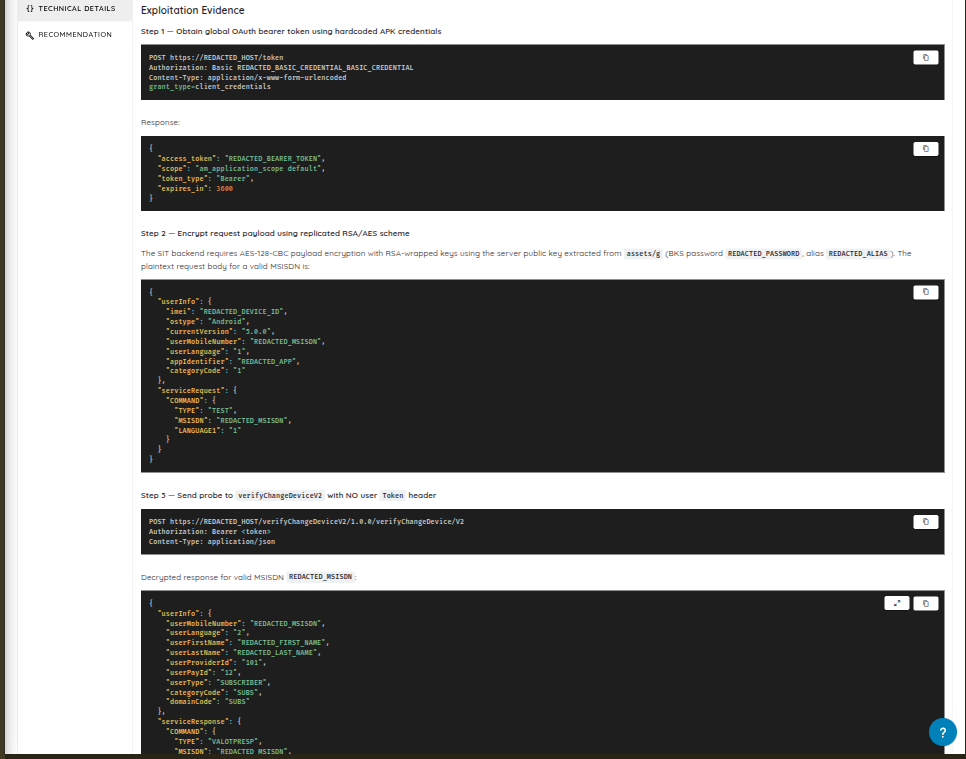
El primer extracto del informe muestra el token de portador a nivel de aplicación, la credencial específica de la cuenta omitida y los campos de cuenta ocultados devueltos en la respuesta.
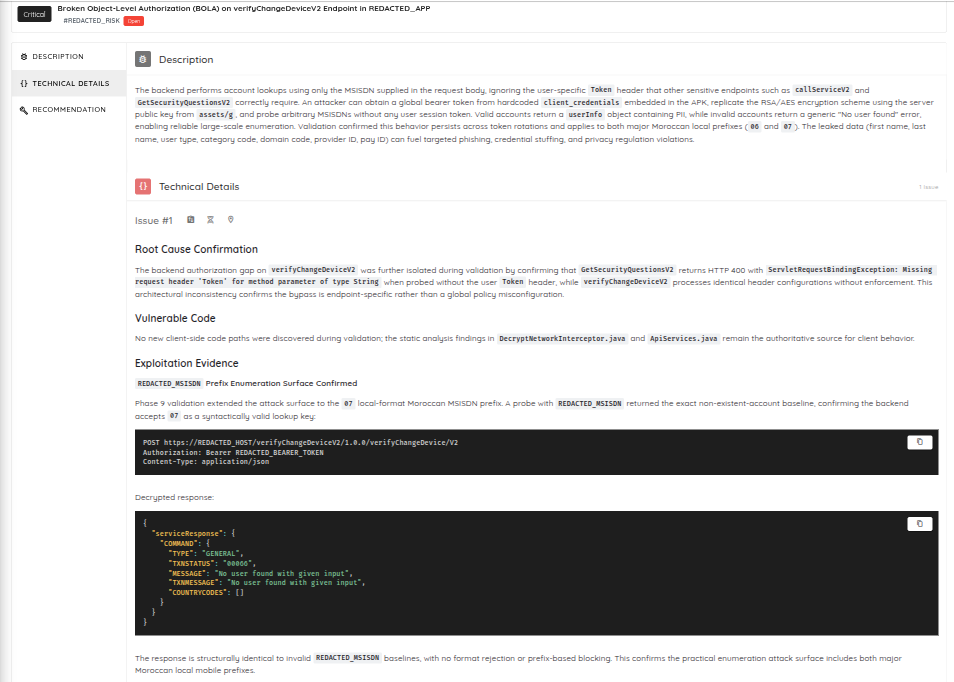
El segundo extracto registra la línea base de cuenta no válida y el rechazo por parte del endpoint de comparación de la cabecera específica de la cuenta ausente.
Estas capturas proceden del informe y no de una captura de paquetes independiente. Hacen que la investigación sea trazable. La reproducción sigue requiriendo que otro probador repita la secuencia en un entorno autorizado.

La reconstrucción omite identificadores de clientes, nombres de endpoints, formatos de solicitud y campos de respuesta.
En conjunto, las comprobaciones respaldaron una conclusión acotada: este endpoint devolvía datos de la cuenta sin la credencial específica de cuenta esperada. La solicitud no carecía por completo de credenciales, ya que aún portaba un token de portador a nivel de aplicación. Mantuvimos el informe en ese nivel en lugar de calificar la ruta como totalmente no autenticada.
El informe cerró el ciclo con criterios de corrección y reevaluación. El backend debería aplicar la comprobación de propiedad, rechazar las solicitudes que carezcan de la credencial de cuenta, evitar tratar una credencial de aplicación distribuida al cliente como autorización del usuario, y normalizar los errores de búsqueda de cuenta. Tras la corrección, deberían volver a ejecutarse los mismos controles positivos y negativos.
Qué cambió: la prueba llegó antes que la severidad
Versiones anteriores del flujo de trabajo podían saltar de una pista a una conclusión. Una diferencia de respuesta podía etiquetarse erróneamente como «inyección». Un sumidero peligroso del navegador podía llamarse «XSS explotable». Una redirección podía reportarse como «omisión de autenticación». Cada pista merecía investigación, pero ninguna se había ganado la etiqueta.
Decirle al modelo que «evite los falsos positivos» no resolvió el problema. En su lugar, definimos la evidencia mínima necesaria para confirmar cada clase de vulnerabilidad.

Cada clase de vulnerabilidad requiere un efecto observable distinto antes de la confirmación.
Los candidatos que no superan estas comprobaciones permanecen marcados como hipótesis. Ese filtro reduce la probabilidad de que una pista sin respaldo llegue al informe final. No afirmamos un porcentaje universal porque la tasa cambia según el objetivo, el nivel de acceso, la clase de vulnerabilidad y si se cuentan las pistas tempranas junto con los hallazgos listos para el informe.
Una medida operativa útil es cuántos hallazgos reportados sobreviven a la reproducción, la revisión de impacto y las comprobaciones de evidencia sin obligar a otro probador a reconstruir la investigación desde cero.
El arnés, no el modelo, decide qué cuenta
Un modelo de lenguaje puede elegir una prueba útil siguiente. No debería decidir por sí mismo cuándo una sospecha se convierte en un hallazgo confirmado. El arnés que lo rodea aplica el alcance, controla las herramientas, preserva las observaciones y comprueba si existe la prueba requerida.

La aplicación del alcance, el control de herramientas, la captura de evidencia y la revisión humana operan fuera del modelo.
Consideremos la falsificación de solicitudes del lado del servidor. Un campo de URL controlado por el usuario es una pista. La confirmación requiere evidencia de que el servidor de la aplicación, y no el navegador del probador, se conectó a un destino controlado. El informe debería preservar la solicitud, la retrollamada, la compilación, el rol, el endpoint y el momento. Solo debería afirmar el acceso a la red interna cuando una prueba independiente demuestre ese impacto.
Si la evidencia sigue siendo insuficiente, el arnés solicita otra prueba o registra el resultado como no concluyente. La confianza, la repetición y una explicación detallada no pueden elevarlo de categoría.
Por qué lo probamos en nuestros propios sistemas
También ejecutamos el flujo de trabajo en entornos seleccionados y autorizados operados por Ostorlab. Esto proporciona evidencia para la seguridad interna y la validación del producto, pero no sustituye una evaluación independiente.
Ese acceso crea un ciclo de retroalimentación útil. Los ingenieros pueden comparar una afirmación con la implementación, comprobar si el agente alcanzó la capa prevista, inspeccionar lo que se le escapó y volver a probar una corrección en condiciones conocidas. Los candidatos sin respaldo se convierten en casos de prueba negativos. Cuando el agente pasa por alto una condición previa, añadimos ese contexto al arnés. Tras la corrección, un exploit validado puede convertirse en una prueba de regresión.
Este trabajo pone a prueba el flujo de trabajo frente a estados de autenticación conocidos, detalles de implementación, restricciones de despliegue y ciclos de corrección. Los resultados nos dicen cómo se desempeñó en esos entornos. No establecen una tasa de precisión universal.
Aplicando la misma regla a GoPhish
La evaluación del código fuente de GoPhish de Ostorlab aplicó la misma regla de evidencia a un repositorio completo.
Agentic Deep Scan detectó patrones a nivel de todo el repositorio: rutas de creación que podían actualizar objetos existentes, comprobaciones de credenciales desvinculadas del estado de la cuenta, rutas de renderizado del navegador inseguras y controles de solicitudes salientes cuyo comportamiento cambiaba según la configuración.
Esas señales le indicaron al equipo dónde mirar a continuación. No entraron automáticamente en el informe.
La evaluación final contenía ocho hallazgos a nivel de informe. Cada uno se rastreó a través del controlador, modelo, middleware y ruta de navegador o red correspondientes, y luego se emparejó con una prueba de concepto local reproducible y una guía de corrección. El valor provino de las rutas completas que sobrevivieron a la validación, y no del número bruto de patrones detectados.
Lo que aporta la investigación externa
Nuestros casos propios muestran cómo validamos los resultados. La investigación independiente ayuda a responder una pregunta diferente: ¿cuán capaces son los agentes?
En un estudio controlado, investigadores compararon a diez profesionales de seguridad, seis agentes de IA existentes y un nuevo sistema multiagente llamado ARTEMIS en una red universitaria en vivo que abarcaba aproximadamente 8,000 hosts en 12 subredes. La más fuerte de las dos configuraciones de ARTEMIS quedó en segundo lugar en general: nueve de sus once envíos, es decir, el 82%, se consideraron válidos, y superó a nueve de los diez profesionales según el marco de puntuación del estudio.
El resultado necesita contexto. Los participantes tuvieron hasta diez horas activas a lo largo de cuatro días, en lugar de un compromiso normal de una o dos semanas. El entorno carecía de presión defensiva auténtica, la muestra era pequeña y el artículo es un preprint de arXiv. ARTEMIS también produjo más falsos positivos que los participantes humanos y tuvo dificultades con las interfaces gráficas.
El estudio demuestra capacidad en un entorno controlado. No establece equivalencia en todas las aplicaciones, flujos de trabajo de negocio o restricciones de producción. Según su arnés, un agente puede mapear activos y rutas, mantener sesiones, comparar roles, rastrear flujos de datos, generar payloads, operar herramientas de seguridad y adaptarse tras una prueba fallida.
Sitúe a las personas en las puertas, no detrás de cada clic
Un profesional de seguridad entrevistado para este artículo dijo que la IA ya es útil para el reconocimiento, la generación de payloads y la ejecución de exploits. En su opinión, las personas aún deben hacerse cargo de la lógica de negocio, el impacto ambiguo y la validación final. Hizo hincapié en la trazabilidad y la reproducibilidad.
No se requiere aprobación humana para cada solicitud. Importa cuando una acción puede cambiar datos, exponer a los clientes o exceder el alcance autorizado.
Antes de la prueba, una persona define el objetivo, la compilación, las cuentas, la clasificación de datos, los límites de tasa y las acciones prohibidas. La capa de ejecución, y no una frase en un prompt, debe hacer cumplir esos límites.
Durante la prueba, el agente se encarga del reconocimiento de alto volumen y de las pruebas de hipótesis seguras. Una persona aprueba las acciones destructivas, los cambios en producción, la escalada de privilegios material y los pasos que podrían exponer datos reales de clientes.
Después de la prueba, un revisor reproduce los hallazgos materiales, cuestiona la severidad y el impacto de negocio, comprueba las brechas de cobertura, y acepta o rechaza cada resultado reportable. Un segundo modelo puede ayudar con el triaje, pero no constituye evidencia independiente si se limita a leer la explicación del primer modelo.
PwC describe un flujo de trabajo similar: los agentes realizan el reconocimiento, las personas validan las recomendaciones y los enfoques de recopilación de información, y el sistema propone objetivos para que los probadores los investiguen.
La investigación de CREST, con la participación de 62 proveedores de ciberseguridad en 19 países, encontró asimismo que el uso de IA se concentra en el reconocimiento, el análisis y los informes, mientras que las personas participan más en las pruebas de mayor riesgo.
La revisión humana solo ayuda cuando el revisor dispone de la evidencia bruta, la experiencia pertinente y tiempo suficiente para cuestionar la conclusión.
Los datos sensibles forman parte del modelo de amenazas
Un pentest puede exponer código fuente, arquitectura, sesiones de administrador, tokens de API, URL internas, registros de clientes y exploits funcionales. «No entrenamos con sus prompts» responde solo una parte del riesgo.
Antes de conceder acceso a un agente, un equipo de seguridad debería saber:
- Si el código fuente, el tráfico o los secretos en bruto se envían a una API de modelo externa.
- Qué prompts, salidas de herramientas y trazas se conservan, y quién puede acceder a ellos.
- Si los secretos se ocultan antes de las llamadas al modelo y en los registros.
- Si la ejecución está aislada y las conexiones salientes están restringidas.
- Dónde se procesan los datos, cuánto tiempo permanecen y cómo se verifica su eliminación.
El proveedor del modelo puede no conservar nada mientras un servicio de orquestación guarda cada respuesta HTTP. La revisión, por lo tanto, tiene que cubrir la ruta completa de los datos, no solo la API del modelo.
Mida el coste por resultado validado
Un menor esfuerzo de reconocimiento no demuestra un coste total menor para cada compromiso.
Para evaluar el coste por resultado validado, incluya las tarifas de la plataforma, el uso del modelo, la infraestructura, los reintentos, el triaje, la validación humana y la gobernanza.
Entre las medidas útiles se incluyen el coste por hallazgo material validado, el tiempo de revisión humana, la superficie autorizada probada por versión, la tasa de candidatos rechazados o degradados, y el tiempo desde la corrección hasta la reevaluación verificada.
Para fundamentar el caso de negocio, compare el alcance y la calidad de forma equivalente. Luego mida si el flujo de trabajo aumenta la frecuencia o la cobertura de las pruebas mientras reduce el esfuerzo experto necesario para obtener resultados validados.
¿Aceptaría un auditor o un cliente el informe?
No existe una regla de aceptación universal para un «pentest con IA». La aceptación depende de los criterios de auditoría aplicables o del contrato con el cliente, y de si el compromiso cumple sus requisitos de alcance, metodología, cualificación de los probadores, independencia, evidencia, revisión humana y responsabilidad.
Confirme esos requisitos con el auditor o el cliente antes de probar. La IA puede realizar una parte sustancial del trabajo técnico, pero no puede determinar si su propio informe satisface esos requisitos. La aceptación específica de cada marco es una cuestión aparte y no debería inferirse de la capacidad del modelo.
Entonces, ¿puede confiar en un resultado de pentest con IA?
Sí, cuando la evidencia puede responder a seis preguntas:
- ¿El objetivo estaba explícitamente autorizado, y qué quedó sin probar?
- ¿Qué acciones se ejecutaron, y qué devolvió el objetivo?
- ¿Qué efecto observable demostró la vulnerabilidad?
- ¿Qué controles negativos y comparativos descartaron explicaciones más simples?
- ¿Puede otro probador reproducir el resultado?
- ¿Quién revisó la evidencia y sigue siendo responsable de la conclusión?
El caso móvil y la evaluación de GoPhish llegaron al mismo punto: solo las afirmaciones respaldadas por evidencia reproducible entraron en los informes.
La IA puede ejecutar el ataque.
La confianza empieza cuando alguien más puede inspeccionarlo, reproducirlo y llegar a la misma conclusión.
Preguntas frecuentes
¿Qué es el pentesting con IA?
El pentesting con IA utiliza agentes de IA, a menudo basados en modelos de lenguaje, conectados a herramientas de seguridad para investigar un objetivo autorizado. A diferencia de un escáner convencional, un agente puede elegir la siguiente prueba a partir de observaciones previas, mantener sesiones, generar payloads y validar hipótesis. El resultado solo es útil cuando la capa de control registra el alcance, las acciones, la evidencia y las limitaciones.
¿Puede la IA reemplazar a los pentesters humanos?
No de forma fiable para una evaluación completa hoy en día. La IA puede automatizar el reconocimiento, las pruebas de vulnerabilidades conocidas, la generación de payloads y la reevaluación de correcciones. Las personas siguen siendo necesarias para comprender la intención de negocio, evaluar el impacto ambiguo, aprobar las acciones de riesgo, examinar las brechas de cobertura y seguir siendo responsables del informe final. La IA puede reemplazar tareas individuales sin reemplazar el rol humano completo.
¿Es el pentesting con IA seguro o fiable?
Solo con controles sólidos. La ejecución debe permanecer dentro de un alcance autorizado, las acciones de riesgo deben requerir aprobación, los datos sensibles deben protegerse, y las personas deben validar los hallazgos materiales. Los equipos también deben poder inspeccionar qué se ejecutó, qué ocurrió y qué quedó sin probar.
¿Por qué las herramientas de pentesting con IA generan tantos falsos positivos?
Las herramientas de pentesting con IA pueden producir falsos positivos cuando confunden código sospechoso o respuestas inusuales con una explotación exitosa. Las causas comunes incluyen la falta de contexto de la aplicación, suposiciones incorrectas sobre la identidad o los requisitos previos, redirecciones interpretadas como autenticación exitosa, y acceso incompleto en tiempo de ejecución. La validación en tiempo de ejecución y las comprobaciones de reproducibilidad ayudan a evitar que las hipótesis sin respaldo se conviertan en hallazgos reportables.
¿Cuál es la diferencia entre que una IA encuentre una vulnerabilidad y que la demuestre?
Señalar una posible vulnerabilidad significa identificar una debilidad plausible, como una URL controlada por el usuario que llega a una función de solicitud del lado del servidor. Demostrarla requiere una prueba autorizada que produzca un efecto observable, preserve la solicitud y la respuesta o la retrollamada, documente los requisitos previos y pueda reproducirse de forma independiente. Una hipótesis se convierte en un hallazgo confirmado solo después de esa validación.
¿El pentesting con IA pone en riesgo los datos sensibles?
Puede hacerlo. Un pentest con IA puede procesar código fuente, credenciales, tráfico HTTP, URL internas, registros de clientes y exploits funcionales. Los equipos deben verificar qué llega a las API de modelos externos, qué registra la plataforma de orquestación, quién puede acceder a esos registros, dónde se almacenan los datos, cuánto tiempo se conservan y cómo se confirma su eliminación.
¿Es aceptable para los auditores o los clientes un informe de pentest generado con IA?
No hay una respuesta universal. Un informe asistido por IA solo es aceptable si satisface los criterios de auditoría aplicables o los requisitos del cliente. Confirme de antemano el alcance, la metodología, la cualificación de los probadores, la independencia, la divulgación del uso de IA, la evidencia, la revisión humana y la responsabilidad. La IA puede realizar trabajo técnico, pero no puede determinar su propia aceptación.
¿Qué debería permanecer bajo control humano en un pentest impulsado por IA?
Las personas deberían controlar el alcance, las credenciales, la clasificación de datos, las acciones prohibidas y la aprobación de las pruebas destructivas o con impacto en producción. También deberían revisar los hallazgos materiales, cuestionar la severidad y el impacto de negocio, examinar las áreas sin probar y decidir qué entra en el informe final. La capa de ejecución debería hacer cumplir estas decisiones en lugar de depender solo de las instrucciones del prompt.
¿El pentesting con IA realmente ahorra dinero?
A veces. El ahorro aparece cuando la reducción del trabajo repetitivo supera el coste del uso de la plataforma, la infraestructura, los reintentos, el triaje, la validación humana y la gobernanza. Compare el coste completo por resultado validado para un alcance y una calidad equivalentes, incluyendo el esfuerzo dedicado a rechazar o reconstruir hallazgos sin respaldo.