AIは攻撃を実行できる。その結果を信頼できるか
AIは数秒で説得力のあるエクスプロイトのストーリーを作り出せます。そのストーリーがセキュリティチームの信頼できる検出結果になるかどうかは、実行時の実証、ネガティブコントロール、そして人間によるレビューが決めます。
AIエージェントが説得力のあるエクスプロイトの物語を作り出したなら、その検出結果は信頼できる。
いいえ。もっともらしい説明は、依然として手がかりにすぎません。
ある認可されたモバイルアプリケーションのスキャンの際、当社のワークフローは、アカウント処理のフローに認可の失敗と見られるものを浮かび上がらせました。クライアントは、バックエンド呼び出しにアプリケーションレベルの認証情報を使い、機密性の高いリクエストには2つ目のアカウント固有の認証情報を使っているように見えました。あるエンドポイントは、その2つ目の認証情報なしでリクエストを受け付けているようでした。
当社は調査に着手し、検出結果の報告を保留しました。
当社がこの結果を信頼したのは、制御されたリクエストを実行し、セキュリティ上の効果を観測し、ネガティブコントロールを確認し、同じヘッダーを欠いたリクエストを拒否するエンドポイントと比較し、新しい認証情報でテストを繰り返した後のことでした。
エージェントは弱点の方向を指し示しました。それがレポートに載るべきかどうかを決めたのは、テストの結果でした。
認可の検出結果はどのように確定されたか
エンドポイントがオブジェクト識別子を受け付けるのを見ただけでは、認可の不備を確定するには不十分です。当社は、想定される所有権チェックを経ずに、非公開のオブジェクトが返されたり変更されたりすることを示す必要がありました。
モバイルクライアントは、有用な手がかりを与えてくれました。それはアプリケーションレベルの認証情報をバックエンドに送り、機密性の高いリクエストには別のアカウント固有の認証情報を追加していました。あるエンドポイントは、2つ目の値を要求していないように見えました。
そこで当社は、認可された環境で5つのチェックを実行しました。
- アプリケーション認証情報を含み、アカウント固有の認証情報を意図的に省いた、プロトコル上妥当なリクエストを作成しました。
- 認可されたテストから得た既知の有効なアカウント識別子を使うと、名前やアカウントのメタデータを含むアカウントのフィールドが返されました。それらの値はレポートでは伏字にしてあります。
- 無効な識別子を使うと、データではなく「存在しないアカウント」のベースラインが返されました。
- 別の機密性の高いエンドポイントは、同じアカウント認証情報を省いたリクエストを拒否し、有用な比較対象となりました。
- 新しいアプリケーション認証情報でも同じ挙動が再現され、キャッシュされたレスポンスや一時的なセッションがこの結果を説明する可能性を低減しました。
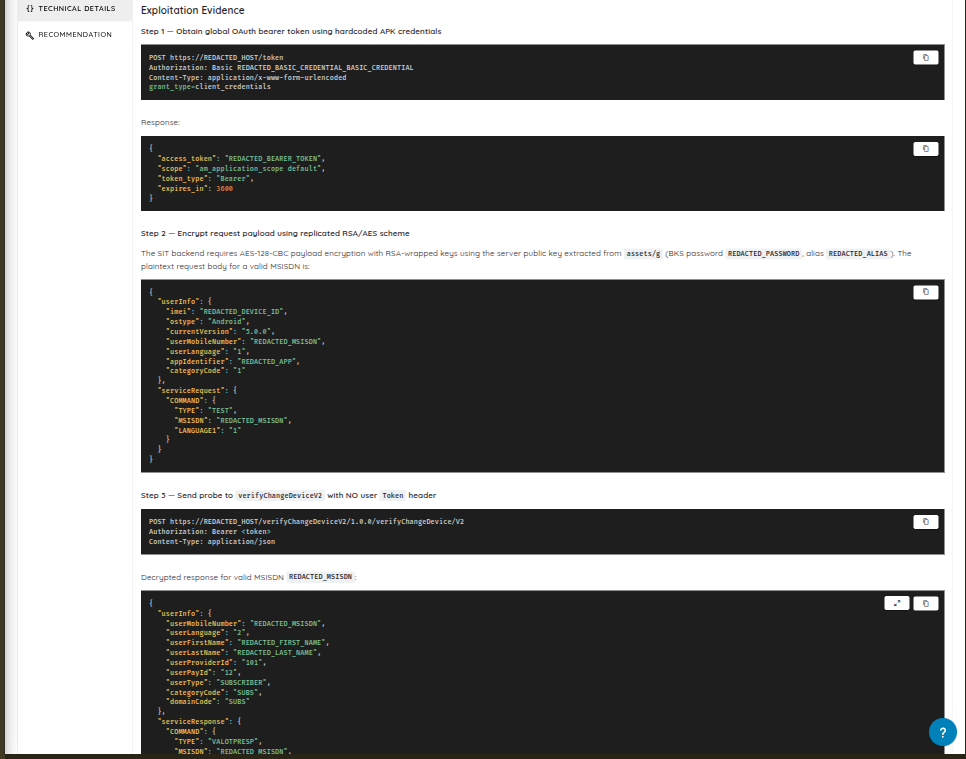
レポートの最初の抜粋は、アプリケーションレベルのベアラー、省略されたアカウント固有の認証情報、そしてレスポンスで返された伏字化したアカウントのフィールドを示しています。
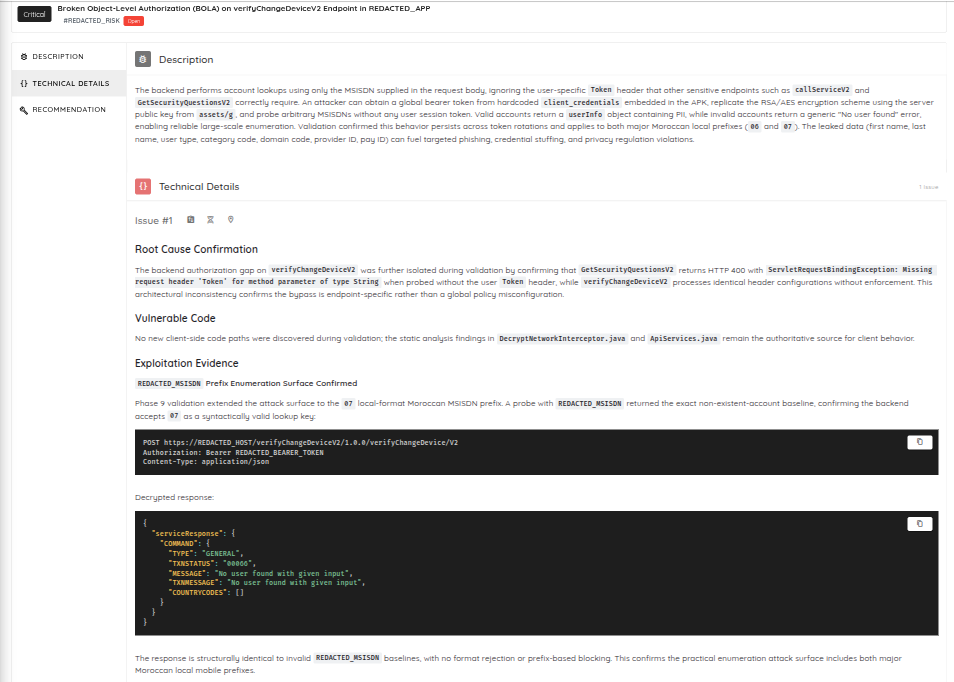
2つ目の抜粋は、無効なアカウントのベースラインと、比較対象のエンドポイントがアカウント固有のヘッダーの欠如を理由にリクエストを拒否したことを記録しています。
これらのスクリーンショットは、独立したパケットキャプチャではなくレポートから取得したものです。これらは調査を追跡可能にします。再現には、別のテスターが認可された環境でこの一連の手順を再実行することが依然として必要です。

この再構成では、顧客の識別子、エンドポイント名、リクエストの形式、レスポンスのフィールドを省いています。
これらのチェックを総合すると、限定的な結論が裏付けられました。すなわち、このエンドポイントは、想定されるアカウント固有の認証情報なしでアカウントデータを返した、ということです。このリクエストは依然としてアプリケーションレベルのベアラートークンを含んでいたため、認証情報が一切ない状態ではありませんでした。当社は、この経路を完全に未認証と呼ぶのではなく、そのレベルにとどめてレポートに記載しました。
レポートは、修復と再テストの基準をもって一連の流れを締めくくりました。バックエンドは所有権を強制し、アカウント認証情報を欠いたリクエストを拒否し、クライアントに配布されるアプリケーション認証情報をユーザー認可として扱わないようにし、アカウント検索のエラーを正規化すべきです。修正後は、同じポジティブコントロールとネガティブコントロールを再度実行すべきです。
何が変わったか:重大度の前に実証を
初期のバージョンのワークフローは、手がかりから結論へと飛躍することがありました。レスポンスの差異を誤って「インジェクション」とラベル付けしたり、危険なブラウザーのシンクを「悪用可能なXSS」と呼んだり、リダイレクトを「認証バイパス」として報告したりすることがありました。どの手がかりも調査に値しましたが、どれもそのラベルを得てはいませんでした。
モデルに「誤検知を避けよ」と指示しても、問題は解決しませんでした。代わりに当社は、各脆弱性クラスを確定するために必要となる最小限のエビデンスを定義しました。

各脆弱性クラスは、確定の前にそれぞれ異なる観測可能な効果を必要とします。
これらのチェックに通らなかった候補は、仮説のままとされます。このフィルターによって、裏付けのない手がかりが最終レポートに到達する可能性が低減します。当社は普遍的な割合を主張しません。その割合は、対象、アクセスレベル、脆弱性クラス、そして初期の手がかりをレポートに載せられる検出結果と並べて数えるかどうかによって変わるからです。
有用な運用上の尺度は、別のテスターが調査を一から再構成せずとも、報告された検出結果のうちどれだけが再現、影響レビュー、エビデンスチェックを通過して残るか、というものです。
何がカウントされるかを決めるのは、モデルではなくハーネスである
言語モデルは、有用な次のテストを選ぶことはできます。しかし、疑いがいつ確定した検出結果になるかを、それ自身で決めるべきではありません。周囲を取り囲むハーネスが、スコープを強制し、ツールを制御し、観測結果を保存し、必要な実証が存在するかどうかを確認します。

スコープの強制、ツールの制御、エビデンスの取得、人間によるレビューは、モデルの外側で行われます。
サーバーサイドリクエストフォージェリを考えてみましょう。ユーザーが制御できるURLフィールドは手がかりです。確定には、テスターのブラウザーではなくアプリケーションサーバーが、制御された宛先に接続したというエビデンスが必要です。レポートは、リクエスト、コールバック、ビルド、ロール、エンドポイント、時刻を保存すべきです。内部ネットワークへのアクセスを主張できるのは、別のテストがその影響を実証した場合に限られます。
エビデンスが依然として不十分な場合、ハーネスは別のテストを要求するか、その結果を結論不能として記録します。自信、繰り返し、詳細な説明があっても、それを格上げすることはできません。
なぜ自社のシステムでテストするのか
当社は、Ostorlabが運用する選定された認可環境でも、このワークフローを実行しています。これは内部のセキュリティと製品の検証のためのエビデンスを提供しますが、独立した評価の代わりにはなりません。
このアクセスは、有用なフィードバックループを生み出します。エンジニアは、主張を実装と比較し、エージェントが意図したレイヤーに到達したかどうかを確認し、見逃したものを調べ、既知の条件下で修正を再テストできます。裏付けのない候補はネガティブテストケースになります。エージェントが前提条件を見逃した場合、当社はそのコンテキストをハーネスに追加します。修復後は、検証済みのエクスプロイトがリグレッションテストになり得ます。
この作業は、既知の認証状態、実装の詳細、デプロイの制約、修復サイクルに対してワークフローをテストします。その結果は、こうした環境でワークフローがどのように機能したかを教えてくれます。普遍的な精度を確立するものではありません。
同じルールをGoPhishに適用する
OstorlabによるGoPhishのソースコード評価は、同じエビデンスのルールをリポジトリ全体に適用しました。
Agentic Deep Scanは、リポジトリ全体にわたるパターンを浮かび上がらせました。既存のオブジェクトを更新しうる作成経路、アカウントの状態から切り離された認証情報のチェック、安全でないブラウザーレンダリングの経路、そして設定によって挙動が変わるアウトバウンドリクエストの制御です。
これらのシグナルは、次にどこを見るべきかをチームに伝えました。自動的にレポートに入ったわけではありません。
最終的な評価には、レポートレベルの検出結果が8件含まれていました。それぞれが、関連するハンドラー、モデル、ミドルウェア、そしてブラウザーまたはネットワークの経路にわたって追跡され、再現可能なローカルの概念実証(PoC)と修復ガイダンスが付けられました。価値は、検出されたパターンの素の数ではなく、検証を通過した完全な経路から生まれました。
外部の研究が加えるもの
当社の自社事例は、当社がどのように結果を検証するかを示しています。独立した研究は、別の問いに答える助けになります。すなわち、エージェントはどれほど有能なのか、という問いです。
ある制御された研究では、研究者たちが、12のサブネットにまたがる約8,000台のホストから成る実稼働の大学ネットワーク上で、10人のセキュリティ専門家、6つの既存のAIエージェント、そしてARTEMISと呼ばれる新しいマルチエージェントシステムを比較しました。2つのARTEMIS構成のうち強い方は、総合で2位につけました。その11件の提出のうち9件、つまり82%が有効と判定され、この研究のスコアリングフレームワークのもとで、10人の専門家のうち9人を上回る得点を挙げました。
この結果には文脈が必要です。参加者には、通常の1〜2週間の作業ではなく、4日間で最大10時間の実作業時間が与えられていました。環境には本物の防御的な圧力がなく、サンプルは小規模で、論文はarXivのプレプリントです。また、ARTEMISは人間の参加者よりも多くの誤検知を生み出し、グラフィカルインターフェースに苦戦しました。
この研究は、一つの制御された環境における能力を実証しています。あらゆるアプリケーション、ビジネスワークフロー、本番環境の制約にわたる同等性を確立するものではありません。そのハーネス次第で、エージェントはアセットやルートをマッピングし、セッションを維持し、ロールを比較し、データフローを追跡し、ペイロードを生成し、セキュリティツールを操作し、失敗したテストの後に適応することができます。
人間をすべてのクリックの後ろではなく、ゲートに配置する
本記事のために取材したあるセキュリティ実務者は、AIはすでに偵察、ペイロード生成、エクスプロイトの実行に有用だと述べました。その見解では、ビジネスロジック、曖昧な影響、そして最終的な検証は、依然として人間が担うべきです。その実務者は、追跡可能性と再現性を強調しました。
人間による承認は、すべてのリクエストに必要なわけではありません。それが重要になるのは、ある操作がデータを変更しうる、顧客を露出させうる、あるいは認可されたスコープを超えうる場合です。
テストの前には、人間が対象、ビルド、アカウント、データの分類、レート制限、禁止される操作を定義します。プロンプト中の一文ではなく、実行レイヤーがこれらの制限を強制しなければなりません。
テストの最中には、エージェントが大量の偵察と安全な仮説検証を担います。人間は、破壊的な操作、本番環境の変更、重大な権限昇格、そして実際の顧客データを露出させうる手順を承認します。
テストの後には、レビュー担当者が重要な検出結果を再現し、重大度とビジネスへの影響に異議を唱え、カバレッジのギャップを確認し、報告対象となる各結果を受け入れるか棄却します。2つ目のモデルがトリアージを支援することはできますが、最初のモデルの説明を読むだけであれば、独立したエビデンスにはなりません。
PwCは同様のワークフローを説明しています。エージェントが偵察を行い、人間が推奨事項と情報収集の手法を検証し、システムがテスター向けに調査すべき対象を提案する、というものです。
19か国62社のサイバーセキュリティプロバイダーを対象としたCRESTの研究も同様に、AIの利用が偵察、分析、レポート作成に集中しており、よりリスクの高いテストには人間がより深く関与していることを明らかにしました。
人間によるレビューが役立つのは、レビュー担当者が素のエビデンス、関連する専門知識、そして結論に異議を唱えるのに十分な時間を持っている場合に限られます。
機密データは脅威モデルの一部である
ペンテストは、ソースコード、アーキテクチャ、管理者セッション、APIトークン、内部URL、顧客記録、そして動作するエクスプロイトを露出させる可能性があります。「当社は貴社のプロンプトで学習しません」というのは、リスクの一部にしか答えていません。
エージェントにアクセスを許可する前に、セキュリティチームは次のことを把握すべきです。
- 素のコード、トラフィック、シークレットが外部のモデルAPIに送られるかどうか。
- どのプロンプト、ツールの出力、トレースが保持され、誰がそれらにアクセスできるのか。
- モデル呼び出しとログの前にシークレットが伏字化されるかどうか。
- 実行が隔離され、アウトバウンド接続が制限されているかどうか。
- データがどこで処理され、どれだけの期間残り、削除がどのように検証されるのか。
モデルのプロバイダーは何も保持しない一方で、オーケストレーションサービスがすべてのHTTPレスポンスを保持している、ということもあり得ます。したがってレビューは、モデルAPIだけでなく、データの経路全体をカバーしなければなりません。
検証済みの結果あたりのコストを計測する
偵察の工数が減ったからといって、あらゆる作業で総コストが下がると証明されるわけではありません。
検証済みの結果あたりのコストを評価するには、プラットフォーム利用料、モデルの利用、インフラ、再試行、トリアージ、人間による検証、ガバナンスを含めてください。
有用な尺度には、検証済みの重要な検出結果あたりのコスト、人間によるレビュー時間、リリースごとにテストした認可済みの対象範囲、棄却または格下げされた候補の割合、修復から検証済みの再テストまでの時間などがあります。
ビジネス上の妥当性を示すには、同等のスコープと品質で比較してください。そのうえで、検証済みの結果に必要な専門家の工数を減らしつつ、ワークフローがテストの頻度やカバレッジを高めるかどうかを計測してください。
監査人や顧客はそのレポートを受け入れるか
「AIペンテスト」に普遍的な受け入れのルールはありません。受け入れられるかどうかは、適用される監査基準や顧客との契約、そしてその作業がスコープ、方法論、テスターの適格性、独立性、エビデンス、人間によるレビュー、説明責任についての要件を満たすかどうかに依存します。
テストの前に、監査人または顧客とこれらの要件を確認してください。AIは実質的な技術的作業を実行できますが、自らのレポートがこれらの要件を満たすかどうかを判断することはできません。フレームワーク固有の受け入れは別個の問題であり、モデルの能力から推論すべきではありません。
では、AIペンテストの結果を信頼できるのか
はい、エビデンスが6つの問いに答えられる場合には。
- 対象は明示的に認可されていたか、そして何がテストされないまま残ったか。
- どの操作が実行され、対象は何を返したか。
- どのような観測可能な効果が脆弱性を実証したか。
- より単純な説明を排除したのは、どのネガティブコントロールと比較コントロールか。
- 別のテスターがその結果を再現できるか。
- 誰がエビデンスをレビューし、その結論について説明責任を負い続けるのか。
モバイルの事例とGoPhishの評価は、同じ地点に至りました。すなわち、再現可能なエビデンスに裏付けられた主張だけがレポートに入った、ということです。
AIは攻撃を実行できます。
信頼は、他の誰かがそれを検査し、再現し、同じ結論に至ることができたときに始まります。
FAQ
AIペンテストとは何か
AIペンテストは、多くの場合言語モデルに基づくAIエージェントをセキュリティツールに接続し、認可された対象を調査するものです。従来のスキャナーとは異なり、エージェントは過去の観測結果から次のテストを選び、セッションを維持し、ペイロードを生成し、仮説を検証できます。その結果が有用になるのは、制御レイヤーがスコープ、操作、エビデンス、制約を記録している場合に限られます。
AIは人間のペネトレーションテスターを置き換えられるか
今日のところ、完全な評価については確実には置き換えられません。AIは、偵察、既知の脆弱性のテスト、ペイロード生成、修正の再テストを自動化できます。ビジネス上の意図を理解し、曖昧な影響を評価し、リスクのある操作を承認し、カバレッジのギャップを精査し、最終的なレポートについて説明責任を負い続けるには、依然として人間が必要です。AIは、人間の役割全体を置き換えることなく、個々のタスクを置き換えることはあり得ます。
AIペンテストは安全で信頼できるか
強力な制御があって初めて、そう言えます。実行は認可されたスコープの範囲内にとどめ、リスクのある操作には承認を要し、機密データを保護し、重要な検出結果は人間が検証すべきです。チームはまた、何が実行され、何が起き、何がテストされないまま残ったかを検査できなければなりません。
なぜAIペンテストツールはこれほど多くの誤検知を生み出すのか
AIペンテストツールは、疑わしいコードや異常なレスポンスを悪用の成功と取り違えると、誤検知を生み出すことがあります。よくある原因には、アプリケーションのコンテキストの欠如、アイデンティティや前提条件についての誤った想定、認証の成功と解釈されたリダイレクト、不完全な実行時アクセスなどがあります。実行時の検証と再現性のチェックは、裏付けのない仮説が報告対象の検出結果になるのを防ぐのに役立ちます。
AIが脆弱性を見つけることと、それを実証することの違いは何か
脆弱性の可能性を指摘することは、たとえばユーザーが制御できるURLがサーバーサイドリクエスト関数に到達している、といったもっともらしい弱点を特定することを意味します。それを実証するには、観測可能な効果を生み出し、リクエストとレスポンスまたはコールバックを保存し、前提条件を文書化し、独立して再現できる、認可されたテストが必要です。仮説が確定した検出結果になるのは、その検証の後だけです。
AIペンテストは機密データをリスクにさらすか
その可能性はあります。AIペンテストは、ソースコード、認証情報、HTTPトラフィック、内部URL、顧客記録、動作するエクスプロイトを処理することがあります。チームは、何が外部のモデルAPIに到達するか、オーケストレーションプラットフォームが何をログに記録するか、誰がそれらの記録にアクセスできるか、データがどこに保存されるか、どれだけの期間保持されるか、削除がどのように確認されるかを検証すべきです。
AIが生成したペンテストのレポートは、監査人や顧客に受け入れられるか
普遍的な答えはありません。AI支援型のレポートが受け入れられるのは、適用される監査基準または顧客の要件を満たす場合に限られます。スコープ、方法論、テスターの適格性、独立性、AIの開示、エビデンス、人間によるレビュー、説明責任を事前に確認してください。AIは技術的作業を実行できますが、自らの受け入れ可否を判断することはできません。
AI主導のペンテストにおいて、人間の制御下にとどめるべきものは何か
人間は、スコープ、認証情報、データの分類、禁止される操作、そして破壊的または本番環境に影響する可能性のあるテストの承認を制御すべきです。また、重要な検出結果をレビューし、重大度とビジネスへの影響に異議を唱え、テストされていない領域を精査し、最終的なレポートに何を入れるかを決めるべきです。実行レイヤーは、プロンプトの指示だけに頼るのではなく、これらの決定を強制すべきです。
AIペンテストは実際にコストを削減するか
場合によります。削減が生じるのは、反復作業の減少が、プラットフォームの利用、インフラ、再試行、トリアージ、人間による検証、ガバナンスのコストを上回るときです。裏付けのない検出結果を棄却したり再構成したりするのに費やす工数も含め、同等のスコープと品質について、検証済みの結果あたりの総コストを比較してください。