Autonomous Security : porter l'automatisation de la sécurité au niveau supérieur
L'article introduit le terme Autonomous Security dans le contexte du scan de sécurité et définit 5 niveaux de maturité.
Vue d'ensemble
L'industrie des voitures autonomes définit 6 niveaux de véhicules sans conducteur :
- L0 - Aucune automatisation
- L1 - Assistance au conducteur
- L2 - Automatisation partielle
- L3 - Automatisation conditionnelle
- L4 - Automatisation élevée
- L5 - Automatisation complète.
Alors que le monde du SRE (Site Reliability Engineering) a déjà adopté le terme Autonomous System pour désigner
l'application judicieuse de l'automatisation, le terme Autonomous Security n'est pas largement utilisé par l'industrie de la sécurité.
Pour le SRE, l'automatisation est un multiplicateur de force, pas une panacée. Bien sûr, multiplier simplement la force ne change pas naturellement la précision avec laquelle cette force est appliquée : automatiser sans réfléchir peut créer autant de problèmes que cela en résout. Par conséquent, si nous estimons que l'automatisation logicielle est supérieure à l'exploitation manuelle dans la plupart des circonstances, mieux vaut encore qu'une option ou l'autre une conception de système de plus haut niveau qui ne nécessite ni l'une ni l'autre : un système autonome. Autrement dit, la valeur de l'automatisation vient à la fois de ce qu'elle fait et de son application judicieuse.
Si personne ne contestera que l'automatisation de la sécurité est essentielle pour faire passer à l'échelle les opérations de sécurité de toute organisation, la taille, la diversité et la complexité de nos environnements rendent l'approche actuelle, qui consiste à s'appuyer sur des humains et des processus manuels pour traiter le volume de vulnérabilités et d'incidents, peu évolutive. Faire grandir les équipes sera finalement limité par le nombre de personnes que nous pouvons recruter, et faire grandir les processus finira par paralyser la productivité d'une organisation.
L'objectif d'Autonomous Security est d'automatiser le processus de décision. Dans le contexte du scan de vulnérabilités, par exemple, cela
pourrait prendre la forme de la mise en quarantaine d'une machine vulnérable, de la mise en place d'une règle de pare-feu ou du déploiement d'un correctif ; dans le
contexte de la réponse aux incidents, cela pourrait prendre la forme d'un vidage de la mémoire pour analyse forensique et d'une réduction des accès aux systèmes critiques.
Atteindre ce haut degré d'automatisation est impossible sans technologie efficace ni boucle de rétroaction pour mesurer ce qui fonctionne, ce qui ne fonctionne pas et détecter ce qui manque.
L'article suivant forge le terme Autonomous Security dans le contexte
du scan de sécurité et décrit les blocs technologiques et les politiques nécessaires. L'objectif final est d'automatiser
le confinement et d'utiliser une boucle de rétroaction pour combler les éléments manquants et les angles morts.
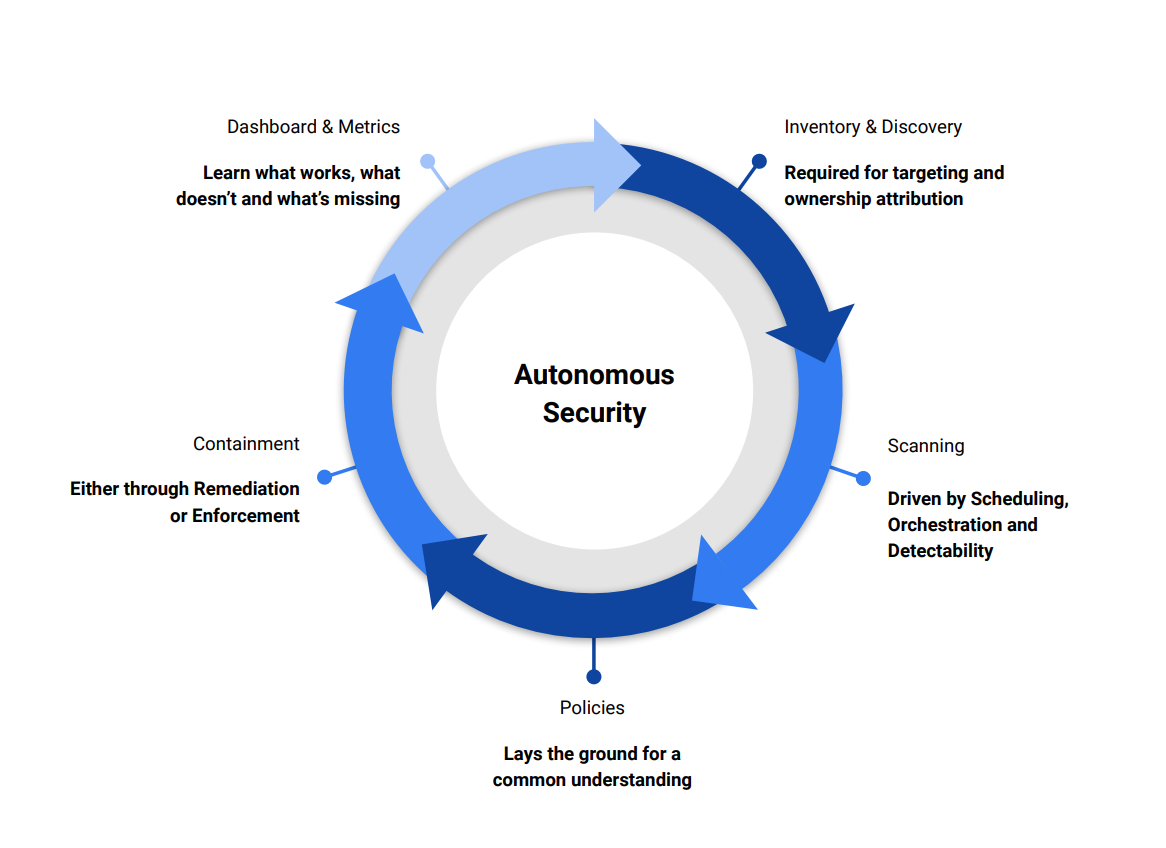
Le document définit 5 niveaux pour refléter les différents degrés de maturité. Dans les sections suivantes, nous définirons chaque bloc
et la manière dont son niveau de maturité peut être amélioré pour atteindre l'objectif d'un Autonomous System complet.
| Concept | T0 | T1 | T2 | T3 | T4 |
|---|---|---|---|---|---|
| Inventaire et découverte | Aucun inventaire | Inventaire manuel | Inventaire partiellement automatisé | Inventaire entièrement automatisé | Inventaire entièrement automatisé avec découverte |
| Politique | Aucune politique | Politique de correctifs | Politique de correctifs + Black Swan | Politique de correctifs + Black Swan + fraîcheur | Politique de correctifs + Black Swan + fraîcheur + application forcée |
| Scan | Scan occasionnel | Scans planifiés à faible fréquence | Scans planifiés | Scans planifiés et surveillance continue basée sur les événements | Scans planifiés, surveillance continue basée sur les événements avec suivi historique |
| Confinement | Remédiation manuelle | Manuel | Semi-automatisé | Automatisé | Automatisé + application forcée |
| D&M | Aucun tableau de bord | Tableau de bord des scans | Couverture, scans et correctifs | Couverture, scans, correctifs et direction | Couverture, scans, correctifs, développeurs, opérations et direction |
1. Inventaire et découverte
L'inventaire consiste à lister les actifs et à collecter des métadonnées utiles comme la propriété, l'usage (production ou développement) et les informations de ciblage, par exemple lister toutes les machines de bureau de votre organisation et collecter des métadonnées comme l'adresse MAC, l'adresse IP et l'employé propriétaire.
L'inventaire sert au scan de sécurité pour planifier les scans, attribuer les vulnérabilités à corriger, présenter une vue agrégée de la sécurité d'un environnement et orienter la remédiation stratégique.
L'inventaire est difficile à maintenir lorsqu'il est purement axé sur la sécurité, et il vaut mieux qu'il ne soit pas géré par l'équipe de sécurité. La maintenance de l'inventaire est un défi tant sur le plan technique que sur celui des processus. Dans la plupart des cas et des environnements, nous devons tenir l'inventaire d'actifs aux exigences différentes et contradictoires, comme des actifs très volatils ou immuables, de faibles volumes avec des changements fréquents ou de gros volumes avec des changements rares, ou une propriété ambiguë ou hiérarchique. Construire et maintenir une infrastructure qui répond à toutes ces exigences est donc un problème très difficile.
Par exemple, pour scanner des machines de bureau ou des serveurs de bases de données : les postes de travail changent régulièrement d'adresse IP et ont un seul propriétaire, alors qu'un serveur de base de données change rarement d'adresse IP, et les services qu'il exécute ont des propriétaires distincts.
De plus, l'inventaire peut servir un large éventail d'usages, comme le suivi de la consommation (financière) ou la surveillance des déploiements (production) ; il est donc plus facile à maintenir s'il est piloté par la production, car c'est généralement le meilleur moyen de le garder à jour.
À titre d'exemple, le projet
Backstagede Spotify, récemment passé en open source : Backstage. Selon l'équipe à l'origine du projet, commeBackstagefournit les outils pour créer et surveiller les déploiements, il est naturellement devenu la source de vérité de leur inventaire.
Si un inventaire à jour est idéal, il n'est pratiquement pas réalisable en raison des angles morts causés par l'interaction humaine ou par des limites technologiques.
Comme il est coûteux de déterminer les angles morts, l'inventaire devrait toujours être complété par un composant de découverte externe qui tente de localiser ces angles morts. La découverte devrait tenter en continu de trouver les failles qui restent non couvertes.
Le système de découverte ne se limite pas aux outils techniques, comme le brute force de noms de domaine, mais peut aussi recourir à d'autres moyens, comme le suivi des paiements effectués avec une carte de crédit d'entreprise pour trouver, par exemple, des projets cloud non répertoriés.
2. Scan
Le scan comporte 3 dimensions, à savoir la planification, l'orchestration et la détection, décrites ci-dessous :
2.1 Planification
La planification répond à la question de savoir quand scanner ; elle est soit basée sur le temps, soit basée sur les événements. Basée sur le temps, par exemple une fois par jour. Basée sur les événements, par exemple à chaque soumission ou chaque fois qu'un nouveau conteneur est créé. La planification est pilotée par la durée de vie de l'actif et par la durée de vie du rapport de vulnérabilités.
Tous les actifs ne se valent pas en matière de planification : par exemple, scanner un site web public requiert des règles continues basées sur le temps, alors que les conteneurs requièrent une approche basée sur les événements, pour scanner à la création et lors de la détection d'une nouvelle CVE affectant l'une des dépendances du conteneur.
Le scan basé sur les événements est toujours préférable au scan basé sur le temps, car il réduit la fenêtre pendant laquelle les choses peuvent mal tourner. Ce n'est malheureusement pas toujours possible. Prenons par exemple le scan en boîte noire d'un site web : sans aucune mesure de la façon dont les choses changent ou évoluent, la seule option est une approche basée sur le temps.
L'approche actuelle basée sur le temps peut être considérablement améliorée en évitant les nouveaux scans complets et en s'appuyant sur les résultats et la couverture des scans précédents. Prenons par exemple le scan d'un site web : au lieu de faire un crawl complet à chaque scan, le scanner peut utiliser les crawls précédents pour accélérer les scans, détecter les changements et concentrer les tests.
Un pipeline Autonomous Security complet n'a pas besoin de marteler un actif avec des scans continus, mais peut adopter une approche plus intelligente. Si un actif est un site web statique qui n'a pas changé depuis 6 mois, le système devrait pouvoir
réduire la fréquence des scans.
2.2 Orchestration
L'orchestration définit comment gérer le cycle de vie d'un scan : que faire en cas d'échec, qui prévenir pendant les différentes phases d'un scan, si un ensemble d'étapes de résolution ou de notifications supplémentaires doit être déclenché, si un environnement dédié dupliqué doit être créé pour le scan.
Avec une architecture de type service mesh (par exemple Istio), il est possible de créer un
testing gardenen dupliquant un ensemble de services pour le scan, d'acheminer le trafic de scan vers le nouveau mesh en fonction de la valeur d'un en-tête, par exemple, et d'appliquer un quota pour accéder aux composants partagés comme une base de données ou une file de messages.
L'orchestration est généralement critique pour les régimes de conformité, comme PCI-DSS ou FedRamp. Un pipeline Autonomous Security complet
peut définir un ensemble de hooks pour déclencher une logique orientée métier : prévenir certaines personnes, mettre à jour certains tableaux de bord,
générer certains rapports, etc.
2.3 Détection
La détection est généralement ce à quoi la plupart des gens pensent lorsqu'on parle de scan de sécurité. Aussi importante soit-elle, elle n'est qu'un rouage dans une grande machinerie.
Une bonne détection doit réduire les faux positifs et les faux négatifs et tenir compte du contexte pour évaluer la sévérité. Trouver le juste équilibre, adapté à la taille d'une organisation et à la criticité d'un environnement, est un équilibre important.
Créer une carte des types d'actifs que possède une organisation, ainsi qu'une carte de couverture, aide à identifier les capacités manquantes. Une carte simplifiée pourrait être aussi simple que :
* Network:
    * IPv4: CHECK
    * IPv6: MISSING

* Web:
    * Known Vulnz: CHECK
    * non-SPA: CHECK
    * SPA: MISSING
    * Authenticated: MISSING

* Mobile:
    * Android: CHECK
    * iOS: CHECK
    * Mobile Backend: CHECK

* Cloud:
    * VM: MISSING
    * Containers: CHECK
    * Serverless: MISSING

 ...
ou aussi complexe que :
* Web:
    * SQL Injection:
      * Postgrs:
        * WHERE Clause: CHECK
        * FROM Clause: MISSING
        * ORDER Clause: LIMITED
Si la détection est un sujet TRÈS vaste, une plainte courante dans ce domaine est que les éditeurs de solutions de sécurité promettent souvent trop et livrent trop peu. Voici une bonne ressource expliquant pourquoi l'industrie de la sécurité échoue à cause de technologies inefficaces
Toutes les solutions de sécurité peuvent se décomposer en 2 éléments technologiques : un Analysis Engine et un ensemble de Rules. Le moteur est généralement
ce qui prend un programme, un site web ou une IP et effectue un ensemble de transformations ou d'interactions.
Exemples d'Analysis Engines :
- Moteur d'empreinte des dépendances : trouve les dépendances et les composants tiers.
- Moteur de taint : génère un graphe de taint orienté objet pour trouver le lien entre les sources et les sinks.
- Moteur dynamique : collecte les stack traces, les méthodes et les paramètres.
- Moteur de fuzzing : injecte des entrées et collecte le flux de données et les rapports de plantage.
Les sorties du moteur sont ensuite utilisées par les Rules pour détecter un comportement vulnérable. Les règles ressemblent généralement à ceci :
- Si le nom de l'application est
libjpegen version <2.0.1et que BMP est activé, alors elle est vulnérable à la corruption de mémoire. - Si l'API de chiffrement est utilisée avec le mode
ECB, alors elle est vulnérable à un mode de chiffrement non sécurisé.
Les
Rulesont toujours été conçues à la main par des experts et utilisent généralement les résultats d'un seulAnalysis Engine. En raison de l'économie et du coût de création desRules, la détection de vulnérabilités improbables dans des frameworks peu courants, même aux conséquences graves, est rarement réalisée.
3 Politiques
Les politiques sont les principes directeurs ; elles définissent le cadre de prise de décision. Lorsqu'elles sont validées par les bons canaux (CTO, CISO ...), les politiques aident les organisations à agir en temps voulu et réduisent le besoin d'escalades et d'allers-retours.
La politique traditionnelle est la politique de correctifs. Elle définit quand une vulnérabilité doit être corrigée, en fonction de sa sévérité. Par exemple, les problèmes de sévérité élevée doivent être corrigés sous 1 mois. Sinon, une application forcée peut être appliquée aux actifs vulnérables (voir la section 4) ou le problème peut être escaladé (voir la section 5).
Vous serez surpris de voir à quel point présenter à la direction un tableau de bord montrant par exemple les éléments hors SLO peut contribuer à accélérer les corrections.
Cette politique de correctifs n'est pas suffisante, car elle est réactive face aux problèmes de sécurité et, par définition, toujours en retard. Un excellent complément est une politique de fraîcheur qui exige que les logiciels, les dépendances et une application n'aient pas plus de x mois. La politique Black Swan est également un autre excellent exemple : elle définit quoi faire en cas de vulnérabilités de sévérité très élevée nécessitant la mobilisation de plusieurs équipes.
Les politiques sont essentielles, non seulement du point de vue de la sécurité, mais aussi du point de vue opérationnel. Elles maintiennent la production en bonne santé et évitent l'accumulation de dette technique et de dette de production.
De nombreuses organisations racontent des histoires d'horreur à propos d'une application critique en production dont personne ne sait comment la construire ou la déployer et qui sert la production depuis des années.
Pour atteindre un système Autonmous Security complet, une politique d'application forcée est nécessaire pour définir comment l'application forcée automatisée
peut fonctionner, si elle nécessite un humain dans la boucle ou sur la boucle, comment le break glass peut être effectué et quels systèmes sont éligibles.
Human-in-the-loop ou HITL désigne un modèle qui nécessite une interaction humaine. Human-on-the-loop ou HOnTL désigne un modèle placé sous la supervision d'un opérateur humain qui peut annuler les actions. Human-out-the-loop ou HOutTL désigne un modèle qui n'a aucune interaction ni supervision humaine.
4. Confinement : remédiation et application forcée
La remédiation est le bloc le plus sous-estimé et, paradoxalement, le plus critique. Le confinement est ce qui aide à corriger les vulnérabilités ou à les supprimer.
La remédiation est très difficile à réussir. C'est souvent d'abord un problème humain, et la difficulté commence dès la recherche du bon responsable pour effectuer la correction, en passant par la mise en place des bonnes incitations pour que les choses soient corrigées, la recherche du bon canal de communication pour signaler et suivre les corrections, jusqu'à, enfin, la possibilité de vérifier qu'une vulnérabilité est correctement corrigée.
Le cloud offre d'excellents outils pour aider à qualifier les corrections sans impacter le flux de production : des outils comme Terraform pour dupliquer des projets complets, ou des service meshes comme Istio pour faire du déploiement canary, aident beaucoup à résoudre ces problèmes.
L'application forcée est le sommet d'un système Autonomous Security ; elle aide à empêcher les vulnérabilités
de s'insinuer lentement dans votre système et constitue une excellente incitation pour que les développeurs et les équipes d'exploitation
accélèrent les corrections.
L'application forcée doit toutefois tenir compte de l'importance de rendre d'abord la production fiable et d'offrir des moyens vérifiables et traçables de faire du break glass en cas de besoin. L'application forcée ne peut se faire sans l'adhésion de la direction, et il vaut mieux commencer petit : l'appliquer d'abord aux systèmes expérimentaux exposés sur Internet, puis aux systèmes internes, jusqu'aux systèmes de production non critiques.
L'application forcée peut commencer avec un humain dans la boucle, qui donne son feu vert aux mesures, puis passer par un humain sur la boucle, qui se contente de revoir les actions déjà prises.
Le cloud offre des outils pour imposer un déploiement sécurisé et se rétablir après des compromissions, avec des outils comme TUF et Notary.
5. Tableaux de bord et métriques
Les Dashboard et les Metrics sont une partie critique d'un système de sécurité autonome. Ils mesurent la santé d'un système, offrent
un moyen mesurable de calculer le retour sur investissement et peuvent aider à orienter les actions stratégiques par des décisions éclairées et
fondées sur des données.
Les Dashboards aident à fournir aux bonnes personnes la bonne quantité d'information pour prendre des décisions éclairées
et prioriser les actions. Avoir la capacité de comprendre votre posture, de voir comment les choses s'améliorent (ou non) et de
mesurer quantitativement ce qui manque, c'est ce qui fait souvent défaut en sécurité.
Les Dashboards sont en partie alimentés par des Metrics, qui aident à identifier les tendances, à mesurer et à prévenir la dégradation lente, ainsi qu'à
mesurer les progrès et le retour sur investissement.
Les tableaux de bord à l'échelle de l'organisation qui listent par exemple le nombre de vulnérabilités par unité métier ou par équipe sont efficaces pour inciter à l'action. Vous serez surpris de voir que personne ne veut être en bas du classement et que les classements peuvent susciter une saine compétition.
Le tableau de bord doit être adapté à chaque utilisateur de manière à faciliter des décisions actionnables. Par exemple, le tableau de bord des équipes de sécurité se concentrera sur la sévérité et le volume des vulnérabilités, celui des dirigeants de niveau C sur la santé globale, l'état de l'organisation métier et les problèmes les plus urgents, et celui des développeurs sur le code dont ils sont responsables ou sur lequel ils travaillent.
Le tableau de bord doit fournir une vue utile pour tirer des conclusions fondées sur des données et prendre des décisions éclairées.
Et ensuite ?
Ostorlab a été créé pour fournir les outils qui facilitent l'intégration d'une solution Autonomous Security
dans n'importe quelle organisation. Cela commence par l'intégration avec des stores spécialisés et des API d'inventaire, la mise à disposition d'outils de découverte technique performants
(comme les stores Android et iOS pour les applications mobiles), l'accent mis sur la détection de vulnérabilités de sévérité élevée avec une grande confiance
(comme les dépendances obsolètes ou la fuite de secrets) et la simplification de la création de règles de surveillance.
Pour rester informé des dernières nouveautés, abonnez-vous à notre newsletter mensuelle.
Tags :
security