自律型セキュリティ:セキュリティ自動化を次のレベルへ
セキュリティスキャンの文脈でAutonomous Security(自律型セキュリティ)という用語を紹介し、5段階の成熟度を定義します。
概要
自動運転車業界は、無人運転車の6つのレベルを定義しています。
- L0:自動化なし
- L1:運転支援
- L2:部分的な自動化
- L3:条件付きの自動化
- L4:高度な自動化
- L5:完全な自動化
SRE(Site Reliability Engineering)の世界では、自動化を賢明に適用することを指す言葉としてAutonomous System(自律システム)という用語がすでに採用されていますが、Autonomous Security(自律型セキュリティ)という言葉は、セキュリティ業界ではまだ広く使われていません。
SREにとって、自動化は戦力を何倍にも高めるものであって、万能薬ではありません。もちろん、単に力を何倍にしても、その力が向けられる先の正確さが自然に変わるわけではありません。考えなしに自動化を行えば、解決するのと同じくらい多くの問題を生み出しかねません。したがって、ソフトウェアによる自動化はほとんどの状況で手作業による運用より優れていると当社は考えていますが、そのどちらよりも優れているのは、どちらも必要としない、より高次のシステム設計、すなわち自律システムです。言い換えれば、自動化の価値は、それが何を行うかと、それをいかに賢明に適用するかの両方から生まれるのです。
セキュリティ自動化が、あらゆる組織でセキュリティ運用をスケールさせるうえで極めて重要であることに異論を唱える人はいないでしょう。私たちが運用している環境の規模、多様性、複雑さを考えると、膨大な数の脆弱性やインシデントに人間と手作業のプロセスで対処する現在のアプローチは、あまりスケーラブルではありません。チームをスケールさせようとすれば、いずれ採用できる人数によって制限され、プロセスをスケールさせようとすれば、いずれ組織の生産性を損なうことになります。
Autonomous Securityの目標は、意思決定のプロセスを自動化することです。たとえば脆弱性スキャンの文脈では、脆弱なマシンの隔離、ファイアウォールルールの設定、パッチの適用といった形を取るかもしれません。インシデント対応の文脈では、フォレンジック分析のためのメモリダンプや、重要なシステムへのアクセスの制限といった形を取るかもしれません。
これほど高度な自動化を実現するには、効果的なテクノロジーと、何が機能し、何が機能しないかを測定し、何が欠けているかを検出するためのフィードバックループが欠かせません。
本記事では、セキュリティスキャンの文脈でAutonomous Securityという用語を提唱し、必要となる技術的な構成要素とポリシーの概要を説明します。最終的な目標は、封じ込めを自動化し、フィードバックループを使って欠けている部分や死角に対処することです。
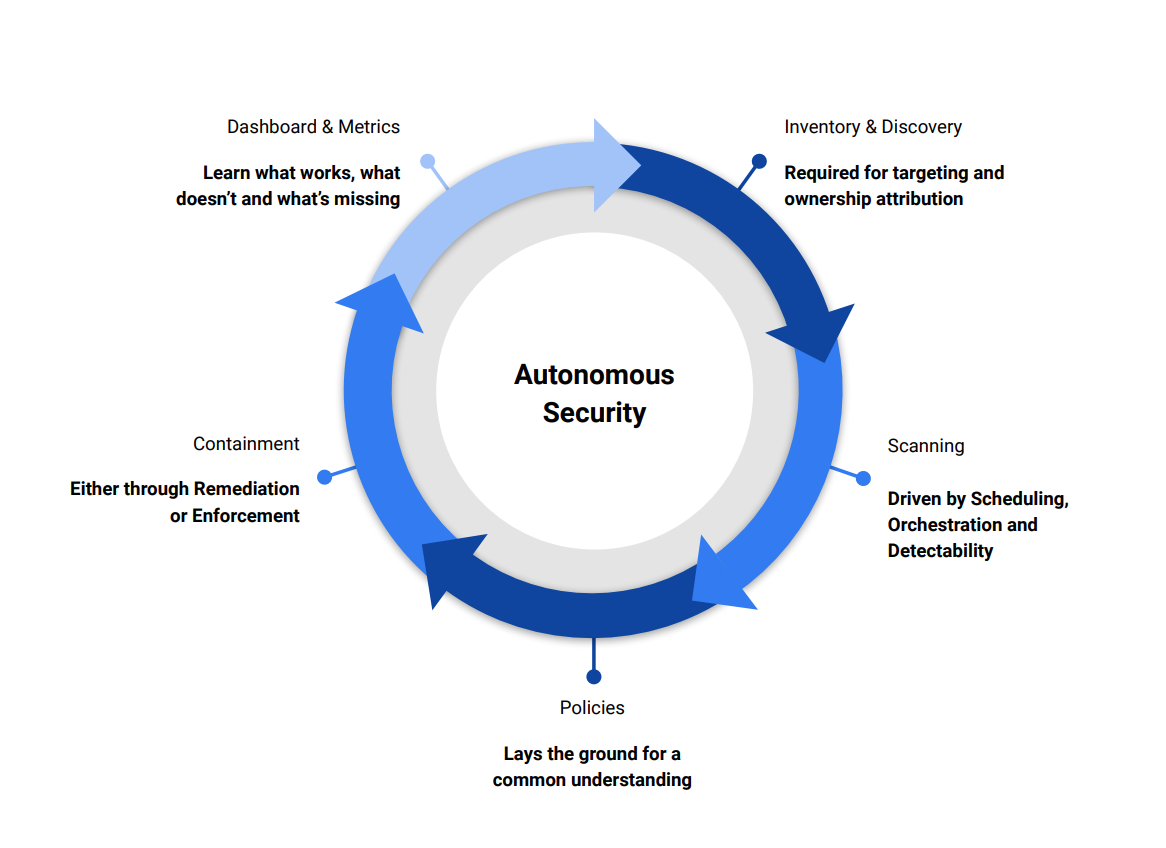
本記事では、異なる成熟度レベルを反映した5つの段階を定義します。以下のセクションでは、各構成要素を定義し、完全なAutonomous Systemという目標を達成しながら、それぞれの成熟度レベルをどのように高められるかを説明します。
| 概念 | T0 | T1 | T2 | T3 | T4 |
|---|---|---|---|---|---|
| インベントリと検出 | インベントリなし | 手動のインベントリ | 部分的に自動化されたインベントリ | 完全に自動化されたインベントリ | 検出機能を備えた完全に自動化されたインベントリ |
| ポリシー | ポリシーなし | パッチ適用ポリシー | パッチ適用+ブラックスワンポリシー | パッチ適用+ブラックスワン+鮮度ポリシー | パッチ適用+ブラックスワン+鮮度+強制適用ポリシー |
| スキャン | 不定期のスキャン | 低頻度の定期スキャン | 定期スキャン | 定期スキャンと継続的なイベントベースの監視 | 定期スキャン、履歴追跡を伴う継続的なイベントベースの監視 |
| 封じ込め | 手動の修復 | 手動 | 半自動 | 自動 | 自動+強制適用 |
| D&M | ダッシュボードなし | スキャンのダッシュボード | カバレッジ、スキャン、修正 | カバレッジ、スキャン、修正、経営層 | カバレッジ、スキャン、修正、開発、運用、経営層 |
1. インベントリと検出
インベントリとは、アセットを一覧化し、所有者、用途(本番環境か開発環境か)、ターゲット情報といった有用なメタデータを収集することです。たとえば、組織内のすべてのデスクトップマシンを一覧化し、MACアドレス、IPアドレス、所有者である従業員といったメタデータを収集します。
インベントリは、セキュリティスキャンにおいて、スキャンのスケジュール設定、修正のための脆弱性の割り当て、環境のセキュリティの集約ビューの提示、そして戦略的な修復の推進に使われます。
インベントリは、純粋にセキュリティだけを目的としている場合は維持が難しく、セキュリティチームが運用しないほうがうまくいきます。インベントリの維持は、技術とプロセスの両面で課題があります。ほとんどのケースや環境において、異なる、そして相反する要件を持つアセットのインベントリを維持する必要に迫られます。たとえば、変動の激しいアセットとイミュータブルなアセット、少量で頻繁に変更されるものと大量でまれにしか変更されないもの、あるいは曖昧な所有関係と階層的な所有関係などです。したがって、これらの要件すべてに対応するインフラストラクチャを構築し、維持することは非常に難しい問題です。
たとえば、デスクトップマシンとデータベースサーバーのスキャンを比べてみましょう。デスクトップは日常的にIPアドレスが変わり、所有者は1人です。一方、データベースサーバーはIPアドレスがめったに変わらず、そこで動作するサービスにはそれぞれ別の所有者がいます。
さらに、インベントリは、消費の追跡(財務)やデプロイの監視(本番)など、幅広い用途に役立ちます。そのため、本番の運用によって推進されるほうが維持しやすくなります。通常、それが最新の状態を保つ最善の方法だからです。
その好例が、Spotifyが新たにオープンソース化したプロジェクト
Backstageです(Backstage)。プロジェクトの開発チームによると、Backstageはデプロイを作成・監視するためのツールを提供しているため、自然とインベントリの信頼できる情報源(source of truth)になったといいます。
最新のインベントリが理想ですが、人間の関与や技術的な制約によって生じる死角のため、実際には実現できません。
死角を特定するのは骨の折れる作業であるため、インベントリは常に外部の検出コンポーネントで補強すべきです。このコンポーネントは、それぞれの死角を見つけ出そうとします。検出は、カバーされずに残っている抜け穴を継続的に見つけようとするべきです。
検出システムは、ドメイン名のブルートフォースのような技術的なツールに限られず、ほかの手段に頼ることもできます。たとえば、企業のクレジットカードで行われた支払いを追跡して、一覧に載っていないクラウドプロジェクトを見つけるといった方法です。
2. スキャン
スキャンには、スケジューリング、オーケストレーション、検出という3つの次元があり、それぞれ次のとおりです。
2.1 スケジューリング
スケジューリングは、いつスキャンするかという問いに答えるものです。時間ベースかイベントベースのいずれかになります。時間ベースとは、たとえば1日に1回といったものです。イベントベースとは、たとえばサブミットのたびに、あるいは新しいコンテナが作成されるたびに、といったものです。スケジューリングは、アセットのライフタイムと脆弱性レポートのライフタイムによって決まります。
スケジューリングに関しては、すべてのアセットが同じではありません。たとえば、公開Webサイトのスキャンには継続的な時間ベースのルールが必要です。一方、たとえばコンテナには、作成時にスキャンするイベントベースのルールと、コンテナの依存関係のいずれかに影響する新しいCVEの検出が必要です。
イベントベースのスキャンは、問題が発生し得る時間枠を狭められるため、常に時間ベースのスキャンよりも望ましいものです。残念ながら、常に可能とは限りません。たとえば、Webサイトのブラックボックススキャンを考えてみてください。物事がどのように変化し進化しているかを測る手段がなければ、取れる選択肢は時間ベースのアプローチだけです。
現在の時間ベースのアプローチは、フルの再スキャンを避け、以前のスキャン結果とカバレッジを土台にすることで、大幅に改善できます。 たとえばWebサイトのスキャンでは、スキャンのたびにフルクロールを行う代わりに、スキャナーが以前のクロール結果を使って、 スキャンを高速化し、変更を検出し、テストの焦点を絞ることができます。
完全なAutonomous Securityのパイプラインは、継続的なスキャンでアセットを叩き続ける必要はなく、より賢いアプローチを取ることができます。アセットが静的なWebサイトで、過去6か月間変更されていないのであれば、システムはスキャンの頻度を下げられるべきです。
2.2 オーケストレーション
オーケストレーションは、スキャンのライフサイクルをどのように扱うかを定義します。たとえば、失敗した場合に何をするか、スキャンのさまざまなフェーズで誰に通知するか、追加の解決手順や通知を一式トリガーすべきか、スキャン用に複製した専用環境を作成すべきか、といったことです。
サービスメッシュ型のアーキテクチャ(Istioなど)を使えば、スキャン用に一連のサービスを複製して
testing gardenを作成し、たとえばヘッダーの値に基づいてスキャンのトラフィックを新しいメッシュにルーティングし、データベースやメッセージキューといった共有コンポーネントへのアクセスにクォータを適用することができます。
オーケストレーションは、PCI-DSSやFedRampといったコンプライアンス体制において、一般に極めて重要です。完全なAutonomous Securityのパイプラインでは、特定の人への通知、特定のダッシュボードの更新、特定のレポートの生成など、ビジネス指向のロジックをトリガーするための一連のフックを定義できます。
2.3 検出
検出は、セキュリティスキャンについて語るとき、多くの人がまず思い浮かべるものです。重要ではありますが、大きな機械の中の歯車の一つにすぎません。
適切な検出は、誤検知(フォールスポジティブ)と検出漏れ(フォールスネガティブ)を減らし、コンテキストを考慮して重大度を評価しなければなりません。組織の規模と環境の重大性に見合った正しいバランスを見つけることが重要です。
組織が所有するアセットの種類のマップを作成し、カバレッジマップを作成することは、欠けている機能を特定するのに役立ちます。簡略化したマップは、次のように単純なものでも構いません。
* Network:
    * IPv4: CHECK
    * IPv6: MISSING

* Web:
    * Known Vulnz: CHECK
    * non-SPA: CHECK
    * SPA: MISSING
    * Authenticated: MISSING

* Mobile:
    * Android: CHECK
    * iOS: CHECK
    * Mobile Backend: CHECK

* Cloud:
    * VM: MISSING
    * Containers: CHECK
    * Serverless: MISSING

 ...
あるいは、次のように複雑なものにもなり得ます。
* Web:
    * SQL Injection:
      * Postgrs:
        * WHERE Clause: CHECK
        * FROM Clause: MISSING
        * ORDER Clause: LIMITED
検出は非常に大きなテーマですが、この分野でよく聞かれる不満は、セキュリティベンダーが過大な約束をしながら、期待に応えられていないというものです。効果のないテクノロジーのためにセキュリティ業界が失敗している理由については、こちらの資料が参考になります
すべてのセキュリティソリューションは、Analysis Engine(解析エンジン)と一連のRules(ルール)という2つの技術的な要素に分けることができます。エンジンとは一般に、プログラム、Webサイト、IPを受け取り、一連の変換やインタラクションを実行するものです。
Analysis Enginesの例:
- 依存関係フィンガープリントエンジン:依存関係とサードパーティのコンポーネントを見つけます。
- テイントエンジン:オブジェクト指向のテイントグラフを生成し、ソースとシンクの間のつながりを見つけます。
- 動的エンジン:スタックトレース、メソッド、パラメーターを収集します。
- ファジングエンジン:入力を注入し、データフローとクラッシュレポートを収集します。
エンジンの出力は、その後Rulesによって脆弱な挙動の検出に使われます。ルールは一般に、次のようなものです。
- アプリケーション名が
libjpegでバージョンが<2.0.1、かつBMPが有効になっている場合、メモリ破壊に対して脆弱である。 - 暗号化APIが
ECBモードで使われている場合、安全でない暗号化モードに対して脆弱である。
Rulesはこれまで常に専門家が手作業で作成しており、通常は単一のAnalysis Engineの結果を使います。Rulesの作成にかかる経済性とコストのため、あまり一般的でないフレームワークに存在する起こりにくい脆弱性の検出は、たとえ深刻な結果をもたらすものであっても、めったに行われません。
3 ポリシー
ポリシーは指針となる原則であり、意思決定の枠組みを定めるものです。適切な経路(CTO、CISOなど)で承認されたポリシーは、組織が適時に行動を起こすのを助け、エスカレーションややり取りの繰り返しの必要性を減らします。
従来型のポリシーは、パッチ適用ポリシーです。これは、脆弱性の重大度に応じて、いつまでに修正すべきかを定めるものです。たとえば、重大度が高い問題は1か月以内に修正しなければならない、といったものです。修正されない場合、脆弱なアセットに対して強制適用を行う(セクション4を参照)か、エスカレーションする(セクション5を参照)ことができます。
たとえば、SLOを超過したものを示すダッシュボードを経営層に見せることが、修正をどれほど早めるのに役立つかに驚くことでしょう。
このパッチ適用ポリシーは、セキュリティ上の問題に対して受け身であり、定義上、常に後手に回るため、十分ではありません。 そこで有効な追加策となるのが、ソフトウェア、依存関係、アプリケーションがxか月より古くないことを求める鮮度ポリシーです。 ブラックスワンポリシーも優れた例の一つで、複数のチームから何人もの人手を総動員する必要がある、極めて深刻な脆弱性の場合に何をすべきかを定めます。
ポリシーは、セキュリティの観点だけでなく、運用の観点からも不可欠です。本番環境を健全に保ち、技術的負債や本番環境の負債が蓄積するのを防ぎます。
多くの組織が、本番環境に欠かせないアプリケーションでありながら、誰もビルドやデプロイの方法を知らないまま、何年も本番環境で稼働し続けているという恐ろしい話を共有しています。
完全なAutonmous Securityシステムを実現するには、自動化された強制適用がどのように動作できるか、人間がループの中(in the loop)にいる必要があるのか、ループの上(on the loop)にいる必要があるのか、緊急時の例外措置(break glass)をどのように行えるか、そしてどのシステムが対象となるかを定義する強制適用ポリシーが必要です。
Human-in-the-loop(HITL)とは、人間によるインタラクションを必要とするモデルと定義されます。Human-on-the-loop(HOnTL)とは、 人間のオペレーターの監督下にあり、そのオペレーターがアクションを覆すモデルと定義されます。Human-out-the-loop(HOutTL)とは、 人間によるインタラクションや監督が一切ないモデルと定義されます。
4. 封じ込め:修復と強制適用
修復は、最も過小評価されていながら、逆説的に最も重要な構成要素です。封じ込めとは、脆弱性の修正や除去を助けるものです。
修復を正しく行うのは非常に困難です。多くの場合、まず人の問題であり、修正してもらうための適切な担当者を探すことから始まり、修正を進めるための適切なインセンティブを用意すること、修正を報告・追跡するための適切なコミュニケーション手段を見つけること、そして最終的に脆弱性が適切に修正されたことを検証する手段を持つことに至るまで、どの段階でも難しさがあります。
クラウドは、本番のワークフローに影響を与えずに修正を検証するのに役立つ優れたツールを提供しています。プロジェクト全体を複製するTerraformのようなツールや、カナリアデプロイを行うIstioのようなサービスメッシュは、こうした問題の解決に大いに役立ちます。
強制適用はAutonomous Securityシステムの頂点です。脆弱性がじわじわとシステムに入り込むのを防ぐのに役立ち、開発者や運用チームに修正を急がせる大きなインセンティブになります。
ただし、強制適用では、まず本番環境の信頼性を確保することの重要性を考慮し、必要な場合には検証可能で追跡可能な緊急時の例外措置(break glass)の手段を提供すべきです。強制適用は経営層の賛同なしには行えず、小さく始めるのが得策です。まずインターネットに面した実験的なシステムに適用し、次に社内システム、そして重要度の低い本番システムへと広げていきます。
強制適用は、人間がループの中にいて強制適用に許可を出す形から始め、その後、人間がループの上にいて、すでに実行されたアクションをレビューするだけの形へと移行できます。
クラウドは、TUFやNotaryといったツールを使って、安全なデプロイを強制し、侵害から復旧するためのツールを提供しています。
5. ダッシュボードと指標
Dashboard(ダッシュボード)とMetrics(指標)は、自律型セキュリティシステムの重要な部分です。システムの健全性を測定し、投資対効果を算出するための測定可能な手段となり、データに裏付けられた情報に基づく意思決定によって戦略的な行動を推進するのに役立ちます。
Dashboardsは、適切な人に適切な量の情報を提供し、情報に基づいた意思決定と行動の優先順位付けを助けます。自社のセキュリティ態勢、物事が改善しているか(いないか)を理解し、何が欠けているかを定量的に測定する能力こそ、セキュリティにおいてしばしば欠けているものです。
Dashboardsは部分的にMetricsによって支えられており、傾向の特定、ゆっくりとした劣化の測定と防止、そして進捗と投資対効果の測定に役立ちます。
たとえば事業部門やチームごとの脆弱性の数を一覧表示する組織全体のダッシュボードは、行動を促すのに効果的です。 誰もチャートの最下位にはなりたくないこと、そしてリーダーボードが健全な競争を生み出すことに驚くことでしょう。
ダッシュボードは、実行可能な意思決定に役立つよう、ユーザーごとに調整されなければなりません。たとえば、セキュリティチームのダッシュボードは脆弱性の重大度と量に焦点を当て、経営層のダッシュボードは全体的な健全性、事業組織の状況、最も緊急性の高い問題に焦点を当て、開発者のダッシュボードは自分が所有している、あるいは作業しているコードに焦点を当てます。
ダッシュボードは、データに裏付けられた結論を導き、情報に基づいた行動を取るための有用なビューを提供しなければなりません。
今後について
Ostorlabは、あらゆる組織にAutonomous Securityソリューションを容易に統合するためのツールを提供する目的で作られました。これは、専門的なストアやインベントリのAPIとの連携から始まり、(モバイルアプリケーション向けのAndroidやiOSのストアのような)高機能な技術的検出ツールの提供、(古い依存関係やシークレットの漏えいのような)重大度の高い脆弱性を高い確度で検出することへの注力、そして監視ルールの作成を容易にすることへと続きます。
最新情報を受け取るには、当社の月刊ニュースレターをご購読ください。
タグ:
security