Seguridad autónoma: llevar la automatización de la seguridad al siguiente nivel
El artículo introduce el término Autonomous Security en el contexto del escaneo de seguridad y define 5 niveles de madurez.
Visión general
La industria de los coches autónomos define 6 niveles de vehículos sin conductor:
- L0 - Sin automatización
- L1 - Asistencia al conductor
- L2 - Automatización parcial
- L3 - Automatización condicional
- L4 - Automatización alta
- L5 - Automatización total.
Mientras que el mundo de la SRE (ingeniería de fiabilidad de sitios) ya ha adoptado el término Autonomous System para referirse a la
aplicación juiciosa de la automatización, la expresión Autonomous Security no se utiliza ampliamente en la industria de la seguridad.
Para la SRE, la automatización es un multiplicador de fuerza, no una panacea. Por supuesto, multiplicar la fuerza sin más no cambia de forma natural la precisión con la que se aplica esa fuerza: automatizar sin reflexión puede crear tantos problemas como los que resuelve. Por lo tanto, aunque creemos que la automatización basada en software es superior a la operación manual en la mayoría de las circunstancias, mejor que cualquiera de las dos opciones es un diseño de sistema de nivel superior que no requiera ninguna de ellas: un sistema autónomo. O, dicho de otro modo, el valor de la automatización procede tanto de lo que hace como de su aplicación juiciosa.
Aunque nadie discutirá que la automatización de la seguridad es crítica para escalar las operaciones de seguridad en cualquier organización, el tamaño, la diversidad y la complejidad con los que operamos hacen que el enfoque actual, basado en personas y procesos manuales para atender el volumen de vulnerabilidades e incidentes, no sea muy escalable. El crecimiento de los equipos acabará limitado por el número de personas que podamos contratar, y el crecimiento de los procesos acabará paralizando la productividad de una organización.
El objetivo de Autonomous Security es automatizar el proceso de decisión. En el contexto del escaneo de vulnerabilidades, por ejemplo, esto
podría adoptar la forma de poner en cuarentena una máquina vulnerable, configurar una regla de firewall o desplegar un parche; en el
contexto de la respuesta a incidentes, podría adoptar la forma de volcar la memoria para el análisis forense y reducir el acceso a los sistemas críticos.
Alcanzar este alto grado de automatización no es posible sin una tecnología eficaz y un bucle de retroalimentación que mida lo que funciona, lo que no, y detecte lo que falta.
El siguiente artículo acuña el término Autonomous Security en el contexto
del escaneo de seguridad y describe los bloques tecnológicos y las políticas necesarios. El objetivo final es automatizar
la contención y usar un bucle de retroalimentación para cubrir las piezas que faltan y los puntos ciegos.
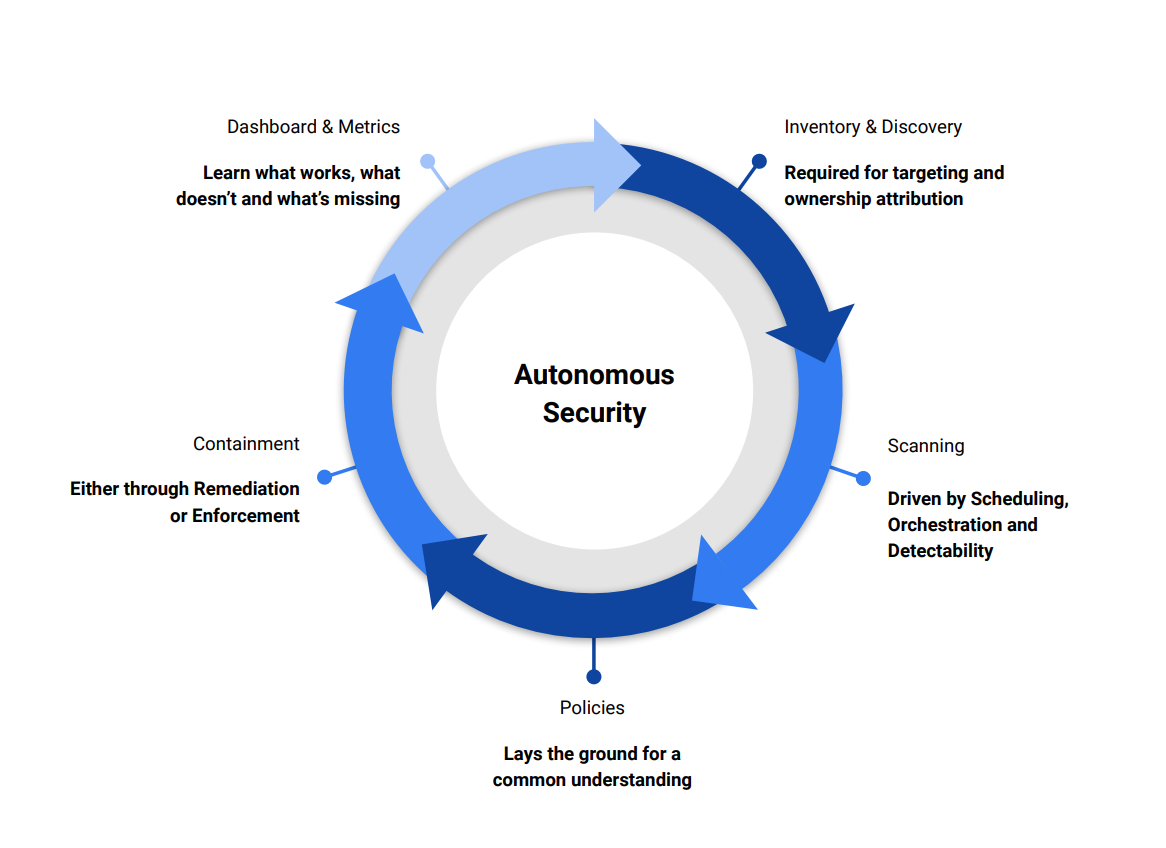
El documento define 5 niveles para reflejar los distintos grados de madurez. En las siguientes secciones definiremos cada bloque
y cómo se puede mejorar su nivel de madurez mientras se avanza hacia el objetivo de un Autonomous System completo.
| Concepto | T0 | T1 | T2 | T3 | T4 |
|---|---|---|---|---|---|
| Inventario y descubrimiento | Sin inventario | Inventario manual | Inventario parcialmente automatizado | Inventario totalmente automatizado | Inventario totalmente automatizado con descubrimiento |
| Política | Sin política | Política de aplicación de parches | Aplicación de parches + política de Black Swan | Aplicación de parches + Black Swan + política de actualización | Aplicación de parches + Black Swan + actualización + política de cumplimiento forzoso |
| Escaneo | Escaneo ocasional | Escaneos programados de baja frecuencia | Escaneos programados | Escaneos programados y monitorización continua basada en eventos | Escaneos programados y monitorización continua basada en eventos con seguimiento histórico |
| Contención | Corrección manual | Manual | Semiautomatizada | Automatizada | Automatizada + cumplimiento forzoso |
| P&M | Sin panel | Panel de escaneo | Cobertura, escaneo y correcciones | Cobertura, escaneo, correcciones y dirección | Cobertura, escaneo, correcciones, desarrolladores, operaciones y dirección |
1. Inventario y descubrimiento
El inventario consiste en enumerar los activos y recopilar metadatos útiles, como la propiedad, el uso (producción frente a desarrollo) y la información de destino, por ejemplo enumerar todos los equipos de escritorio de su organización y recopilar metadatos como la dirección MAC, la dirección IP y el empleado propietario.
El inventario se utiliza en el escaneo de seguridad para programar escaneos, asignar vulnerabilidades para su corrección, presentar una visión agregada de la seguridad de un entorno e impulsar una corrección estratégica.
El inventario es difícil de mantener cuando se centra únicamente en la seguridad, y es mejor que no lo gestione el equipo de seguridad. Mantener el inventario es un reto tanto desde el punto de vista técnico como desde el de los procesos. En la mayoría de los casos y entornos nos enfrentamos a la necesidad de mantener el inventario de activos con requisitos distintos y contradictorios, como activos muy volátiles frente a inmutables, volumen bajo con cambios frecuentes frente a volúmenes altos con cambios poco frecuentes, o propiedad ambigua frente a jerárquica. Por tanto, construir y mantener una infraestructura que dé respuesta a todos estos requisitos es un problema muy difícil.
Por ejemplo, al escanear equipos de escritorio frente a servidores de bases de datos: los equipos de escritorio cambian de dirección IP con frecuencia y tienen un único propietario, mientras que un servidor de bases de datos rara vez cambia de dirección IP, y los servicios que ejecuta tienen propietarios distintos.
Además, el inventario puede beneficiar a una amplia gama de usos, como el seguimiento del consumo (financiero) y la monitorización de los despliegues (producción), por lo que es más fácil de mantener si lo impulsa la producción, ya que suele ser la mejor manera de mantenerlo actualizado.
Como ejemplo, el proyecto
Backstagede Spotify, publicado recientemente como código abierto: Backstage. Según el equipo responsable del proyecto, comoBackstageproporciona las herramientas para crear y monitorizar despliegues, se ha convertido de forma natural en la fuente de verdad de su inventario.
Aunque un inventario actualizado es lo ideal, en la práctica no es alcanzable debido a los puntos ciegos causados por la interacción humana o por limitaciones tecnológicas.
Como determinar los puntos ciegos resulta costoso, el inventario siempre debería complementarse con un componente de descubrimiento externo que intente localizar esos puntos ciegos. El descubrimiento debería intentar continuamente encontrar las lagunas que siguen sin cubrirse.
El sistema de descubrimiento no se limita a herramientas técnicas, como la fuerza bruta sobre nombres de dominio, sino que también puede recurrir a otros medios, como el seguimiento de los pagos realizados con la tarjeta de crédito corporativa para encontrar, por ejemplo, proyectos en la nube que no figuran en la lista.
2. Escaneo
El escaneo tiene 3 dimensiones, a saber, la programación, la orquestación y la detección, que son las siguientes:
2.1 Programación
La programación responde a la pregunta de cuándo escanear; puede basarse en el tiempo o en eventos. Basada en el tiempo, por ejemplo, una vez al día. Basada en eventos, por ejemplo, en cada envío de código o cada vez que se crea un nuevo contenedor. La programación depende de la vida útil del activo y de la vida útil del informe de vulnerabilidades.
No todos los activos son iguales en lo que respecta a la programación; por ejemplo, escanear un sitio web público requiere reglas continuas basadas en el tiempo, mientras que los contenedores, por ejemplo, requieren un enfoque basado en eventos para escanear en el momento de la creación y cuando se detecta un nuevo CVE que afecta a una de las dependencias del contenedor.
El escaneo basado en eventos siempre es preferible a los escaneos basados en el tiempo, porque reduce la ventana en la que las cosas pueden salir mal. Por desgracia, no siempre es posible. Tomemos, por ejemplo, el escaneo de caja negra de un sitio web: sin ninguna medida de cómo están cambiando o evolucionando las cosas, la única opción que tenemos es un enfoque basado en el tiempo.
El enfoque actual basado en el tiempo puede mejorarse drásticamente evitando los reescaneos completos y apoyándose en los resultados y la cobertura de escaneos anteriores. Tomemos, por ejemplo, el escaneo de un sitio web: en lugar de hacer un rastreo completo en cada escaneo, el escáner puede utilizar rastreos anteriores para acelerar los escaneos, detectar cambios y centrar las pruebas.
Un pipeline de Autonomous Security completo no necesita machacar un activo con escaneos continuos, sino que puede adoptar un enfoque más inteligente.
Si un activo es un sitio web estático y no ha cambiado en los últimos 6 meses, el sistema debería poder
reducir la frecuencia de los escaneos.
2.2 Orquestación
La orquestación define cómo gestionar el ciclo de vida de un escaneo, por ejemplo qué hacer en caso de fallo, a quién notificar durante las distintas fases de un escaneo, si debe activarse un conjunto de pasos de resolución o de notificaciones adicionales, o si debe crearse un entorno dedicado duplicado para el escaneo.
Con una arquitectura de tipo service mesh (por ejemplo, Istio), es posible crear un
testing gardenduplicando un conjunto de servicios para el escaneo, enrutar el tráfico de escaneo a la nueva malla en función del valor de una cabecera, por ejemplo, y aplicar una cuota para acceder a componentes compartidos como una base de datos o una cola de mensajes.
La orquestación suele ser crítica para los regímenes de cumplimiento normativo, como PCI-DSS o FedRamp. Un pipeline de Autonomous Security completo
puede definir un conjunto de hooks para activar lógica orientada al negocio, como notificar a determinadas personas, actualizar ciertos paneles,
generar ciertos informes, etc.
2.3 Detección
La detección es lo que la mayoría de la gente imagina cuando hablamos de escaneo de seguridad. Por importante que sea, es solo un engranaje dentro de una maquinaria más grande.
Una detección adecuada debe reducir los falsos positivos y negativos y tener en cuenta el contexto para calificar la severidad. Encontrar el equilibrio correcto, adecuado al tamaño de una organización y a la severidad de un entorno, es un equilibrio importante.
Crear un mapa de los tipos de activos que posee una organización y un mapa de cobertura ayuda a identificar las capacidades que faltan. Un mapa simplificado podría ser tan sencillo como:
* Network:
    * IPv4: CHECK
    * IPv6: MISSING

* Web:
    * Known Vulnz: CHECK
    * non-SPA: CHECK
    * SPA: MISSING
    * Authenticated: MISSING

* Mobile:
    * Android: CHECK
    * iOS: CHECK
    * Mobile Backend: CHECK

* Cloud:
    * VM: MISSING
    * Containers: CHECK
    * Serverless: MISSING

 ...
o tan complejo como:
* Web:
    * SQL Injection:
      * Postgrs:
        * WHERE Clause: CHECK
        * FROM Clause: MISSING
        * ORDER Clause: LIMITED
Aunque la detección es un tema MUY amplio, una queja habitual en este ámbito es que los proveedores de seguridad con frecuencia prometen demasiado y cumplen demasiado poco. Este es un buen recurso sobre por qué la industria de la seguridad está fracasando por culpa de una tecnología ineficaz
Todas las soluciones de seguridad pueden dividirse en 2 piezas tecnológicas: un Analysis Engine y un conjunto de Rules. El motor suele ser
lo que toma un programa, un sitio web o una IP y realiza un conjunto de transformaciones o interacciones.
Ejemplos de Analysis Engines:
- Motor de huellas de dependencias: encuentra dependencias y componentes de terceros.
- Motor de taint: genera un grafo de taint orientado a objetos para encontrar el vínculo entre fuentes y sumideros.
- Motor dinámico: recopila trazas de pila, métodos y parámetros.
- Motor de fuzzing: inyecta entradas y recopila el flujo de datos y los informes de fallos.
Las salidas del motor son utilizadas después por las Rules para detectar comportamientos vulnerables. Las reglas suelen ser algo como:
- Si el nombre de la aplicación es
libjpeg, la versión es <2.0.1y tiene BMP habilitado, entonces es vulnerable a corrupción de memoria. - Si se usa una API de cifrado con el modo
ECB, entonces es vulnerable a un modo de cifrado inseguro.
Las
Rulessiempre las han elaborado a mano expertos y normalmente utilizan los resultados de un únicoAnalysis Engine. Debido a la economía y el coste de crearRules, rara vez se detectan vulnerabilidades improbables en frameworks poco comunes, aunque tengan consecuencias graves.
3 Políticas
Las políticas son los principios rectores y establecen el marco para tomar decisiones. Las políticas, cuando han sido validadas por los canales adecuados (CTO, CISO ...), ayudan a las organizaciones a actuar a tiempo y reducen la necesidad de escalados y de discusiones de ida y vuelta.
La política tradicional es la política de aplicación de parches. Define cuándo debe corregirse una vulnerabilidad, en función de su severidad. Por ejemplo, los problemas de severidad alta deben corregirse en el plazo de 1 mes. Si no se corrigen, se puede aplicar el cumplimiento forzoso a los activos vulnerables (véase la sección 4) o escalarse (véase la sección 5).
Le sorprenderá cómo ayuda a acelerar las correcciones mostrar a los directivos un panel con, por ejemplo, los elementos fuera de SLO.
Esta política de aplicación de parches no es suficiente, ya que es reactiva ante los problemas de seguridad y, por definición, siempre llega tarde. Un gran complemento es una política de actualización que exija que el software, las dependencias y las aplicaciones no tengan más de x meses de antigüedad. La política de Black Swan es también otro gran ejemplo: define qué hacer en caso de vulnerabilidades de severidad muy alta que requieren la colaboración urgente de varios equipos.
Las políticas son esenciales, no solo desde el punto de vista de la seguridad, sino también desde el punto de vista operativo. Mantienen la producción sana y evitan que se acumule deuda técnica y de producción.
Muchas organizaciones comparten historias de terror sobre alguna aplicación crítica para producción de la que nadie sabe cómo compilarla o desplegarla y que lleva años sirviendo en producción.
Para lograr un sistema de Autonmous Security completo, se necesita una política de cumplimiento forzoso que defina cómo puede funcionar el cumplimiento forzoso
automatizado, si requiere un humano en el bucle o sobre el bucle, cómo puede hacerse el break glass y qué sistemas son elegibles.
Human-in-the-loop o HITL se define como un modelo que requiere interacción humana. Human-on-the-loop o HOnTL se define como un modelo que está bajo la supervisión de un operador humano que puede anular las acciones. Human-out-the-loop o HOutTL se define como un modelo que no tiene ninguna interacción ni supervisión humana.
4. Contención: corrección y cumplimiento forzoso
La corrección es el bloque más infravalorado y, paradójicamente, el más crítico. La contención es lo que ayuda a corregir las vulnerabilidades o eliminarlas.
La corrección es muy difícil de hacer bien. A menudo es primero un problema de personas y se complica desde tratar de encontrar al propietario adecuado para que lo corrija, pasando por tener los incentivos adecuados para que las cosas se corrijan, encontrar el canal de comunicación adecuado para notificar y hacer el seguimiento de las correcciones, hasta, por último, tener una forma de verificar que una vulnerabilidad se ha corregido correctamente.
La nube ofrece excelentes herramientas para ayudar a cualificar las correcciones sin afectar al flujo de producción; herramientas como Terraform para duplicar proyectos completos, o service meshes como Istio para hacer despliegues canary, son de gran ayuda para resolver estos problemas.
El cumplimiento forzoso es la cúspide de un sistema Autonomous Security: ayuda a evitar que las vulnerabilidades
se vayan colando poco a poco en su sistema y es un gran incentivo para que los equipos de desarrollo y de operaciones
aceleren las correcciones.
El cumplimiento forzoso debe, sin embargo, tener en cuenta la importancia de hacer fiable primero la producción y de ofrecer medios verificables y trazables para el break glass cuando sea necesario. El cumplimiento forzoso no puede hacerse sin el respaldo de la dirección y es mejor empezar poco a poco, aplicándolo a sistemas experimentales expuestos a internet, después a sistemas internos y, por último, a sistemas de producción no críticos.
El cumplimiento forzoso puede empezar con un humano en el bucle, que dé luz verde a las acciones, y pasar después por un humano sobre el bucle, que simplemente revise las acciones ya realizadas.
La nube ofrece herramientas para aplicar despliegues seguros y recuperarse de compromisos, con herramientas como TUF y Notary.
5. Paneles y métricas
Los Dashboard y las Metrics son una parte crítica de un sistema de seguridad autónoma. Miden la salud de un sistema, ofrecen
una forma medible de calcular el retorno de la inversión y pueden ayudar a impulsar acciones estratégicas con decisiones informadas y respaldadas
por datos.
Los Dashboards ayudan a proporcionar a las personas adecuadas la cantidad adecuada de información para tomar decisiones informadas
y priorizar acciones. Tener la capacidad de entender su postura, cómo están mejorando las cosas (o no) y
medir cuantitativamente dónde faltan cosas es precisamente lo que a menudo falta en seguridad.
Los Dashboards se alimentan en parte de las Metrics, que ayudan a identificar tendencias, a medir y prevenir el deterioro lento, así como a
medir el progreso y el retorno de la inversión.
Los paneles a nivel de toda la organización que enumeran, por ejemplo, el número de vulnerabilidades por unidad de negocio o por equipo son eficaces para incentivar la acción. Le sorprenderá comprobar que nadie quiere estar en la parte baja de la clasificación y que las tablas de posiciones pueden fomentar una competencia sana.
El panel debe adaptarse a cada usuario de forma que ayude a tomar decisiones accionables. Por ejemplo, el panel de los equipos de seguridad se centrará, por ejemplo, en la severidad y el volumen de las vulnerabilidades; el panel de los directivos de nivel C se centrará en la salud global, el estado de la organización de negocio y los problemas más urgentes; y el panel de los desarrolladores se centrará en el código que poseen o en el que trabajan.
El panel debe ofrecer una vista útil para extraer conclusiones respaldadas por datos y tomar decisiones informadas.
¿Qué viene a continuación?
Ostorlab se creó para proporcionar las herramientas que faciliten la integración de una solución de Autonomous Security
en cualquier organización. Esto empieza por integrarse con tiendas especializadas y API de inventario, proporcionar herramientas técnicas de descubrimiento eficaces
(como las tiendas de Android e iOS para las aplicaciones móviles), centrarse en la detección de vulnerabilidades de severidad alta con un alto grado de confianza
(como las dependencias obsoletas y la fuga de secretos) y facilitar la creación de reglas de monitorización.
Para mantenerse al día de las últimas novedades, suscríbase a nuestro boletín mensual.
Etiquetas:
security