借助 DalvikFLIRT 与 LLM 实现 Android 反混淆
本研究提出一种开创性的双重方法,将基于签名的匹配(DalvikFLIRT)与 LLM 驱动的代码转换相结合,以绕过复杂的 Android 应用代码混淆,从而对以往难以分析的代码进行自动化安全分析。
1. 了解 Android 应用代码混淆
在 Android 生态系统中,代码混淆是应用开发者的一项重要防御机制,用于保护知识产权和敏感代码免遭逆向工程。通过提高逆向工程的难度,它能够阻挡随意尝试的攻击者。
尽管代码混淆是一种加固措施,但它也给试图识别漏洞的安全研究人员带来了巨大挑战。我们之所以研究这一课题,是因为我们正在推动 Ostorlab 的自动化能力超越技术漏洞研究,迈向逻辑漏洞发现的自动化。
代码混淆会把清晰易读的代码转换为刻意复杂、晦涩的版本,同时保留其功能。当开发者对代码进行混淆时,本质上是在保留语法正确性的同时移除语义含义——代码仍然可以运行,但几乎无法理解。
来看一个简单的例子:
// Original code
public void validateUserCredentials(String username, String password) {
    if (isValidUsername(username) && isCorrectPassword(password)) {
        grantAccess();
    } else {
        denyAccess();
    }
}

// Obfuscated code
public void a(String b, String c) {
    if (d(b) && e(c)) {
        f();
    } else {
        g();
    }
}
虽然两者功能完全相同,但混淆后的版本掩盖了代码的目的和逻辑,使其在安全分析中难以理解。
现代 Android 代码混淆涉及多种技术和工具:
- ProGuard 是传统的开源工具,多年来一直集成在 Android 构建流程中,提供基本的名称混淆和代码压缩。
- R8 是 Google 推出的用于取代 ProGuard 的现代工具,提供更强的优化能力,并与 Android 构建系统无缝集成,如今已成为 Android Studio 的默认编译器。
对于需要更强保护的应用,商业工具可能会提供更高级的功能,包括字符串加密、控制流混淆和反调试措施。
2. 代码混淆在 Android 生态系统中的普及程度
代码混淆在 Android 应用中的使用非常普遍且仍在增长,尤其是在高价值应用和处理敏感数据的应用中。
论文《A Large Scale Investigation of Obfuscation Use in Google Play》(2018 年)发现,约 25% 的 Android 应用采用了某种形式的代码混淆。该研究分析了 1,700,000 款免费 Android 应用,并发现如果只关注最热门的应用,这一比例会跃升至约 50%。
一篇较新的论文(2025 年 2 月,《An Empirical Study of Code Obfuscation Practices in Android Apps》)记录了 2016 年至 2023 年间代码混淆采用率增长了 13%,其中头部开发者在此期间的增幅尤为显著,达到 28%。我们的分析显示代码混淆的采用率显著上升,覆盖了近 62% 的受测应用。
代码混淆的普及程度在不同应用类别之间差异很大。金融和银行应用几乎全部采用了代码混淆;游戏应用经常使用激进的代码混淆来保护变现算法和反作弊机制;企业应用则采取适度的保护策略来保护专有业务逻辑。社交媒体平台也越来越多地采用复杂的代码混淆来保护用户数据处理机制。
ProGuard/R8 由于与 Android Studio 集成且零成本,仍然是使用最广泛的解决方案。不过,商业解决方案在高价值应用中也占有重要地位。在处理特别敏感数据的应用(例如金融服务和医疗健康应用)中,定制的代码混淆方案也越来越常见。
3. 代码混淆对安全分析的影响
代码混淆给人工和自动化安全分析都带来了重大挑战,形成了一种耐人寻味的安全悖论。
对于审查代码的人工分析师来说,代码混淆移除了通常有助于理解的所有上下文线索。没有有意义的名称,研究人员必须费力地追踪执行路径,才能弄清每个函数的作用。以一款银行应用的身份验证系统为例——通常可能被识别为 verifyUserCredentials() 的方法变成了简单的 LIZIZI(),其安全关键属性被隐藏了起来。
控制流被刻意弄得错综复杂,加入了额外的跳转、条件分支和不必要的间接调用。可能提示功能的字符串常量被加密,组件之间的关系也变得几乎无法辨识。
在未混淆的代码中只需几个小时就能理清的身份验证流程,安全研究人员可能需要花费数天甚至数周才能破解。
自动化分析工具受到的影响更为严重。污点分析系统会跟踪数据如何从敏感的源(例如用户输入)流向危险的汇聚点(例如 SQL 查询)。在检查 SQL 注入时,工具通常会将 executeQuery() 之类的方法识别为潜在的汇聚点。而经过代码混淆后,这些方法变得无法识别——LIIZZ() 可能是从日志记录到数据库访问的任何操作。这从根本上破坏了这些工具的核心机制。
例如,一种常见的安全分析模式是识别访问敏感系统资源的方法。来看这段访问位置信息的代码:
// Original code
LocationManager locationManager = (LocationManager) getSystemService(Context.LOCATION_SERVICE);
Location location = locationManager.getLastKnownLocation(LocationManager.GPS_PROVIDER);

// Obfuscated version
Object a = b(c.d);
Object e = ((f) a).g(f.h);
寻找位置访问模式的自动化工具会完全错过混淆后的版本,从而可能忽视隐私问题。
同样,模糊测试工具需要了解哪些输入会影响安全关键路径,而代码混淆隐藏了这些关系。当已知漏洞模式被代码混淆改变后,基于匹配这些模式的静态分析系统也会失效。
这造成了一种自相矛盾的安全局面。代码混淆能有效阻挡资源有限的随意攻击者,但同时也妨碍了正当的安全分析。组织可能会误以为代码混淆已经消除了漏洞,而实际上它只是隐藏了漏洞。安全审计的成本和耗时大幅增加,有时甚至导致企业降低审计频率或缩小审计范围。
4. 用 DalvikFLIRT 击败代码混淆
4.1 了解 FLIRT 技术
FLIRT(Fast Library Identification and Recognition Technology,快速库识别技术)是一种新颖的代码分析方法,最初是为 IDA Pro 等工具中的原生二进制分析而开发的。FLIRT 的核心能力在于,无论函数如何命名,都能在编译后的代码中识别出标准函数。
该技术基于代码模式创建独特的签名,而不是依赖函数名等容易更改的标识符。这些签名捕获了函数的本质结构和行为,使其能够抵御基本的代码混淆技术。
传统上,FLIRT 主要用于原生代码(C/C++)分析,帮助识别编译后二进制文件中的标准库函数。FLIRT 签名封装了每个函数的多项独特特征,形成一个即使名称和简单代码模式被修改后仍可识别的指纹。
                Original Function              |             Obfuscated Function
                 ----------------              |             -------------------
Function name:   strcmp                        |  Function name:   fn_0x3A72
Signature:       [Pattern of bytes/opcodes]    |  Signature:       [Identical pattern]
Parameters:      2 string pointers             |  Parameters:      2 string pointers
Structure:       Loop comparing characters     |  Structure:       Loop comparing characters
Return:          Integer (0 if equal)          |  Return:          Integer (0 if equal)
4.2 可用于基于签名识别的 Dalvik 特性
Dalvik 字节码是 Android 应用所使用的格式,它为基于签名的识别提供了不同于传统二进制分析的独特机会。即使经过激进的名称混淆,方法和字段之间的结构关系通常仍然保持不变,因为改变它们会破坏功能。
方法签名(参数类型和返回值)必须保留,以维持与 Android 框架及其他组件的兼容性。访问修饰符(public、private、protected)通常无法在不改变应用行为的情况下修改,继承关系也往往保持不变以保留功能。
在某些情况下,源文件名和行号等调试信息可能会被保留,从而提供额外的识别点。最重要的是,对 Android 框架 API 的调用必须保持一致,这会形成可识别的模式,作为分析的锚点。
这些持久存在的特性为专门针对 Dalvik 环境定制的、类似 FLIRT 的签名匹配创造了机会。
###### Class android.support.v7.internal.app.AppCompatViewInflater (android.support.v7.internal.app.AppCompatViewInflater)
.class public Landroid/support/v7/internal/app/AppCompatViewInflater;
.super Ljava/lang/Object;
.source "AppCompatViewInflater.java"


# static fields
.field private static final LOG_TAG:Ljava/lang/String; = "AppCompatViewInflater"

.field private static final sConstructorMap:Ljava/util/Map;
    .annotation system Ldalvik/annotation/Signature;
        value = {
            "Ljava/util/Map",
            "<",
            "Ljava/lang/String;",
            "Ljava/lang/reflect/Constructor",
            "<+",
            "Landroid/view/View;",
            ">;>;"
        }
    .end annotation
.end field

.field static final sConstructorSignature:[Ljava/lang/Class;
    .annotation system Ldalvik/annotation/Signature;
        value = {
            "[",
            "Ljava/lang/Class",
            "<*>;"
        }
    .end annotation
.end field


# instance fields
.field private final mConstructorArgs:[Ljava/lang/Object;

.method private createView(Landroid/content/Context;Ljava/lang/String;Ljava/lang/String;)Landroid/view/View;
    .registers 9
    .param p1, "context"    # Landroid/content/Context;
    .param p2, "name"    # Ljava/lang/String;
    .param p3, "prefix"    # Ljava/lang/String;
    .annotation system Ldalvik/annotation/Throws;
        value = {
            Ljava/lang/ClassNotFoundException;,
            Landroid/view/InflateException;
        }
    .end annotation

    .prologue
    .line 143
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorMap:Ljava/util/Map;

    invoke-interface {v3, p2}, Ljava/util/Map;->get(Ljava/lang/Object;)Ljava/lang/Object;

    move-result-object v1

    check-cast v1, Ljava/lang/reflect/Constructor;

    .line 146
    .local v1, "constructor":Ljava/lang/reflect/Constructor;, "Ljava/lang/reflect/Constructor<+Landroid/view/View;>;"
    if-nez v1, :cond_36

    .line 148
    :try_start_a
    invoke-virtual {p1}, Landroid/content/Context;->getClassLoader()Ljava/lang/ClassLoader;

    move-result-object v4

    if-eqz p3, :cond_43

    new-instance v3, Ljava/lang/StringBuilder;

    invoke-direct {v3}, Ljava/lang/StringBuilder;-><init>()V

    invoke-virtual {v3, p3}, Ljava/lang/StringBuilder;->append(Ljava/lang/String;)Ljava/lang/StringBuilder;

    move-result-object v3

    invoke-virtual {v3, p2}, Ljava/lang/StringBuilder;->append(Ljava/lang/String;)Ljava/lang/StringBuilder;

    move-result-object v3

    invoke-virtual {v3}, Ljava/lang/StringBuilder;->toString()Ljava/lang/String;

    move-result-object v3

    :goto_21
    invoke-virtual {v4, v3}, Ljava/lang/ClassLoader;->loadClass(Ljava/lang/String;)Ljava/lang/Class;

    move-result-object v3

    const-class v4, Landroid/view/View;

    invoke-virtual {v3, v4}, Ljava/lang/Class;->asSubclass(Ljava/lang/Class;)Ljava/lang/Class;

    move-result-object v0

    .line 151
    .local v0, "clazz":Ljava/lang/Class;, "Ljava/lang/Class<+Landroid/view/View;>;"
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorSignature:[Ljava/lang/Class;

    invoke-virtual {v0, v3}, Ljava/lang/Class;->getConstructor([Ljava/lang/Class;)Ljava/lang/reflect/Constructor;

    move-result-object v1

    .line 152
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorMap:Ljava/util/Map;

    invoke-interface {v3, p2, v1}, Ljava/util/Map;->put(Ljava/lang/Object;Ljava/lang/Object;)Ljava/lang/Object;

    .line 154
    .end local v0    # "clazz":Ljava/lang/Class;, "Ljava/lang/Class<+Landroid/view/View;>;"
    :cond_36
    const/4 v3, 0x1

    invoke-virtual {v1, v3}, Ljava/lang/reflect/Constructor;->setAccessible(Z)V

    .line 155
    iget-object v3, p0, Landroid/support/v7/internal/app/AppCompatViewInflater;->mConstructorArgs:[Ljava/lang/Object;

    invoke-virtual {v1, v3}, Ljava/lang/reflect/Constructor;->newInstance([Ljava/lang/Object;)Ljava/lang/Object;

    move-result-object v3

    check-cast v3, Landroid/view/View;
    :try_end_42
    .catch Ljava/lang/Exception; {:try_start_a .. :try_end_42} :catch_45

    .line 159
    :goto_42
    return-object v3

    :cond_43
    move-object v3, p2

    .line 148
    goto :goto_21

    .line 156
    :catch_45
    move-exception v2

    .line 159
    .local v2, "e":Ljava/lang/Exception;
    const/4 v3, 0x0

    goto :goto_42
.end method
了解典型的 Android 代码混淆模式对于有效地开发签名至关重要。最普遍的技术是标识符重命名,即为类、方法和字段赋予无意义的名称,例如单个字母或随机字符串。
5. DalvikFLIRT 的工作原理
DalvikFLIRT 将签名匹配的概念应用于 Android 生态系统,并针对 Dalvik 字节码的特点做了重要调整。
5.1 生成类的签名
DalvikFLIRT 通过收集大量属性来为类生成签名。每个类签名包括结构信息(名称、父类、访问标志、接口)、可用时的源代码元数据、字段及其类型和修饰符、来自字段和方法的字符串常量,以及每个方法的详细签名。系统还会计算一个唯一的指纹哈希,综合了该类最具辨识度的特征。
方法的签名则更为详细,涵盖方法描述符、访问标志、字节码哈希、指令数量、API 调用、常量、操作码分布以及控制流图特征。
这种多维度的方法生成了丰富的签名,同时捕获结构和行为属性,即使经过代码混淆也依然可以识别。
{
  "classes": {
    "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;": {
      "name": "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;",
      "superclass": "Lkotlin/jvm/internal/Lambda;",
      "access_flags": 16,
      "interfaces": [
        "Lkotlin/jvm/functions/Function3;"
      ],
      "source_file": null,
      "fingerprint": "2f1b337d2e6092b6775b2c9059222361",
      "fields": [
        {
          "name": "INSTANCE",
          "type": "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;",
          "access_flags": 25
        }
      ],
      "field_strings": [],
      "string_constants": [
        "innerPadding",
        "com.example.myapplication.ComposableSingletons$MainActivityKt.lambda-1.<anonymous> (MainActivity.kt:22)",
        "Android",
        "C22@889L139:MainActivity.kt#ptgicz"
      ],
      "methods": {
        "<clinit>()V": {
          "name": "<clinit>",
          "descriptor": "()V",
          "access_flags": 65544,
          "bytecode_hash": "2552c2aefad67c2d666996fc73085a74",
          "instruction_count": 4,
          "api_calls": [
            21
          ],
          "constants": [],
          "opcode_distribution": {
            "34": 1,
            "112": 1,
            "105": 1,
            "14": 1
          },
          "cfg": {
            "basic_blocks": 1,
            "edges": 0,
            "exception_handlers": 0
          },
          "registers": 1
        },
        "<init>()V": {
          "name": "<init>",
          "descriptor": "()V",
          "access_flags": 65536,
          "bytecode_hash": "0e486b2e5a245ee4b0e601cc7ddbbce9",
          "instruction_count": 3,
          "api_calls": [
            61
          ],
          "constants": [
            [
              "numeric",
              3
            ]
          ],
          "opcode_distribution": {
            "18": 1,
            "112": 1,
            "14": 1
          },
          "cfg": {
            "basic_blocks": 1,
            "edges": 0,
            "exception_handlers": 0
          },
5.2 计算相似度指标
在将混淆后的类与签名数据库进行比较时,DalvikFLIRT 采用加权相似度计算。不同组件根据其对代码混淆的抵抗能力,对总分做出不同的贡献:
METHOD_WEIGHTS = {
    "bytecode_hash": 0.0,
    "descriptor": 0.25,
    "constants": 0.25,
    "opcode_distribution": 0.3,
    "cfg": 0.2,
}

CLASS_WEIGHTS = {
    "metrics": 0.2,
    "superclass": 0.1,
    "interfaces": 0.1,
    "fields": 0.1,
    "methods": 0.5,
}
方法描述符的可靠性很高,因为参数类型和返回值很少会在不破坏功能的情况下发生变化。字符串常量往往能在基本的代码混淆中保留下来,提供语义线索。操作码分布形成了方法行为的统计指纹,而控制流图结构则反映了为保证正确运行而必须保留的逻辑模式。
在类层面,类指标(例如方法和字段数量)、继承关系以及接口实现都有助于识别。加权方法意味着,只要保留了足够多的独特特征,即使某些方面发生了变化,DalvikFLIRT 也能识别出匹配项。

5.3 工具实战
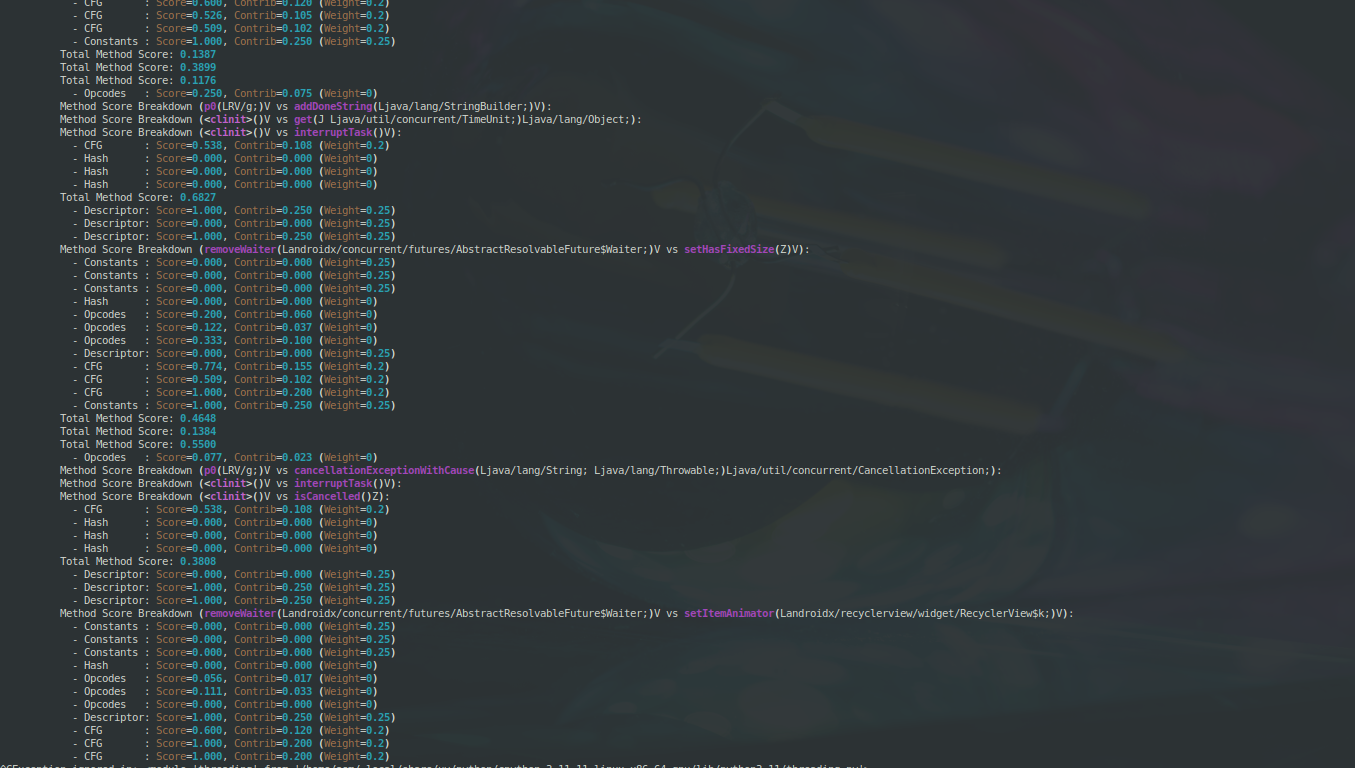
在真实环境的测试中,我们将 DalvikFLIRT 应用于多款热门应用,其中一些应用的类数量超过 250,000 个。以下输出展示了一个匹配示例:
DalvikFLIRT Simplified Signature Matcher
Signatures1: tests/files/app-debug_signatures.json
Signatures2: tests/files/Media_APKPure_signatures.json
Output: matches_media.json
Threshold: 0.8

Loading signatures from tests/files/app-debug_signatures.json
Loaded 12288 class signatures
Loading signatures from tests/files/media_APKPure_signatures.json
Loaded 279796 class signatures
匹配器识别出混淆后的类 LX/i7X 对应于 Landroidx/concurrent/futures/AbstractResolvableFuture,置信度为 83.9%:
Class Score Breakdown (LX/i7X; vs Landroidx/concurrent/futures/AbstractResolvableFuture;):
  - Metrics     : Score=0.451, Contrib=0.090 (Weight=0.2)
  - Superclass  : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Interfaces  : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Fields      : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Methods     : Score=0.898, Contrib=0.449 (Weight=0.5)
Total Class Score: 0.8390
即使名称被完全混淆,这种识别依然有效。例如,原始代码中名为 addListener 的方法在混淆版本中被重命名为 LIZJ(Ljava/lang/Runnable; Ljava/util/concurrent/Executor;)V。DalvikFLIRT 根据它们的参数类型、控制流和操作码模式正确地匹配了二者。
6. 其余代码怎么办:LLM 驱动的代码重写
虽然 DalvikFLIRT 擅长匹配来自 Android SDK 和常用库的已知组件,但对于没有已知参考签名的自定义应用代码,它就无能为力了。这正是我们借助大语言模型(LLM)的能力提供互补方法的地方。
6.1 LLM 驱动的重写器
现代大语言模型凭借从海量代码仓库中学到的模式,具备出色的代码理解、生成和转换能力。我们发现,这些 LLM 能够通过从上下文和结构中推断含义,有效还原多种类型的代码混淆。
我们方法的关键洞察在于重新定义问题。我们不要求模型对代码进行“反混淆”(出于对潜在滥用的担忧,许多模型会拒绝这样做),而是将任务表述为“提高代码可读性”——这是一个细微但重要的区别,使模型愿意处理该任务:
deobfuscator_agent = Agent(
    large_model,
    system_prompt=(
        "You are an expert Java developer. Given hard to read Java source code, "
        "your task is to: \n"
        "Rewrite the code to make it more readable.\n"
        "Please make sure to rewrite the whole code and DO NOT omit any function or method.\n"
        "Improve the quality of the code. Focus on renaming variables, methods, "
        "and classes to be more descriptive names based on their context and usage. "
        "Maintain the original code's functionality. If no context is provided, "
        "do your best to rewrite based on the code alone."
        "Feel free to rewrite control flow to make the code easier to understand."
        "Do NOT change string constants as these might be used by other apps."
    ),
)
6.2 多智能体系统
我们的实现采用一个协同工作的多智能体系统,各专用组件协作,逐步加深对代码的理解:
- 反混淆智能体(Deobfuscation Agent)在保留功能的前提下重写混淆代码以提高清晰度,重点是提供有意义的名称并简化复杂的控制结构。
- 解释智能体(Explainer Agent)用通俗的语言描述代码的作用,识别输入、输出和关键行为。这有助于为进一步分析提供上下文。
上下文构建智能体(Context-Building Agent)整合已识别组件(例如由 DalvikFLIRT 匹配出的组件)中的信息,为未知部分的分析提供依据。
这些智能体并非各自独立运行,而是相互共享信息,形成一个反馈循环,随着处理的代码越来越多,理解也逐步加深。
# Initialize the AI agent for deobfuscation
deobfuscator_agent = Agent(
    # model,
    large_model,
    system_prompt=(
        "You are an expert Java developer. Given an hard to read Java source code, "
        "your task is to: \n"
        "Rewrite the code to make it more readable.\n"
        "Please make sure to rewrite the whole code and DO NOT omit any function or method.\n"
        "and improve the quality of the code. Focus on renaming variables, methods, "
        "and classes to more descriptive names based on their context and usage."
        "DO NOT keep short or cryptic variable, classes and method names. "
        "Maintain the original code's functionality. If no context is provided, "
        "do your best to rewrite based on the code alone."
        "Feel free to rewrite control flow to make the code easier to understand."
        "Do NOT change string constant as these might be used by other apps."
    ),
)

# Initialize the AI agent for code explanation
code_explainer = Agent(
    model,
    system_prompt=(
        "You are an expert code explainer. Analyze the provided source code and explain it in plain English. "
        "Be thorough and cover: \n"
        "1. The code's purpose and functionality\n"
        "2. Inputs it expects\n"
        "3. Outputs it produces\n"
        "4. Edge cases and error handling\n"
        "Use clear, simple language suitable for developers of all levels."
    ),
    result_type=CodeExplanation,
)
6.3 为获得最佳结果而进行的提示词工程
我们基于 LLM 的方法的有效性在很大程度上取决于精心设计的提示词。我们开发了几种能够稳定产生更好结果的技巧:
我们不直接提及“混淆”或“反混淆”,而是将任务表述为提高“难以阅读”的代码的可读性。这一细微的转变可以避免触发模型中的安全过滤机制。
我们提供来自 Java 和 Kotlin API、未混淆的库以及 DalvikFLIRT 已识别组件的上下文作为参考点。例如,如果我们知道应用调用了某个已识别的加密方法,这一信息就能帮助 LLM 正确解读周围的代码。
我们的流程从依赖较少的简单方法入手,然后逐步处理更复杂的组件。这使 LLM 能够逐步构建上下文,利用先前分析得到的信息为后续分析提供依据。
清晰地说明需要保留什么(功能)以及需要改进什么(名称、结构),有助于引导模型进行有用的转换,而不仅仅是重新格式化。
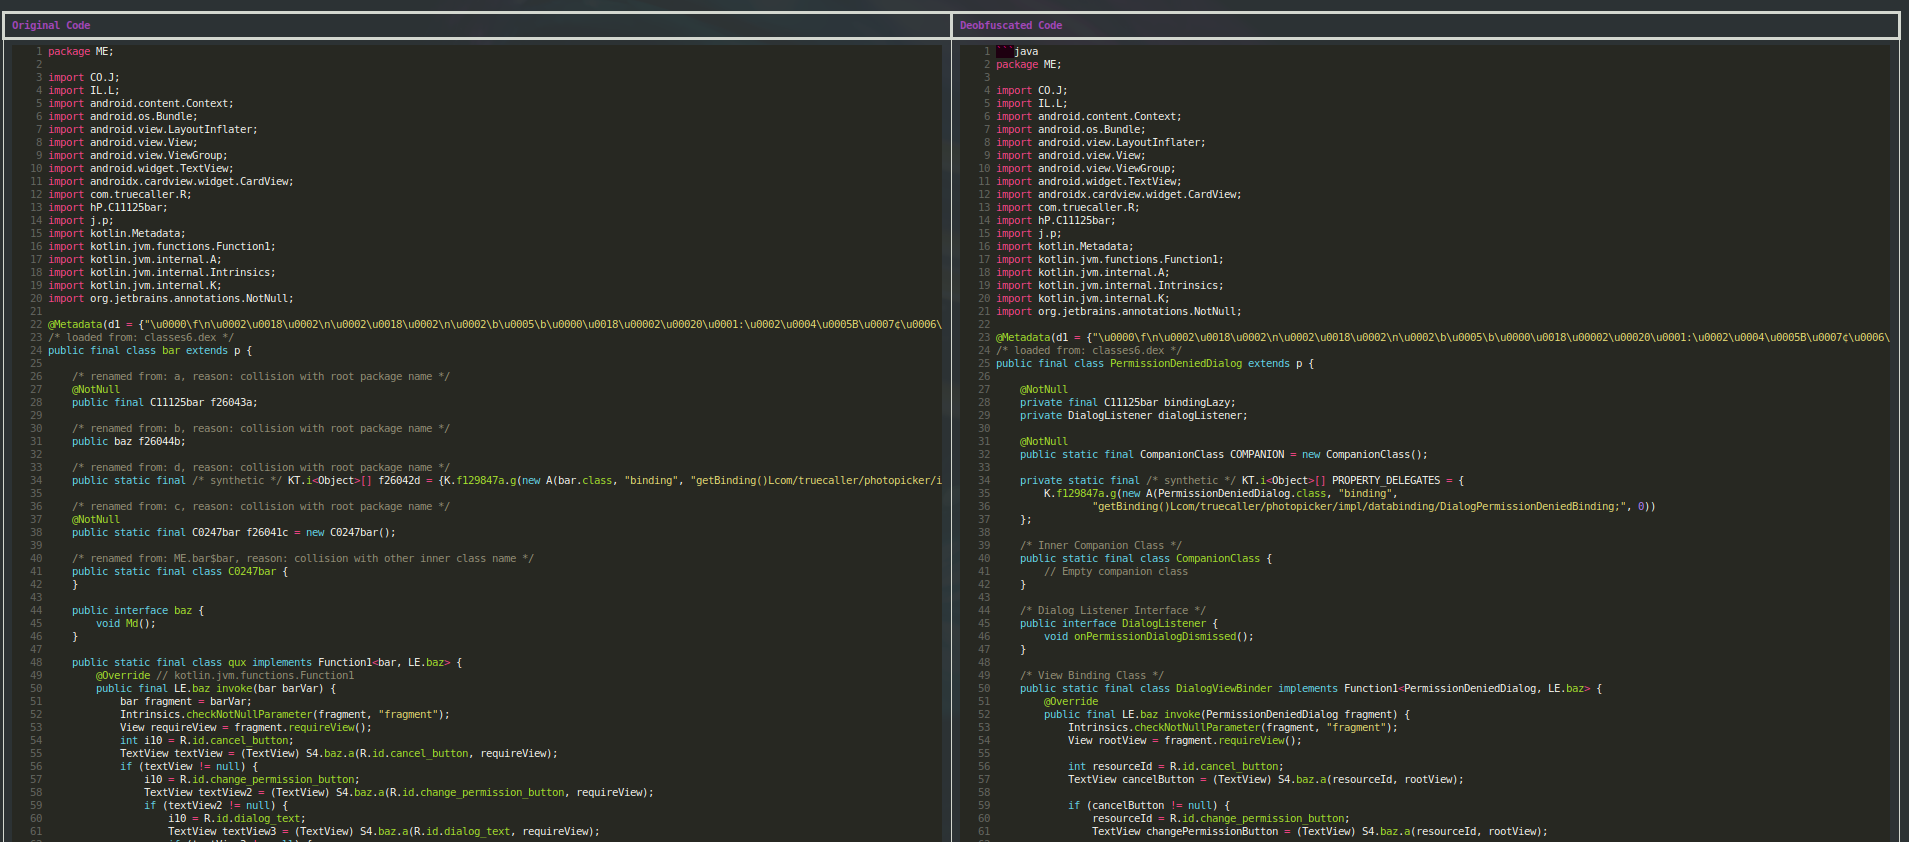
以下示例展示了我们的系统所能达到的效果:
// Original obfuscated code
public static void a(long j, String str, int i, Object obj) {
    if (obj != null && c.e(str) && i >= 0) {
        new Thread(new d(j, str, i, obj)).start();
    }
}

// LLM-deobfuscated code
public static void logEventAsync(long userId, String eventName, int eventType, Object eventData) {
    if (eventData != null && ValidationUtils.isValidEventName(eventName) && eventType >= 0) {
        new Thread(new EventLoggingTask(userId, eventName, eventType, eventData)).start();
    }
}
反混淆后的版本不仅提供了揭示方法用途的有意义名称,还根据组件类的使用方式推断出它们可能的含义。
6.4 递归式自底向上分析
我们发现,将 DalvikFLIRT 的签名匹配与 LLM 驱动的重写相结合,在递归式自底向上的方法中效果最好。具体流程如下:
首先,我们构建一张完整的调用图,展示应用中所有方法之间的相互关系。这一映射揭示了哪些方法调用了哪些其他方法,从而形成依赖层级。
然后,我们识别出“叶子方法”——即不调用其他方法的方法。这些较简单的函数依赖较少,是理想的分析起点。
在完成第一批方法的反混淆之后(一部分通过 DalvikFLIRT 签名匹配,另一部分通过 LLM 分析),我们沿调用树向上,处理那些使用这些已被理解的函数的方法。先前分析过的方法为理解这些更高层函数的作用提供了宝贵的上下文。
随着我们沿调用树不断向上,我们对应用行为的理解也逐步丰富。每个新方法都能受益于它所调用的、所有先前已分析方法的上下文。
可以把这个过程想象成考古学——我们先从理解最简单的文物开始,再利用这些知识来解读更复杂的文物,自下而上地逐步重建整个文明。
以下代码展示了在这一具备上下文感知能力的系统中如何分析一个方法:
def analyze_method(self, node: MethodNode) -> Dict:
    """
    Perform full AI analysis on a method including explanation, deobfuscation and security audit.
    """
    # Get source code
    class_source_code = self.methods_engine.get_class_source(node)
    method_source_code = self.methods_engine.get_method_source(node)

    # Get context from callees (methods this one calls)
    callee_info = self.methods_engine.get_callees(node)

    # Deobfuscate the code using both DalvikFLIRT and LLM approaches
    deobfuscated_code = self.deobfuscate_code(
        class_source_code,
        method_source_code,
        context=callee_info
    )

    # Generate a human-readable explanation
    explanation = self.explain_code(deobfuscated_code, node)

    # Store results for use as context in analyzing methods that call this one
    return {
        'source_code': method_source_code,
        'deobfuscated_code': deobfuscated_code,
        'explanation': explanation,
        'security_issues': security_audit,
    }
通过结合这些技术——针对已知组件的 DalvikFLIRT 基于签名的识别,以及针对自定义应用逻辑的 LLM 驱动代码重写——我们构建了一个即使面对高度保护的 Android 应用也能有效进行反混淆的系统。
结论与未来方向
我们将 DalvikFLIRT 基于签名的识别与 LLM 驱动的重写相结合的双重方法,构建了一个能够绕过 Android 应用代码混淆的强大系统。这一方法赋予了我们前所未有的能力,去理解原本难以分析的代码。
我们方法的核心优势在于,能够以高置信度自动识别 Android SDK 组件,然后将它们作为上下文锚点,为应用特定的逻辑生成高质量代码。该系统可以同时应对多种代码混淆技术,从简单的名称混淆到更复杂的控制流操纵。
自底向上的递归方法意味着,系统分析的代码越多,效果就越好,每一项新的洞察都会改进后续的分析。
这项工作并非为了削弱安全性,而是为了提升自动化能力。通过让混淆后的代码变得可以理解,我们能够进行更彻底的安全分析和漏洞检测。
标签:
ai