Desofuscación de Android con DalvikFLIRT y LLM
Esta investigación presenta un enfoque dual pionero que combina la coincidencia basada en firmas (DalvikFLIRT) con la transformación de código mediante LLM para eludir la ofuscación sofisticada de aplicaciones Android, lo que permite el análisis de seguridad automatizado de código antes impenetrable.
1. Comprender la ofuscación de aplicaciones Android
En el ecosistema Android, la ofuscación es un mecanismo de defensa importante para los desarrolladores de aplicaciones, ya que protege la propiedad intelectual y el código sensible frente a los intentos de ingeniería inversa. Al dificultar la ingeniería inversa, supone un obstáculo para los atacantes ocasionales.
Aunque es una medida de bastionado, la ofuscación plantea retos considerables a los investigadores de seguridad que intentan identificar vulnerabilidades. Decidimos investigar este tema porque estamos impulsando la automatización de Ostorlab para que vaya más allá de la investigación de vulnerabilidades técnicas y alcance la automatización del descubrimiento de vulnerabilidades lógicas.
La ofuscación transforma un código claro y legible en versiones deliberadamente complejas y crípticas, preservando la funcionalidad. Cuando los desarrolladores ofuscan su código, esencialmente eliminan el significado semántico y conservan la corrección sintáctica - el código sigue funcionando, pero se vuelve casi imposible de entender.
Consideremos este sencillo ejemplo:
// Original code
public void validateUserCredentials(String username, String password) {
    if (isValidUsername(username) && isCorrectPassword(password)) {
        grantAccess();
    } else {
        denyAccess();
    }
}

// Obfuscated code
public void a(String b, String c) {
    if (d(b) && e(c)) {
        f();
    } else {
        g();
    }
}
Aunque son funcionalmente idénticas, la versión ofuscada oculta el propósito y la lógica del código, lo que dificulta su comprensión durante el análisis de seguridad.
La ofuscación moderna de Android implica varias técnicas y herramientas:
- ProGuard, la herramienta tradicional de código abierto, se integra en las compilaciones de Android desde hace años y ofrece ofuscación básica de nombres y reducción de código.
- R8, el sustituto moderno de ProGuard creado por Google, ofrece mayores capacidades de optimización y una integración fluida con el sistema de compilación de Android; hoy es el compilador predeterminado en Android Studio.
Para las aplicaciones que requieren una protección más sólida, las herramientas comerciales pueden ofrecer funciones más avanzadas, como el cifrado de cadenas, la ofuscación del flujo de control y medidas de antidepuración.
2. Prevalencia de la ofuscación en el ecosistema Android
El uso de la ofuscación en las aplicaciones Android está muy extendido y va en aumento, en particular entre las aplicaciones de alto valor y las que manejan datos sensibles.
La investigación «A Large Scale Investigation of Obfuscation Use in Google Play» (2018) concluyó que aproximadamente el 25% de todas las aplicaciones Android emplean alguna forma de ofuscación. El estudio analizó 1.7 millones de aplicaciones Android gratuitas y descubrió que, al centrarse solo en las aplicaciones más populares, esta cifra se dispara hasta alrededor del 50%.
Un artículo más reciente (febrero de 2025, «An Empirical Study of Code Obfuscation Practices in Android Apps») documentó un aumento del 13% en la adopción de la ofuscación entre 2016 y 2023, con un incremento especialmente significativo del 28% entre los principales desarrolladores durante ese periodo. Nuestro análisis muestra un aumento significativo en la adopción de la ofuscación, que abarca casi el 62% de las aplicaciones probadas.
La prevalencia de la ofuscación varía considerablemente entre categorías de aplicaciones. Las aplicaciones financieras y bancarias muestran una adopción casi universal, las aplicaciones de juegos emplean con frecuencia una ofuscación agresiva para proteger los algoritmos de monetización y los mecanismos anti-trampas, y las aplicaciones empresariales aplican estrategias de protección moderadas para salvaguardar la lógica de negocio propietaria. Las plataformas de redes sociales adoptan cada vez más una ofuscación sofisticada para proteger los mecanismos de tratamiento de datos de los usuarios.
ProGuard/R8 sigue siendo la solución más utilizada por su integración con Android Studio y su coste nulo. Sin embargo, las soluciones comerciales tienen una fuerte presencia en las aplicaciones de alto valor. Las soluciones de ofuscación personalizadas son cada vez más habituales en las aplicaciones que manejan datos especialmente sensibles, como las de servicios financieros y sanitarios.
3. Efecto de la ofuscación en el análisis de seguridad
La ofuscación plantea retos sustanciales tanto para el análisis de seguridad manual como para el automatizado, y crea una interesante paradoja de seguridad.
Para los analistas humanos que examinan el código, la ofuscación elimina todas las pistas contextuales que normalmente facilitan la comprensión. Sin nombres significativos, los investigadores deben rastrear minuciosamente las rutas de ejecución para entender qué hace cada función. Consideremos el sistema de autenticación de una aplicación bancaria - lo que normalmente se identificaría como verifyUserCredentials() pasa a ser simplemente LIZIZI(), lo que oculta su carácter crítico para la seguridad.
El flujo de control se complica deliberadamente, con saltos adicionales, ramas condicionales e indirecciones innecesarias. Las constantes de cadena que podrían dar pistas sobre la funcionalidad se cifran, y las relaciones entre componentes se vuelven casi imposibles de discernir.
Un investigador de seguridad puede dedicar días, si no semanas, a descifrar un flujo de autenticación que en código sin ofuscar llevaría horas.
Las herramientas de análisis automatizado sufren aún más. Los sistemas de análisis de taint rastrean cómo fluyen los datos desde fuentes sensibles (como la entrada del usuario) hasta sumideros peligrosos (como las consultas SQL). Al examinar una inyección SQL, una herramienta suele identificar métodos como executeQuery() como posibles puntos sumidero. Con la ofuscación, esos métodos se vuelven irreconocibles - LIIZZ() podría ser cualquier cosa, desde un registro hasta un acceso a base de datos. Esto rompe de raíz el mecanismo central de estas herramientas.
Por ejemplo, un patrón habitual de análisis de seguridad consiste en identificar los métodos que acceden a recursos sensibles del sistema. Consideremos este código para acceder a la ubicación:
// Original code
LocationManager locationManager = (LocationManager) getSystemService(Context.LOCATION_SERVICE);
Location location = locationManager.getLastKnownLocation(LocationManager.GPS_PROVIDER);

// Obfuscated version
Object a = b(c.d);
Object e = ((f) a).g(f.h);
Las herramientas automatizadas que buscan patrones de acceso a la ubicación pasarían por alto por completo la versión ofuscada, y podrían omitir problemas de privacidad.
Del mismo modo, las herramientas de fuzzing necesitan entender qué entradas afectan a las rutas críticas para la seguridad. La ofuscación oculta estas relaciones. Los sistemas de análisis estático que buscan coincidencias con patrones de vulnerabilidad conocidos fallan cuando la ofuscación cambia esos patrones.
Esto crea una situación de seguridad paradójica. La ofuscación disuade eficazmente a los atacantes ocasionales con recursos limitados, pero también dificulta el análisis de seguridad legítimo. Las organizaciones pueden creer erróneamente que la ofuscación ha eliminado las vulnerabilidades en lugar de limitarse a ocultarlas. Las auditorías de seguridad se vuelven considerablemente más costosas y laboriosas, y a veces llevan a las empresas a reducir su frecuencia o su alcance.
4. Vencer la ofuscación con DalvikFLIRT
4.1 Comprender la tecnología FLIRT
FLIRT (Fast Library Identification and Recognition Technology) representa un enfoque novedoso del análisis de código, desarrollado originalmente para el análisis de binarios nativos en herramientas como IDA Pro. En esencia, FLIRT permite identificar funciones estándar en código compilado independientemente de cómo se llamen.
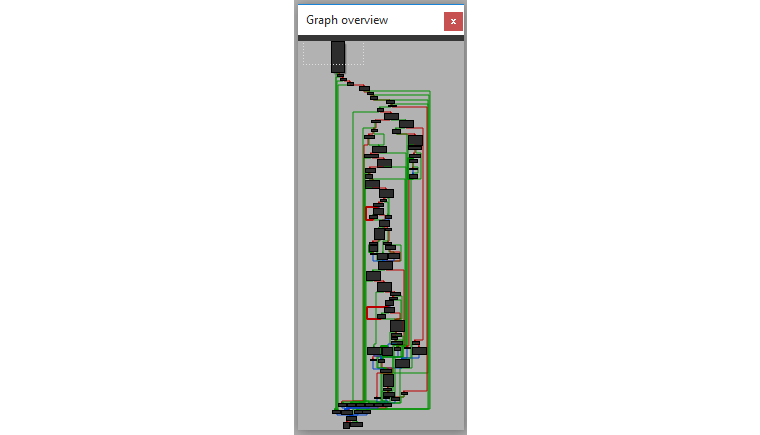
La tecnología crea firmas distintivas basadas en patrones de código, en lugar de depender de identificadores fáciles de cambiar, como los nombres de las funciones. Estas firmas capturan la estructura y el comportamiento esenciales de las funciones, lo que las hace resistentes a las técnicas básicas de ofuscación.
Tradicionalmente, FLIRT se ha usado sobre todo para el análisis de código nativo (C/C++), donde ayuda a identificar funciones de bibliotecas estándar en binarios compilados. Las firmas FLIRT encapsulan múltiples características distintivas de cada función y crean una huella que sigue siendo reconocible incluso cuando se han alterado los nombres y los patrones de código simples.
                Original Function              |             Obfuscated Function
                 ----------------              |             -------------------
Function name:   strcmp                        |  Function name:   fn_0x3A72
Signature:       [Pattern of bytes/opcodes]    |  Signature:       [Identical pattern]
Parameters:      2 string pointers             |  Parameters:      2 string pointers
Structure:       Loop comparing characters     |  Structure:       Loop comparing characters
Return:          Integer (0 if equal)          |  Return:          Integer (0 if equal)
4.2 Propiedades de Dalvik para la identificación basada en firmas
El bytecode de Dalvik, el formato que usan las aplicaciones Android, ofrece oportunidades únicas de identificación basada en firmas que difieren del análisis de binarios tradicional. Incluso tras una ofuscación agresiva de nombres, las relaciones estructurales entre métodos y campos suelen permanecer intactas, ya que cambiarlas rompería la funcionalidad.
Las firmas de los métodos (tipos de parámetros y valores de retorno) deben conservarse para mantener la compatibilidad con el framework de Android y otros componentes. Los modificadores de acceso (public, private, protected) en general no pueden cambiarse sin alterar el comportamiento de la aplicación, y las relaciones de herencia a menudo permanecen sin cambios para preservar la funcionalidad.
En algunos casos, puede conservarse información de depuración, como los nombres de los archivos fuente y los números de línea, lo que aporta puntos de identificación adicionales. Lo más importante es que las llamadas a las API del framework de Android deben mantenerse coherentes, lo que crea patrones reconocibles que sirven de anclas para el análisis.
Estas propiedades persistentes crean una oportunidad para una coincidencia de firmas al estilo FLIRT adaptada específicamente al entorno Dalvik.
###### Class android.support.v7.internal.app.AppCompatViewInflater (android.support.v7.internal.app.AppCompatViewInflater)
.class public Landroid/support/v7/internal/app/AppCompatViewInflater;
.super Ljava/lang/Object;
.source "AppCompatViewInflater.java"


# static fields
.field private static final LOG_TAG:Ljava/lang/String; = "AppCompatViewInflater"

.field private static final sConstructorMap:Ljava/util/Map;
    .annotation system Ldalvik/annotation/Signature;
        value = {
            "Ljava/util/Map",
            "<",
            "Ljava/lang/String;",
            "Ljava/lang/reflect/Constructor",
            "<+",
            "Landroid/view/View;",
            ">;>;"
        }
    .end annotation
.end field

.field static final sConstructorSignature:[Ljava/lang/Class;
    .annotation system Ldalvik/annotation/Signature;
        value = {
            "[",
            "Ljava/lang/Class",
            "<*>;"
        }
    .end annotation
.end field


# instance fields
.field private final mConstructorArgs:[Ljava/lang/Object;

.method private createView(Landroid/content/Context;Ljava/lang/String;Ljava/lang/String;)Landroid/view/View;
    .registers 9
    .param p1, "context"    # Landroid/content/Context;
    .param p2, "name"    # Ljava/lang/String;
    .param p3, "prefix"    # Ljava/lang/String;
    .annotation system Ldalvik/annotation/Throws;
        value = {
            Ljava/lang/ClassNotFoundException;,
            Landroid/view/InflateException;
        }
    .end annotation

    .prologue
    .line 143
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorMap:Ljava/util/Map;

    invoke-interface {v3, p2}, Ljava/util/Map;->get(Ljava/lang/Object;)Ljava/lang/Object;

    move-result-object v1

    check-cast v1, Ljava/lang/reflect/Constructor;

    .line 146
    .local v1, "constructor":Ljava/lang/reflect/Constructor;, "Ljava/lang/reflect/Constructor<+Landroid/view/View;>;"
    if-nez v1, :cond_36

    .line 148
    :try_start_a
    invoke-virtual {p1}, Landroid/content/Context;->getClassLoader()Ljava/lang/ClassLoader;

    move-result-object v4

    if-eqz p3, :cond_43

    new-instance v3, Ljava/lang/StringBuilder;

    invoke-direct {v3}, Ljava/lang/StringBuilder;-><init>()V

    invoke-virtual {v3, p3}, Ljava/lang/StringBuilder;->append(Ljava/lang/String;)Ljava/lang/StringBuilder;

    move-result-object v3

    invoke-virtual {v3, p2}, Ljava/lang/StringBuilder;->append(Ljava/lang/String;)Ljava/lang/StringBuilder;

    move-result-object v3

    invoke-virtual {v3}, Ljava/lang/StringBuilder;->toString()Ljava/lang/String;

    move-result-object v3

    :goto_21
    invoke-virtual {v4, v3}, Ljava/lang/ClassLoader;->loadClass(Ljava/lang/String;)Ljava/lang/Class;

    move-result-object v3

    const-class v4, Landroid/view/View;

    invoke-virtual {v3, v4}, Ljava/lang/Class;->asSubclass(Ljava/lang/Class;)Ljava/lang/Class;

    move-result-object v0

    .line 151
    .local v0, "clazz":Ljava/lang/Class;, "Ljava/lang/Class<+Landroid/view/View;>;"
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorSignature:[Ljava/lang/Class;

    invoke-virtual {v0, v3}, Ljava/lang/Class;->getConstructor([Ljava/lang/Class;)Ljava/lang/reflect/Constructor;

    move-result-object v1

    .line 152
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorMap:Ljava/util/Map;

    invoke-interface {v3, p2, v1}, Ljava/util/Map;->put(Ljava/lang/Object;Ljava/lang/Object;)Ljava/lang/Object;

    .line 154
    .end local v0    # "clazz":Ljava/lang/Class;, "Ljava/lang/Class<+Landroid/view/View;>;"
    :cond_36
    const/4 v3, 0x1

    invoke-virtual {v1, v3}, Ljava/lang/reflect/Constructor;->setAccessible(Z)V

    .line 155
    iget-object v3, p0, Landroid/support/v7/internal/app/AppCompatViewInflater;->mConstructorArgs:[Ljava/lang/Object;

    invoke-virtual {v1, v3}, Ljava/lang/reflect/Constructor;->newInstance([Ljava/lang/Object;)Ljava/lang/Object;

    move-result-object v3

    check-cast v3, Landroid/view/View;
    :try_end_42
    .catch Ljava/lang/Exception; {:try_start_a .. :try_end_42} :catch_45

    .line 159
    :goto_42
    return-object v3

    :cond_43
    move-object v3, p2

    .line 148
    goto :goto_21

    .line 156
    :catch_45
    move-exception v2

    .line 159
    .local v2, "e":Ljava/lang/Exception;
    const/4 v3, 0x0

    goto :goto_42
.end method
Comprender los patrones típicos de ofuscación de Android es esencial para desarrollar firmas eficaces. La técnica más extendida es el cambio de nombre de identificadores, en la que las clases, los métodos y los campos reciben nombres sin sentido, como letras sueltas o cadenas aleatorias.
5. Cómo funciona DalvikFLIRT
DalvikFLIRT aplica el concepto de coincidencia de firmas al ecosistema Android con adaptaciones importantes para las particularidades del bytecode de Dalvik.
5.1 Generar la firma de una clase
DalvikFLIRT genera firmas de clases recopilando una amplia gama de atributos. Cada firma de clase incluye información estructural (nombre, superclase, indicadores de acceso, interfaces), metadatos del código fuente cuando están disponibles, campos con sus tipos y modificadores, constantes de cadena tanto de los campos como de los métodos, y firmas detalladas de cada método. El sistema también calcula un hash de huella único que combina las características más distintivas de la clase.
En el caso de los métodos, las firmas son aún más detalladas: capturan descriptores de método, indicadores de acceso, hashes del bytecode, recuentos de instrucciones, llamadas a API, constantes, distribuciones de opcodes y características del grafo de flujo de control.
Este enfoque multifacético crea una firma rica que captura atributos tanto estructurales como de comportamiento y sigue siendo reconocible a pesar de la ofuscación.
{
  "classes": {
    "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;": {
      "name": "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;",
      "superclass": "Lkotlin/jvm/internal/Lambda;",
      "access_flags": 16,
      "interfaces": [
        "Lkotlin/jvm/functions/Function3;"
      ],
      "source_file": null,
      "fingerprint": "2f1b337d2e6092b6775b2c9059222361",
      "fields": [
        {
          "name": "INSTANCE",
          "type": "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;",
          "access_flags": 25
        }
      ],
      "field_strings": [],
      "string_constants": [
        "innerPadding",
        "com.example.myapplication.ComposableSingletons$MainActivityKt.lambda-1.<anonymous> (MainActivity.kt:22)",
        "Android",
        "C22@889L139:MainActivity.kt#ptgicz"
      ],
      "methods": {
        "<clinit>()V": {
          "name": "<clinit>",
          "descriptor": "()V",
          "access_flags": 65544,
          "bytecode_hash": "2552c2aefad67c2d666996fc73085a74",
          "instruction_count": 4,
          "api_calls": [
            21
          ],
          "constants": [],
          "opcode_distribution": {
            "34": 1,
            "112": 1,
            "105": 1,
            "14": 1
          },
          "cfg": {
            "basic_blocks": 1,
            "edges": 0,
            "exception_handlers": 0
          },
          "registers": 1
        },
        "<init>()V": {
          "name": "<init>",
          "descriptor": "()V",
          "access_flags": 65536,
          "bytecode_hash": "0e486b2e5a245ee4b0e601cc7ddbbce9",
          "instruction_count": 3,
          "api_calls": [
            61
          ],
          "constants": [
            [
              "numeric",
              3
            ]
          ],
          "opcode_distribution": {
            "18": 1,
            "112": 1,
            "14": 1
          },
          "cfg": {
            "basic_blocks": 1,
            "edges": 0,
            "exception_handlers": 0
          },
5.2 Cálculo de métricas de semejanza
Al comparar una clase ofuscada con bases de datos de firmas, DalvikFLIRT emplea un cálculo de similitud ponderado. Los distintos componentes contribuyen a la puntuación global según su resistencia a la ofuscación:
METHOD_WEIGHTS = {
    "bytecode_hash": 0.0,
    "descriptor": 0.25,
    "constants": 0.25,
    "opcode_distribution": 0.3,
    "cfg": 0.2,
}

CLASS_WEIGHTS = {
    "metrics": 0.2,
    "superclass": 0.1,
    "interfaces": 0.1,
    "fields": 0.1,
    "methods": 0.5,
}
Los descriptores de método son muy fiables porque los tipos de parámetros y los valores de retorno rara vez cambian sin romper la funcionalidad. Las constantes de cadena suelen sobrevivir a la ofuscación básica y aportan pistas semánticas. La distribución de opcodes crea una huella estadística del comportamiento del método, mientras que la estructura del grafo de flujo de control refleja los patrones de lógica que deben conservarse para un funcionamiento correcto.
A nivel de clase, las métricas de la clase (como el número de métodos y de campos), las relaciones de herencia y las implementaciones de interfaces contribuyen a la identificación. El enfoque ponderado hace que DalvikFLIRT pueda reconocer coincidencias incluso cuando algunos aspectos han cambiado, siempre que se conserven suficientes características distintivas.

5.3 La herramienta en acción
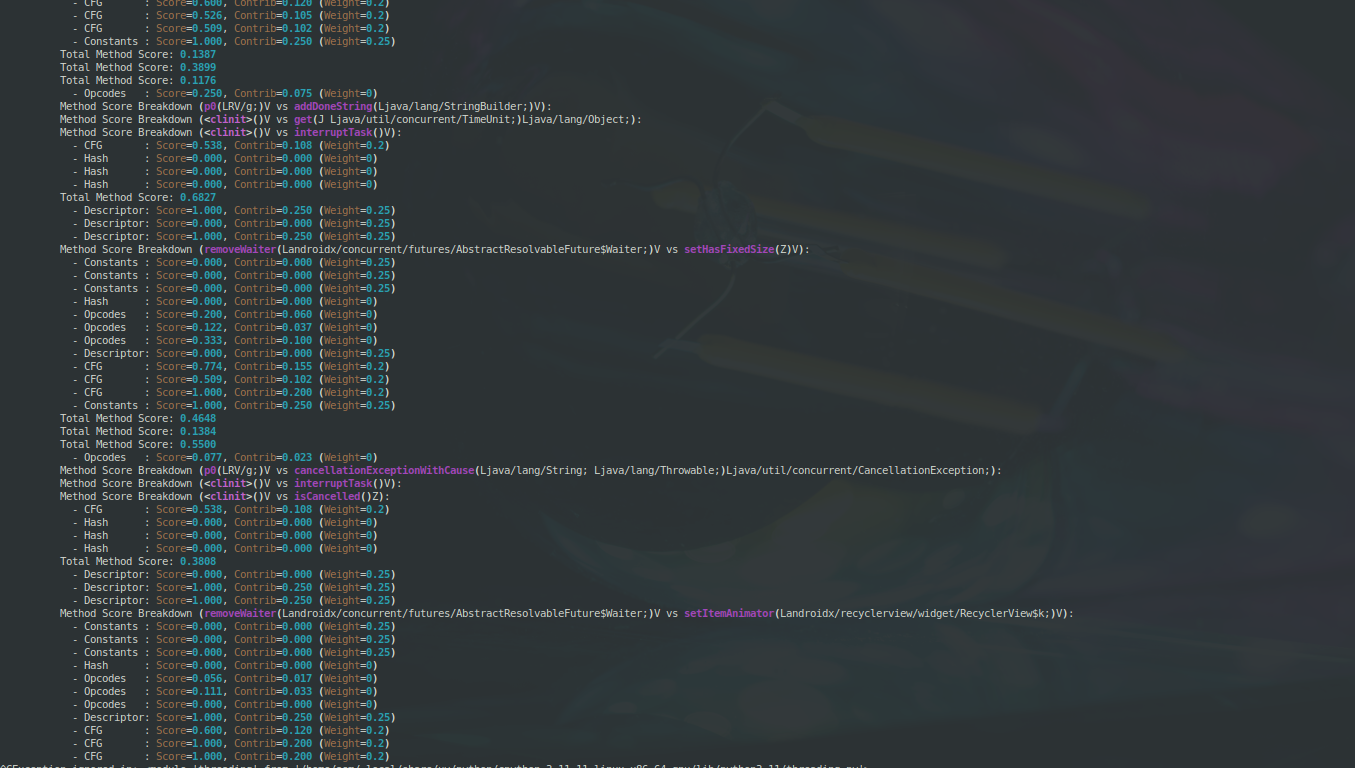
En pruebas en entornos reales, aplicamos DalvikFLIRT a aplicaciones populares, algunas con más de 250,000 clases. La siguiente salida muestra un ejemplo de coincidencia:
DalvikFLIRT Simplified Signature Matcher
Signatures1: tests/files/app-debug_signatures.json
Signatures2: tests/files/Media_APKPure_signatures.json
Output: matches_media.json
Threshold: 0.8

Loading signatures from tests/files/app-debug_signatures.json
Loaded 12288 class signatures
Loading signatures from tests/files/media_APKPure_signatures.json
Loaded 279796 class signatures
El comparador identificó que la clase ofuscada LX/i7X corresponde a Landroidx/concurrent/futures/AbstractResolvableFuture con un 83.9% de confianza:
Class Score Breakdown (LX/i7X; vs Landroidx/concurrent/futures/AbstractResolvableFuture;):
  - Metrics     : Score=0.451, Contrib=0.090 (Weight=0.2)
  - Superclass  : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Interfaces  : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Fields      : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Methods     : Score=0.898, Contrib=0.449 (Weight=0.5)
Total Class Score: 0.8390
Esta identificación funciona a pesar de la ofuscación completa de los nombres. Por ejemplo, el método llamado addListener en el código original pasó a llamarse LIZJ(Ljava/lang/Runnable; Ljava/util/concurrent/Executor;)V en la versión ofuscada. DalvikFLIRT los emparejó correctamente a partir de los tipos de parámetros, el flujo de control y los patrones de opcodes.
6. ¿Y el resto del código? Reescrituras de código con LLM
Aunque DalvikFLIRT destaca al identificar componentes conocidos del SDK de Android y de bibliotecas comunes, no funciona con el código personalizado de la aplicación que no tiene una firma de referencia conocida. Aquí es donde aprovechamos la potencia de los modelos de lenguaje grandes (LLM) para ofrecer un enfoque complementario.
6.1 Reescritores basados en LLM
Los modelos de lenguaje grandes modernos tienen capacidades notables para entender, generar y transformar código a partir de los patrones que han aprendido de enormes repositorios de código. Hemos descubierto que estos LLM pueden revertir con eficacia muchos tipos de ofuscación al inferir el significado a partir del contexto y la estructura.
La idea clave de nuestro enfoque es replantear el problema. En lugar de pedir a los modelos que «desofusquen» código (algo que muchos se niegan a hacer por posibles preocupaciones de uso indebido), presentamos la tarea como «mejorar la legibilidad del código» - una distinción sutil pero importante que permite que los modelos se ocupen de la tarea:
deobfuscator_agent = Agent(
    large_model,
    system_prompt=(
        "You are an expert Java developer. Given hard to read Java source code, "
        "your task is to: \n"
        "Rewrite the code to make it more readable.\n"
        "Please make sure to rewrite the whole code and DO NOT omit any function or method.\n"
        "Improve the quality of the code. Focus on renaming variables, methods, "
        "and classes to be more descriptive names based on their context and usage. "
        "Maintain the original code's functionality. If no context is provided, "
        "do your best to rewrite based on the code alone."
        "Feel free to rewrite control flow to make the code easier to understand."
        "Do NOT change string constants as these might be used by other apps."
    ),
)
6.2 El sistema multiagente
Nuestra implementación utiliza un sistema multiagente coordinado en el que componentes especializados trabajan juntos para mejorar progresivamente la comprensión del código:
- El Deobfuscation Agent reescribe el código ofuscado para hacerlo más claro conservando la funcionalidad, y se centra en proporcionar nombres significativos y simplificar las estructuras de control complejas.
- El Explainer Agent ofrece descripciones en lenguaje sencillo de lo que hace el código, e identifica entradas, salidas y comportamientos clave. Esto ayuda a aportar contexto para análisis posteriores.
El Context-Building Agent integra la información de los componentes ya identificados (como los reconocidos por DalvikFLIRT) para orientar el análisis de las secciones desconocidas.
En lugar de operar de forma independiente, estos agentes comparten información y crean un bucle de retroalimentación que mejora progresivamente la comprensión a medida que se procesa más código.
# Initialize the AI agent for deobfuscation
deobfuscator_agent = Agent(
    # model,
    large_model,
    system_prompt=(
        "You are an expert Java developer. Given an hard to read Java source code, "
        "your task is to: \n"
        "Rewrite the code to make it more readable.\n"
        "Please make sure to rewrite the whole code and DO NOT omit any function or method.\n"
        "and improve the quality of the code. Focus on renaming variables, methods, "
        "and classes to more descriptive names based on their context and usage."
        "DO NOT keep short or cryptic variable, classes and method names. "
        "Maintain the original code's functionality. If no context is provided, "
        "do your best to rewrite based on the code alone."
        "Feel free to rewrite control flow to make the code easier to understand."
        "Do NOT change string constant as these might be used by other apps."
    ),
)

# Initialize the AI agent for code explanation
code_explainer = Agent(
    model,
    system_prompt=(
        "You are an expert code explainer. Analyze the provided source code and explain it in plain English. "
        "Be thorough and cover: \n"
        "1. The code's purpose and functionality\n"
        "2. Inputs it expects\n"
        "3. Outputs it produces\n"
        "4. Edge cases and error handling\n"
        "Use clear, simple language suitable for developers of all levels."
    ),
    result_type=CodeExplanation,
)
6.3 Ingeniería de prompts para obtener resultados óptimos
La eficacia de nuestro enfoque basado en LLM depende en gran medida de elaborar los prompts adecuados. Hemos desarrollado varias técnicas que producen mejores resultados de forma constante:
En lugar de mencionar directamente «ofuscación» o «desofuscación», planteamos la tarea como mejorar la legibilidad de código «difícil de leer». Este cambio sutil evita activar los filtros de seguridad de los modelos.
Proporcionamos como puntos de referencia contexto de la API de Java y Kotlin, de bibliotecas sin ofuscar y de componentes identificados por DalvikFLIRT. Por ejemplo, si sabemos que la aplicación llama a un método de cifrado identificado, ese conocimiento ayuda al LLM a interpretar correctamente el código circundante.
Nuestro proceso empieza por los métodos más simples y con menos dependencias, y luego aborda progresivamente los componentes más complejos. Esto permite al LLM construir el contexto de forma gradual, usando la información de análisis anteriores para orientar los posteriores.
Unas instrucciones claras sobre qué conservar (la funcionalidad) y qué mejorar (nombres, estructura) ayudan a guiar al modelo hacia transformaciones útiles en lugar de un simple reformateo.
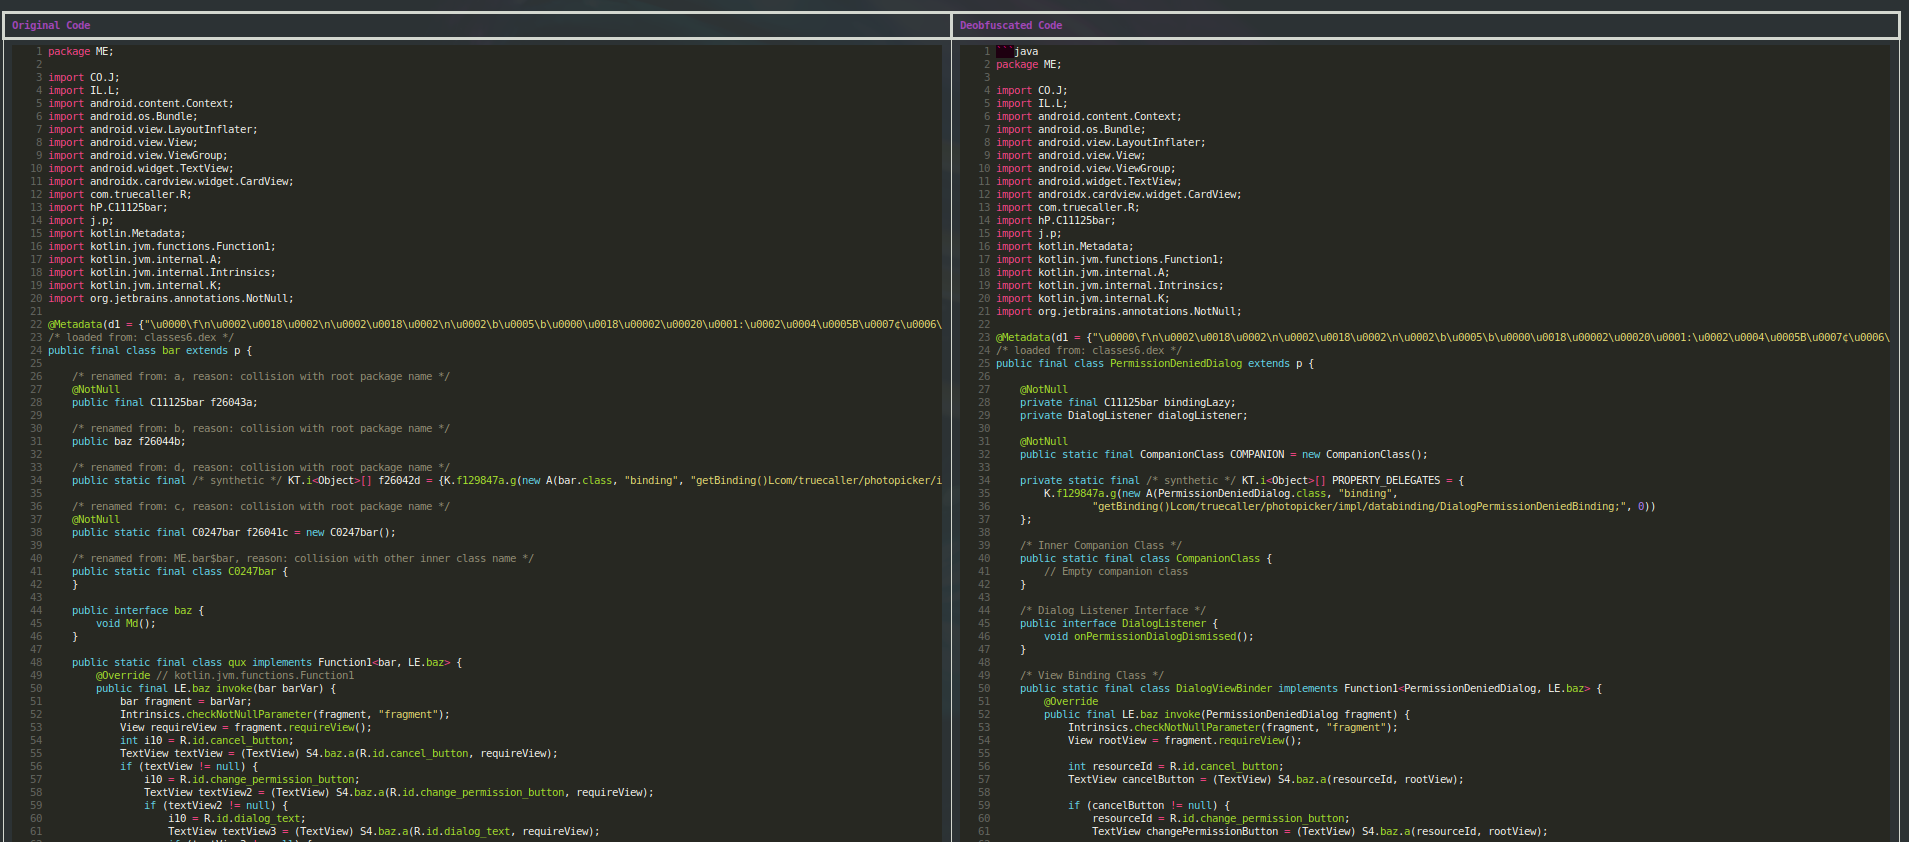
Este es un ejemplo de lo que nuestro sistema puede lograr:
// Original obfuscated code
public static void a(long j, String str, int i, Object obj) {
    if (obj != null && c.e(str) && i >= 0) {
        new Thread(new d(j, str, i, obj)).start();
    }
}

// LLM-deobfuscated code
public static void logEventAsync(long userId, String eventName, int eventType, Object eventData) {
    if (eventData != null && ValidationUtils.isValidEventName(eventName) && eventType >= 0) {
        new Thread(new EventLoggingTask(userId, eventName, eventType, eventData)).start();
    }
}
La versión desofuscada no solo proporciona nombres significativos que revelan el propósito del método, sino que también infiere el probable significado de las clases componentes según cómo se utilizan.
6.4 El análisis recursivo de abajo arriba
Hemos comprobado que combinar la coincidencia de firmas de DalvikFLIRT con las reescrituras basadas en LLM funciona mejor con un enfoque recursivo de abajo arriba. Así se desarrolla el proceso:
Primero construimos un grafo de llamadas completo que muestra cómo se relacionan entre sí todos los métodos de la aplicación. Este mapeo revela qué métodos llaman a cuáles otros y crea una jerarquía de dependencias.
A continuación identificamos los «métodos hoja» - los que no llaman a otros métodos. Estas funciones más simples son puntos de partida ideales para el análisis, ya que tienen menos dependencias.
Con nuestro conjunto inicial de métodos desofuscados (algunos mediante la coincidencia de firmas de DalvikFLIRT y otros mediante el análisis con LLM), subimos por el árbol de llamadas hasta los métodos que usan estas funciones ya comprendidas. Los métodos analizados previamente aportan un contexto valioso para entender qué hacen estas funciones de nivel superior.
A medida que seguimos subiendo por el árbol de llamadas, construimos una comprensión cada vez más rica del comportamiento de la aplicación. Cada nuevo método se beneficia del contexto de todos los métodos previamente analizados a los que llama.
Piense en ello como en la arqueología - empezamos por comprender los artefactos más simples y luego usamos ese conocimiento para interpretar los más complejos, reconstruyendo gradualmente toda la civilización desde cero.
El siguiente código muestra cómo se analiza un método en este sistema consciente del contexto:
def analyze_method(self, node: MethodNode) -> Dict:
    """
    Perform full AI analysis on a method including explanation, deobfuscation and security audit.
    """
    # Get source code
    class_source_code = self.methods_engine.get_class_source(node)
    method_source_code = self.methods_engine.get_method_source(node)

    # Get context from callees (methods this one calls)
    callee_info = self.methods_engine.get_callees(node)

    # Deobfuscate the code using both DalvikFLIRT and LLM approaches
    deobfuscated_code = self.deobfuscate_code(
        class_source_code,
        method_source_code,
        context=callee_info
    )

    # Generate a human-readable explanation
    explanation = self.explain_code(deobfuscated_code, node)

    # Store results for use as context in analyzing methods that call this one
    return {
        'source_code': method_source_code,
        'deobfuscated_code': deobfuscated_code,
        'explanation': explanation,
        'security_issues': security_audit,
    }
Al combinar estas técnicas - la identificación basada en firmas de DalvikFLIRT para los componentes conocidos y la reescritura de código con LLM para la lógica personalizada de la aplicación - hemos creado un sistema capaz de desofuscar eficazmente incluso aplicaciones Android fuertemente protegidas.
Conclusión y líneas futuras
Nuestro enfoque dual, que combina el reconocimiento basado en firmas de DalvikFLIRT con las reescrituras basadas en LLM, crea un sistema potente para eludir la ofuscación en aplicaciones Android. Este enfoque nos da capacidades sin precedentes para entender lo que de otro modo sería código impenetrable.
La principal fortaleza de nuestra metodología es identificar automáticamente, con alta confianza, los componentes del SDK de Android y usarlos como anclas contextuales para generar código de alta calidad para la lógica específica de cada aplicación. El sistema maneja varias técnicas de ofuscación a la vez, desde la simple ofuscación de nombres hasta la manipulación más compleja del flujo de control.
El enfoque recursivo de abajo arriba hace que el sistema sea cada vez más eficaz a medida que analiza más código, y cada nueva conclusión mejora los análisis posteriores.
Este trabajo no consiste en socavar la seguridad, sino en avanzar en las capacidades de automatización. Al hacer comprensible el código ofuscado, permitimos un análisis de seguridad y una detección de vulnerabilidades más exhaustivos.
Etiquetas:
ai