Désobfuscation Android avec DalvikFLIRT et les LLM
Cette recherche présente une approche duale inédite qui associe la recherche de correspondances par signatures (DalvikFLIRT) et la transformation de code par LLM pour contourner l'obfuscation sophistiquée des applications Android, et permet l'analyse de sécurité automatisée d'un code jusque-là impénétrable.
1. Comprendre l'obfuscation des applications Android
Dans l'écosystème Android, l'obfuscation est un mécanisme de défense important pour les développeurs d'applications : elle protège la propriété intellectuelle et le code sensible contre les tentatives de rétro-ingénierie. En rendant la rétro-ingénierie plus difficile, elle constitue un obstacle pour les attaquants occasionnels.
Bien qu'il s'agisse d'une mesure de durcissement, l'obfuscation pose de sérieuses difficultés aux chercheurs en sécurité qui tentent d'identifier des vulnérabilités. Nous avons décidé de nous pencher sur le sujet alors que nous poussons l'automatisation d'Ostorlab au-delà de la recherche de vulnérabilités techniques, vers l'automatisation de la découverte de vulnérabilités logiques.
L'obfuscation transforme un code clair et lisible en versions volontairement complexes et cryptiques, tout en préservant la fonctionnalité. Lorsque les développeurs obfusquent leur code, ils retirent en substance le sens sémantique tout en préservant la correction syntaxique - le code fonctionne toujours, mais devient presque impossible à comprendre.
Prenons cet exemple simple :
// Original code
public void validateUserCredentials(String username, String password) {
    if (isValidUsername(username) && isCorrectPassword(password)) {
        grantAccess();
    } else {
        denyAccess();
    }
}

// Obfuscated code
public void a(String b, String c) {
    if (d(b) && e(c)) {
        f();
    } else {
        g();
    }
}
Bien qu'identique sur le plan fonctionnel, la version obfusquée masque l'objectif et la logique du code, ce qui rend sa compréhension difficile lors de l'analyse de sécurité.
L'obfuscation Android moderne fait appel à plusieurs techniques et outils :
- ProGuard, l'outil open source traditionnel, est intégré aux builds Android depuis des années et fournit une obfuscation de base des noms ainsi qu'une réduction du code.
- R8, le remplaçant moderne de ProGuard développé par Google, offre des capacités d'optimisation améliorées et une intégration transparente au système de build Android ; il est désormais le compilateur par défaut dans Android Studio.
Pour les applications qui exigent une protection plus forte, des outils commerciaux peuvent fournir des fonctionnalités plus avancées, notamment le chiffrement des chaînes de caractères, l'obfuscation du flot de contrôle et des mesures d'anti-débogage.
2. Prévalence de l'obfuscation dans l'écosystème Android
L'usage de l'obfuscation dans les applications Android est répandu et en croissance, en particulier parmi les applications à forte valeur et celles qui traitent des données sensibles.
L'étude « A Large Scale Investigation of Obfuscation Use in Google Play » (2018) a constaté qu'environ 25 % de toutes les applications Android emploient une forme d'obfuscation. L'étude a analysé 1,7 million d'applications Android gratuites et a découvert que, lorsqu'on ne considère que les applications les plus populaires, ce chiffre grimpe à environ 50 %.
Un article plus récent (février 2025, « An Empirical Study of Code Obfuscation Practices in Android Apps ») a documenté une hausse de 13 % de l'adoption de l'obfuscation entre 2016 et 2023, avec une progression particulièrement marquée de 28 % chez les principaux développeurs sur cette période. Notre analyse montre une augmentation significative de l'adoption de l'obfuscation, couvrant près de 62 % des applications testées.
La prévalence de l'obfuscation varie sensiblement selon les catégories d'applications. Les applications financières et bancaires affichent une adoption quasi universelle, les applications de jeux recourent fréquemment à une obfuscation agressive pour protéger les algorithmes de monétisation et les mécanismes anti-triche, et les applications d'entreprise mettent en œuvre des stratégies de protection modérées pour préserver leur logique métier propriétaire. Les plateformes de réseaux sociaux adoptent de plus en plus une obfuscation sophistiquée pour protéger les mécanismes de traitement des données utilisateur.
ProGuard/R8 reste la solution la plus utilisée en raison de son intégration à Android Studio et de son coût nul. Cependant, les solutions commerciales sont fortement présentes dans les applications à forte valeur. Les solutions d'obfuscation sur mesure sont de plus en plus courantes dans les applications qui traitent des données particulièrement sensibles, comme les services financiers et les applications de santé.
3. Effet de l'obfuscation sur l'analyse de sécurité
L'obfuscation pose des difficultés considérables à l'analyse de sécurité, qu'elle soit manuelle ou automatisée, et crée un paradoxe de sécurité intéressant.
Pour les analystes humains qui examinent le code, l'obfuscation supprime tous les indices contextuels qui facilitent habituellement la compréhension. Sans noms significatifs, les chercheurs doivent suivre laborieusement les chemins d'exécution pour comprendre ce que fait chaque fonction. Prenons le système d'authentification d'une application bancaire - ce qui serait normalement identifié comme verifyUserCredentials() devient simplement LIZIZI(), ce qui dissimule son caractère critique pour la sécurité.
Le flot de contrôle est volontairement alambiqué, avec des sauts supplémentaires, des branches conditionnelles et des indirections inutiles. Les constantes de chaînes de caractères qui pourraient donner des indices sur la fonctionnalité sont chiffrées, et les relations entre composants deviennent presque impossibles à discerner.
Un chercheur en sécurité peut passer des jours, voire des semaines, à déchiffrer un flux d'authentification qui prendrait quelques heures dans du code non obfusqué.
Les outils d'analyse automatisée en souffrent encore plus sévèrement. Les systèmes de taint analysis suivent la façon dont les données circulent depuis des sources sensibles (comme les entrées utilisateur) vers des sinks dangereux (comme les requêtes SQL). Lors de l'examen d'une injection SQL, un outil identifie normalement des méthodes comme executeQuery() comme des points de sink potentiels. Avec l'obfuscation, ces méthodes deviennent méconnaissables - LIIZZ() pourrait être n'importe quoi, de la journalisation à l'accès à la base de données. Cela brise fondamentalement le mécanisme central de ces outils.
Par exemple, un schéma courant d'analyse de sécurité consiste à identifier les méthodes qui accèdent à des ressources système sensibles. Considérons ce code d'accès à la localisation :
// Original code
LocationManager locationManager = (LocationManager) getSystemService(Context.LOCATION_SERVICE);
Location location = locationManager.getLastKnownLocation(LocationManager.GPS_PROVIDER);

// Obfuscated version
Object a = b(c.d);
Object e = ((f) a).g(f.h);
Les outils automatisés qui recherchent des schémas d'accès à la localisation passeraient complètement à côté de la version obfusquée, au risque de négliger des problèmes de confidentialité.
De même, les outils de fuzzing doivent comprendre quelles entrées influencent les chemins critiques pour la sécurité. L'obfuscation dissimule ces relations. Les systèmes d'analyse statique qui recherchent des schémas de vulnérabilités connus échouent lorsque ces schémas sont modifiés par l'obfuscation.
Cela crée une situation de sécurité paradoxale. L'obfuscation dissuade efficacement les attaquants occasionnels aux ressources limitées, mais entrave aussi l'analyse de sécurité légitime. Les organisations peuvent croire à tort que l'obfuscation a éliminé les vulnérabilités alors qu'elle ne fait que les dissimuler. Les audits de sécurité deviennent nettement plus coûteux et plus longs, ce qui conduit parfois les entreprises à en réduire la fréquence ou la portée.
4. Vaincre l'obfuscation avec DalvikFLIRT
4.1 Comprendre la technologie FLIRT
FLIRT (Fast Library Identification and Recognition Technology) représente une approche nouvelle de l'analyse de code, développée à l'origine pour l'analyse de binaires natifs dans des outils comme IDA Pro. À la base, FLIRT permet d'identifier les fonctions standard dans du code compilé, quel que soit leur nom.
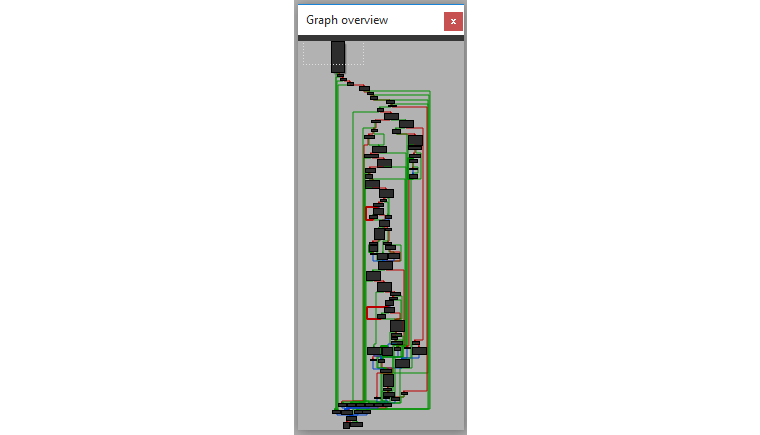
La technologie crée des signatures distinctives fondées sur des schémas de code plutôt que sur des identifiants facilement modifiables comme les noms de fonctions. Ces signatures capturent la structure et le comportement essentiels des fonctions, ce qui les rend résistantes aux techniques d'obfuscation de base.
Traditionnellement, FLIRT a surtout été utilisé pour l'analyse de code natif (C/C++), où il aide à identifier les fonctions de bibliothèques standard dans des binaires compilés. Les signatures FLIRT encapsulent plusieurs caractéristiques distinctives de chaque fonction et créent une empreinte qui reste reconnaissable même lorsque les noms et les schémas de code simples ont été altérés.
                Original Function              |             Obfuscated Function
                 ----------------              |             -------------------
Function name:   strcmp                        |  Function name:   fn_0x3A72
Signature:       [Pattern of bytes/opcodes]    |  Signature:       [Identical pattern]
Parameters:      2 string pointers             |  Parameters:      2 string pointers
Structure:       Loop comparing characters     |  Structure:       Loop comparing characters
Return:          Integer (0 if equal)          |  Return:          Integer (0 if equal)
4.2 Propriétés de Dalvik pour l'identification par signatures
Le bytecode Dalvik, format utilisé par les applications Android, offre des possibilités uniques d'identification par signatures, différentes de l'analyse binaire traditionnelle. Même après une obfuscation agressive des noms, les relations structurelles entre méthodes et champs restent généralement intactes, car les modifier casserait la fonctionnalité.
Les signatures de méthodes (types de paramètres et valeurs de retour) doivent être préservées pour maintenir la compatibilité avec le framework Android et les autres composants. Les modificateurs d'accès (public, private, protected) ne peuvent généralement pas être changés sans altérer le comportement de l'application, et les relations d'héritage restent souvent inchangées pour préserver la fonctionnalité.
Dans certains cas, des informations de débogage comme les noms de fichiers source et les numéros de ligne peuvent être conservées, ce qui fournit des points d'identification supplémentaires. Surtout, les appels aux API du framework Android doivent rester cohérents, ce qui crée des schémas reconnaissables qui servent d'ancres pour l'analyse.
Ces propriétés persistantes ouvrent la voie à une recherche de correspondances par signatures de type FLIRT, spécialement adaptée à l'environnement Dalvik.
###### Class android.support.v7.internal.app.AppCompatViewInflater (android.support.v7.internal.app.AppCompatViewInflater)
.class public Landroid/support/v7/internal/app/AppCompatViewInflater;
.super Ljava/lang/Object;
.source "AppCompatViewInflater.java"


# static fields
.field private static final LOG_TAG:Ljava/lang/String; = "AppCompatViewInflater"

.field private static final sConstructorMap:Ljava/util/Map;
    .annotation system Ldalvik/annotation/Signature;
        value = {
            "Ljava/util/Map",
            "<",
            "Ljava/lang/String;",
            "Ljava/lang/reflect/Constructor",
            "<+",
            "Landroid/view/View;",
            ">;>;"
        }
    .end annotation
.end field

.field static final sConstructorSignature:[Ljava/lang/Class;
    .annotation system Ldalvik/annotation/Signature;
        value = {
            "[",
            "Ljava/lang/Class",
            "<*>;"
        }
    .end annotation
.end field


# instance fields
.field private final mConstructorArgs:[Ljava/lang/Object;

.method private createView(Landroid/content/Context;Ljava/lang/String;Ljava/lang/String;)Landroid/view/View;
    .registers 9
    .param p1, "context"    # Landroid/content/Context;
    .param p2, "name"    # Ljava/lang/String;
    .param p3, "prefix"    # Ljava/lang/String;
    .annotation system Ldalvik/annotation/Throws;
        value = {
            Ljava/lang/ClassNotFoundException;,
            Landroid/view/InflateException;
        }
    .end annotation

    .prologue
    .line 143
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorMap:Ljava/util/Map;

    invoke-interface {v3, p2}, Ljava/util/Map;->get(Ljava/lang/Object;)Ljava/lang/Object;

    move-result-object v1

    check-cast v1, Ljava/lang/reflect/Constructor;

    .line 146
    .local v1, "constructor":Ljava/lang/reflect/Constructor;, "Ljava/lang/reflect/Constructor<+Landroid/view/View;>;"
    if-nez v1, :cond_36

    .line 148
    :try_start_a
    invoke-virtual {p1}, Landroid/content/Context;->getClassLoader()Ljava/lang/ClassLoader;

    move-result-object v4

    if-eqz p3, :cond_43

    new-instance v3, Ljava/lang/StringBuilder;

    invoke-direct {v3}, Ljava/lang/StringBuilder;-><init>()V

    invoke-virtual {v3, p3}, Ljava/lang/StringBuilder;->append(Ljava/lang/String;)Ljava/lang/StringBuilder;

    move-result-object v3

    invoke-virtual {v3, p2}, Ljava/lang/StringBuilder;->append(Ljava/lang/String;)Ljava/lang/StringBuilder;

    move-result-object v3

    invoke-virtual {v3}, Ljava/lang/StringBuilder;->toString()Ljava/lang/String;

    move-result-object v3

    :goto_21
    invoke-virtual {v4, v3}, Ljava/lang/ClassLoader;->loadClass(Ljava/lang/String;)Ljava/lang/Class;

    move-result-object v3

    const-class v4, Landroid/view/View;

    invoke-virtual {v3, v4}, Ljava/lang/Class;->asSubclass(Ljava/lang/Class;)Ljava/lang/Class;

    move-result-object v0

    .line 151
    .local v0, "clazz":Ljava/lang/Class;, "Ljava/lang/Class<+Landroid/view/View;>;"
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorSignature:[Ljava/lang/Class;

    invoke-virtual {v0, v3}, Ljava/lang/Class;->getConstructor([Ljava/lang/Class;)Ljava/lang/reflect/Constructor;

    move-result-object v1

    .line 152
    sget-object v3, Landroid/support/v7/internal/app/AppCompatViewInflater;->sConstructorMap:Ljava/util/Map;

    invoke-interface {v3, p2, v1}, Ljava/util/Map;->put(Ljava/lang/Object;Ljava/lang/Object;)Ljava/lang/Object;

    .line 154
    .end local v0    # "clazz":Ljava/lang/Class;, "Ljava/lang/Class<+Landroid/view/View;>;"
    :cond_36
    const/4 v3, 0x1

    invoke-virtual {v1, v3}, Ljava/lang/reflect/Constructor;->setAccessible(Z)V

    .line 155
    iget-object v3, p0, Landroid/support/v7/internal/app/AppCompatViewInflater;->mConstructorArgs:[Ljava/lang/Object;

    invoke-virtual {v1, v3}, Ljava/lang/reflect/Constructor;->newInstance([Ljava/lang/Object;)Ljava/lang/Object;

    move-result-object v3

    check-cast v3, Landroid/view/View;
    :try_end_42
    .catch Ljava/lang/Exception; {:try_start_a .. :try_end_42} :catch_45

    .line 159
    :goto_42
    return-object v3

    :cond_43
    move-object v3, p2

    .line 148
    goto :goto_21

    .line 156
    :catch_45
    move-exception v2

    .line 159
    .local v2, "e":Ljava/lang/Exception;
    const/4 v3, 0x0

    goto :goto_42
.end method
Comprendre les schémas d'obfuscation Android typiques est essentiel pour développer des signatures efficaces. La technique la plus répandue est le renommage des identifiants, où les classes, méthodes et champs reçoivent des noms dénués de sens, comme des lettres isolées ou des chaînes aléatoires.
5. Comment fonctionne DalvikFLIRT
DalvikFLIRT applique le concept de recherche de correspondances par signatures à l'écosystème Android, avec des adaptations importantes aux spécificités du bytecode Dalvik.
5.1 Générer la signature d'une classe
DalvikFLIRT génère des signatures de classes en collectant un large éventail d'attributs. Chaque signature de classe comprend des informations structurelles (nom, superclasse, drapeaux d'accès, interfaces), les métadonnées du code source lorsqu'elles sont disponibles, les champs avec leurs types et modificateurs, les constantes de chaînes de caractères issues des champs comme des méthodes, et des signatures détaillées pour chaque méthode. Le système calcule également un hash d'empreinte unique qui combine les caractéristiques les plus distinctives de la classe.
Pour les méthodes, les signatures sont encore plus détaillées : elles capturent les descripteurs de méthode, les drapeaux d'accès, les hashes du bytecode, le nombre d'instructions, les appels d'API, les constantes, les distributions d'opcodes et les caractéristiques du graphe de flot de contrôle.
Cette approche multifacette crée une signature riche qui capture à la fois les attributs structurels et comportementaux, et reste reconnaissable malgré l'obfuscation.
{
  "classes": {
    "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;": {
      "name": "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;",
      "superclass": "Lkotlin/jvm/internal/Lambda;",
      "access_flags": 16,
      "interfaces": [
        "Lkotlin/jvm/functions/Function3;"
      ],
      "source_file": null,
      "fingerprint": "2f1b337d2e6092b6775b2c9059222361",
      "fields": [
        {
          "name": "INSTANCE",
          "type": "Lcom/example/myapplication/ComposableSingletons$MainActivityKt$lambda-1$1;",
          "access_flags": 25
        }
      ],
      "field_strings": [],
      "string_constants": [
        "innerPadding",
        "com.example.myapplication.ComposableSingletons$MainActivityKt.lambda-1.<anonymous> (MainActivity.kt:22)",
        "Android",
        "C22@889L139:MainActivity.kt#ptgicz"
      ],
      "methods": {
        "<clinit>()V": {
          "name": "<clinit>",
          "descriptor": "()V",
          "access_flags": 65544,
          "bytecode_hash": "2552c2aefad67c2d666996fc73085a74",
          "instruction_count": 4,
          "api_calls": [
            21
          ],
          "constants": [],
          "opcode_distribution": {
            "34": 1,
            "112": 1,
            "105": 1,
            "14": 1
          },
          "cfg": {
            "basic_blocks": 1,
            "edges": 0,
            "exception_handlers": 0
          },
          "registers": 1
        },
        "<init>()V": {
          "name": "<init>",
          "descriptor": "()V",
          "access_flags": 65536,
          "bytecode_hash": "0e486b2e5a245ee4b0e601cc7ddbbce9",
          "instruction_count": 3,
          "api_calls": [
            61
          ],
          "constants": [
            [
              "numeric",
              3
            ]
          ],
          "opcode_distribution": {
            "18": 1,
            "112": 1,
            "14": 1
          },
          "cfg": {
            "basic_blocks": 1,
            "edges": 0,
            "exception_handlers": 0
          },
5.2 Calcul des métriques de ressemblance
Lorsqu'elle compare une classe obfusquée à des bases de signatures, DalvikFLIRT emploie un calcul de similarité pondéré. Les différentes composantes contribuent au score global en fonction de leur résilience à l'obfuscation :
METHOD_WEIGHTS = {
    "bytecode_hash": 0.0,
    "descriptor": 0.25,
    "constants": 0.25,
    "opcode_distribution": 0.3,
    "cfg": 0.2,
}

CLASS_WEIGHTS = {
    "metrics": 0.2,
    "superclass": 0.1,
    "interfaces": 0.1,
    "fields": 0.1,
    "methods": 0.5,
}
Les descripteurs de méthode sont très fiables, car les types de paramètres et les valeurs de retour changent rarement sans casser la fonctionnalité. Les constantes de chaînes de caractères survivent souvent à l'obfuscation de base et fournissent des indices sémantiques. La distribution des opcodes crée une empreinte statistique du comportement de la méthode, tandis que la structure du graphe de flot de contrôle reflète les schémas logiques qui doivent être préservés pour un fonctionnement correct.
Au niveau de la classe, les métriques de classe (comme le nombre de méthodes et de champs), les relations d'héritage et les implémentations d'interfaces contribuent toutes à l'identification. L'approche pondérée signifie que DalvikFLIRT peut reconnaître des correspondances même lorsque certains aspects ont changé, pourvu qu'il reste suffisamment de caractéristiques distinctives.

5.3 L'outil en action
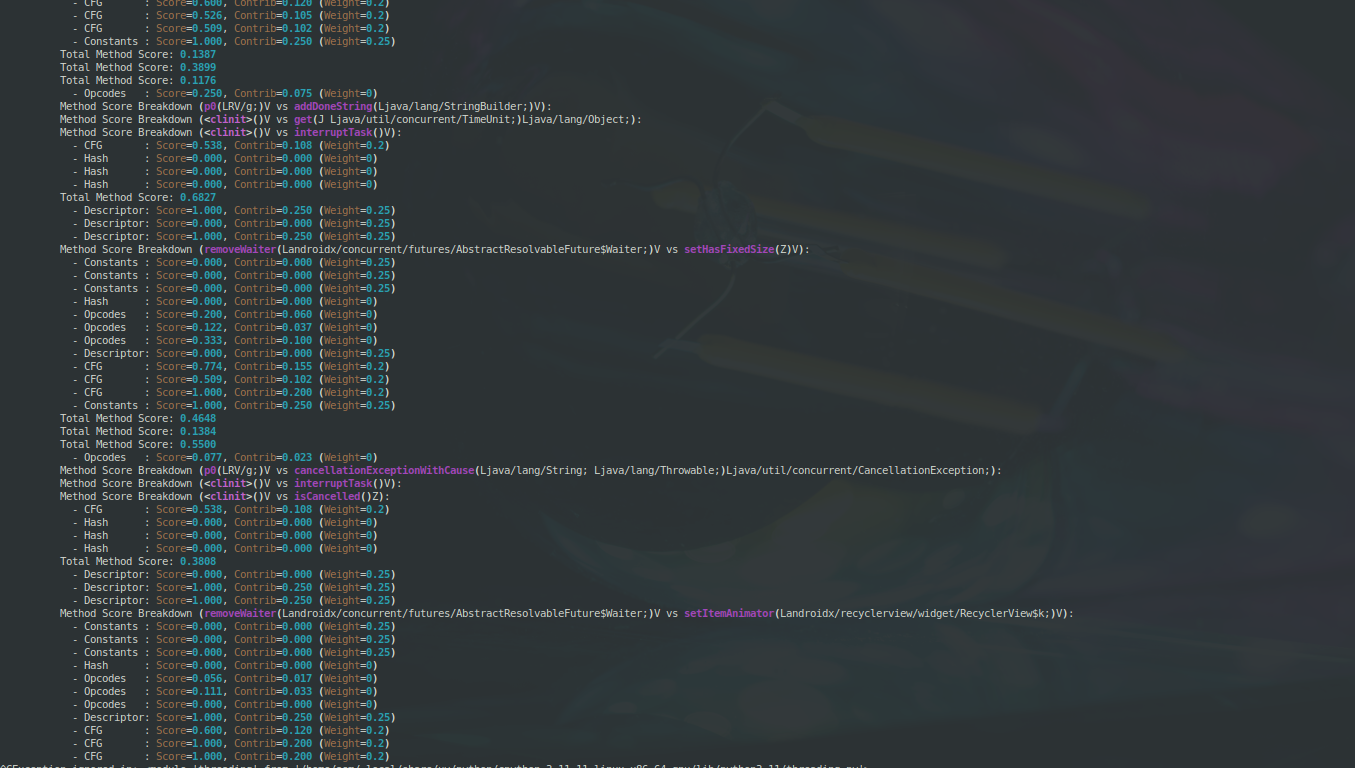
Lors de tests en conditions réelles, nous avons appliqué DalvikFLIRT à des applications populaires, certaines comptant plus de 250 000 classes. La sortie suivante montre un exemple de correspondance :
DalvikFLIRT Simplified Signature Matcher
Signatures1: tests/files/app-debug_signatures.json
Signatures2: tests/files/Media_APKPure_signatures.json
Output: matches_media.json
Threshold: 0.8

Loading signatures from tests/files/app-debug_signatures.json
Loaded 12288 class signatures
Loading signatures from tests/files/media_APKPure_signatures.json
Loaded 279796 class signatures
Le matcher a identifié que la classe obfusquée LX/i7X correspond à Landroidx/concurrent/futures/AbstractResolvableFuture avec une confiance de 83,9 % :
Class Score Breakdown (LX/i7X; vs Landroidx/concurrent/futures/AbstractResolvableFuture;):
  - Metrics     : Score=0.451, Contrib=0.090 (Weight=0.2)
  - Superclass  : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Interfaces  : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Fields      : Score=1.000, Contrib=0.100 (Weight=0.1)
  - Methods     : Score=0.898, Contrib=0.449 (Weight=0.5)
Total Class Score: 0.8390
Cette identification fonctionne malgré une obfuscation complète des noms. Par exemple, la méthode nommée addListener dans le code d'origine a été renommée LIZJ(Ljava/lang/Runnable; Ljava/util/concurrent/Executor;)V dans la version obfusquée. DalvikFLIRT les a correctement appariées d'après leurs types de paramètres, leur flot de contrôle et leurs schémas d'opcodes.
6. Et le reste du code : réécritures de code par LLM
Si DalvikFLIRT excelle à faire correspondre des composants connus du SDK Android et des bibliothèques courantes, il ne fonctionne pas pour le code d'application sur mesure, qui n'a aucune signature de référence connue. C'est là que nous mettons à profit la puissance des grands modèles de langage pour proposer une approche complémentaire.
6.1 Réécriture de code par LLM
Les grands modèles de langage modernes ont des capacités remarquables pour comprendre, générer et transformer du code à partir des schémas qu'ils ont appris dans de vastes dépôts de code. Nous avons découvert que ces LLM peuvent effectivement inverser de nombreux types d'obfuscation en déduisant le sens à partir du contexte et de la structure.
L'idée clé de notre approche est de reformuler le problème. Plutôt que de demander aux modèles de « désobfusquer » du code (ce que beaucoup refusent de faire par crainte d'un usage détourné), nous présentons la tâche comme « l'amélioration de la lisibilité du code » - une distinction subtile mais importante, qui permet aux modèles de s'engager dans la tâche :
deobfuscator_agent = Agent(
    large_model,
    system_prompt=(
        "You are an expert Java developer. Given hard to read Java source code, "
        "your task is to: \n"
        "Rewrite the code to make it more readable.\n"
        "Please make sure to rewrite the whole code and DO NOT omit any function or method.\n"
        "Improve the quality of the code. Focus on renaming variables, methods, "
        "and classes to be more descriptive names based on their context and usage. "
        "Maintain the original code's functionality. If no context is provided, "
        "do your best to rewrite based on the code alone."
        "Feel free to rewrite control flow to make the code easier to understand."
        "Do NOT change string constants as these might be used by other apps."
    ),
)
6.2 Le système multi-agents
Notre implémentation utilise un système multi-agents coordonné, dans lequel des composants spécialisés collaborent pour améliorer progressivement la compréhension du code :
- Le Deobfuscation Agent réécrit le code obfusqué pour le rendre clair tout en préservant la fonctionnalité, en s'attachant à fournir des noms significatifs et à simplifier les structures de contrôle complexes.
- L'Explainer Agent fournit des descriptions en langage clair de ce que fait le code, en identifiant les entrées, les sorties et les comportements clés. Cela aide à fournir du contexte pour la suite de l'analyse.
Le Context-Building Agent intègre les informations issues de composants déjà identifiés (comme ceux mis en correspondance par DalvikFLIRT) pour éclairer l'analyse des sections inconnues.
Plutôt que de fonctionner indépendamment, ces agents partagent des informations et créent une boucle de rétroaction qui améliore progressivement la compréhension à mesure que davantage de code est traité.
# Initialize the AI agent for deobfuscation
deobfuscator_agent = Agent(
    # model,
    large_model,
    system_prompt=(
        "You are an expert Java developer. Given an hard to read Java source code, "
        "your task is to: \n"
        "Rewrite the code to make it more readable.\n"
        "Please make sure to rewrite the whole code and DO NOT omit any function or method.\n"
        "and improve the quality of the code. Focus on renaming variables, methods, "
        "and classes to more descriptive names based on their context and usage."
        "DO NOT keep short or cryptic variable, classes and method names. "
        "Maintain the original code's functionality. If no context is provided, "
        "do your best to rewrite based on the code alone."
        "Feel free to rewrite control flow to make the code easier to understand."
        "Do NOT change string constant as these might be used by other apps."
    ),
)

# Initialize the AI agent for code explanation
code_explainer = Agent(
    model,
    system_prompt=(
        "You are an expert code explainer. Analyze the provided source code and explain it in plain English. "
        "Be thorough and cover: \n"
        "1. The code's purpose and functionality\n"
        "2. Inputs it expects\n"
        "3. Outputs it produces\n"
        "4. Edge cases and error handling\n"
        "Use clear, simple language suitable for developers of all levels."
    ),
    result_type=CodeExplanation,
)
6.3 Prompt engineering pour des résultats optimaux
L'efficacité de notre approche fondée sur les LLM dépend fortement de la qualité des prompts. Nous avons mis au point plusieurs techniques qui produisent systématiquement de meilleurs résultats :
Plutôt que de mentionner directement « obfuscation » ou « désobfuscation », nous formulons la tâche comme l'amélioration de la lisibilité d'un code « difficile à lire ». Ce changement subtil évite de déclencher les filtres de sécurité des modèles.
Nous fournissons comme points de référence du contexte issu des API Java et Kotlin, de bibliothèques non obfusquées et de composants identifiés par DalvikFLIRT. Par exemple, si nous savons que l'application appelle une méthode de chiffrement identifiée, cette connaissance aide le LLM à interpréter correctement le code environnant.
Notre processus commence par les méthodes plus simples qui ont moins de dépendances, puis s'attaque progressivement aux composants plus complexes. Cela permet au LLM de construire le contexte graduellement, en utilisant les informations des analyses précédentes pour éclairer les suivantes.
Des instructions claires sur ce qu'il faut préserver (la fonctionnalité) et ce qu'il faut améliorer (les noms, la structure) aident à orienter le modèle vers des transformations utiles plutôt qu'un simple reformatage.
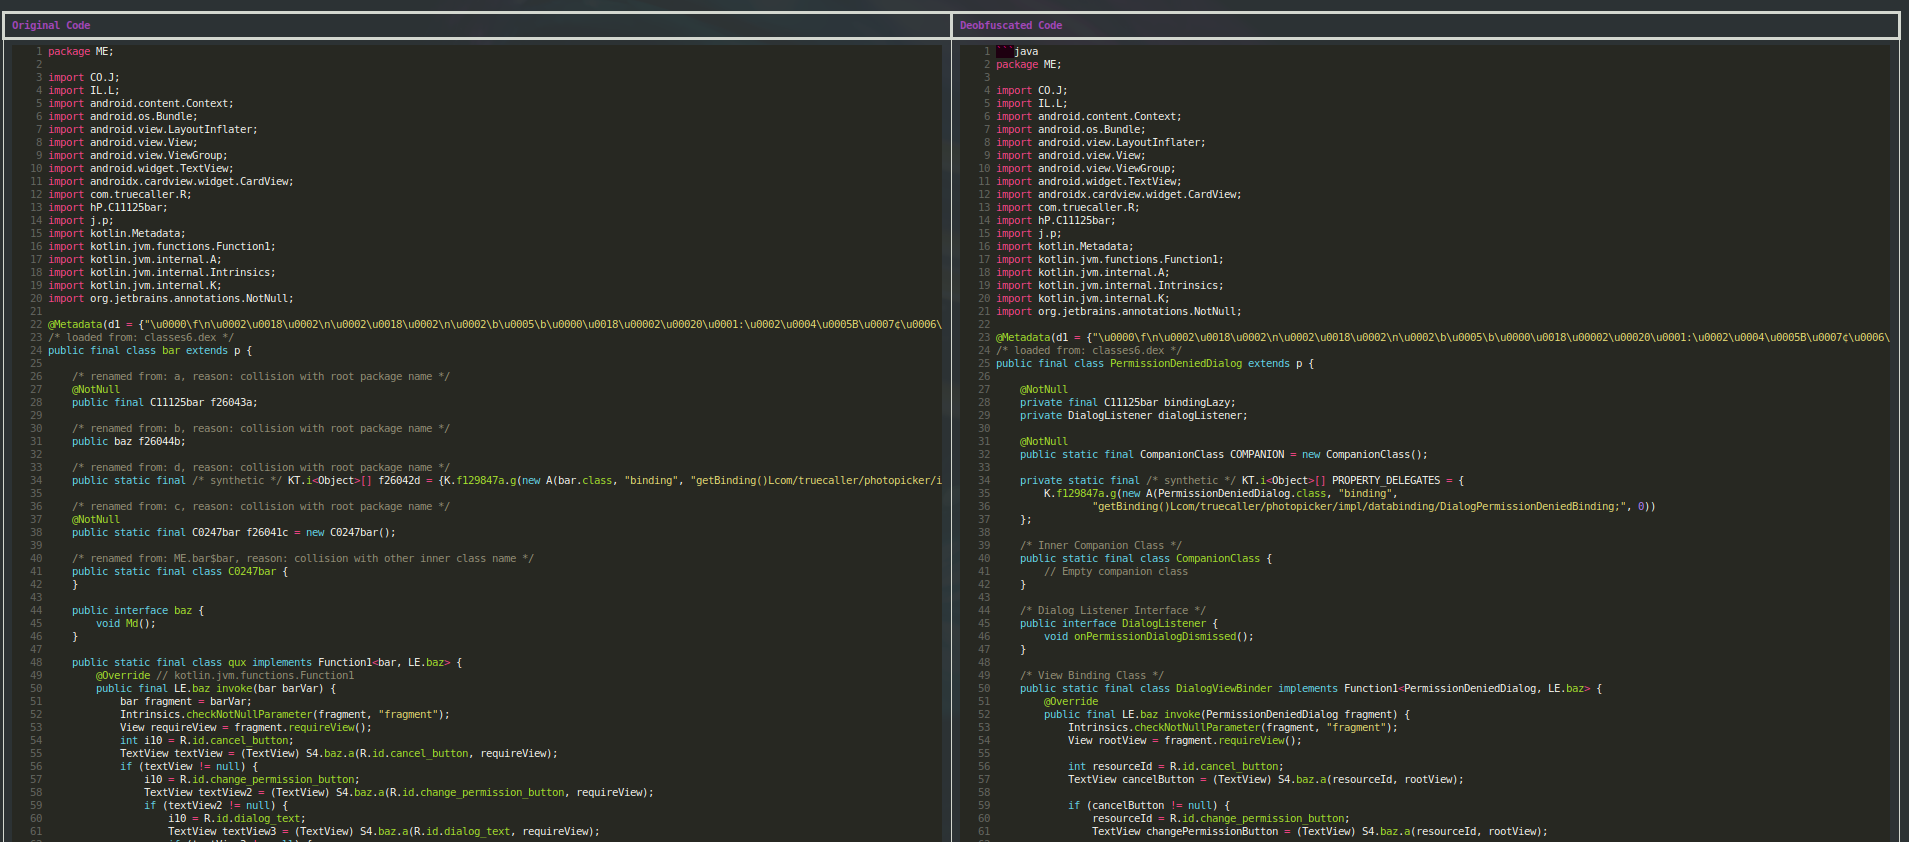
Voici un exemple de ce que notre système peut accomplir :
// Original obfuscated code
public static void a(long j, String str, int i, Object obj) {
    if (obj != null && c.e(str) && i >= 0) {
        new Thread(new d(j, str, i, obj)).start();
    }
}

// LLM-deobfuscated code
public static void logEventAsync(long userId, String eventName, int eventType, Object eventData) {
    if (eventData != null && ValidationUtils.isValidEventName(eventName) && eventType >= 0) {
        new Thread(new EventLoggingTask(userId, eventName, eventType, eventData)).start();
    }
}
La version désobfusquée fournit non seulement des noms significatifs qui révèlent l'objectif de la méthode, mais elle déduit aussi le sens probable des classes composantes d'après la façon dont elles sont utilisées.
6.4 L'analyse récursive ascendante
Nous avons constaté que la combinaison de la recherche de correspondances par signatures de DalvikFLIRT et des réécritures par LLM fonctionne mieux dans une approche récursive ascendante. Voici comment le processus se déroule :
Tout d'abord, nous construisons un graphe d'appels complet qui montre comment toutes les méthodes de l'application sont liées entre elles. Cette cartographie révèle quelles méthodes appellent quelles autres, et crée une hiérarchie de dépendances.
Nous identifions ensuite les « méthodes feuilles » - celles qui n'appellent pas d'autres méthodes. Ces fonctions plus simples constituent des points de départ idéaux pour l'analyse, car elles ont moins de dépendances.
Une fois notre premier ensemble de méthodes désobfusquées (certaines par la correspondance de signatures de DalvikFLIRT, d'autres par l'analyse du LLM), nous remontons l'arbre d'appels vers les méthodes qui utilisent ces fonctions désormais comprises. Les méthodes précédemment analysées fournissent un contexte précieux pour comprendre ce que font ces fonctions de plus haut niveau.
En continuant à remonter l'arbre d'appels, nous construisons une compréhension de plus en plus riche du comportement de l'application. Chaque nouvelle méthode bénéficie du contexte de toutes les méthodes déjà analysées qu'elle appelle.
Pensez-y comme à de l'archéologie - nous commençons par comprendre les artefacts les plus simples, puis nous utilisons ces connaissances pour interpréter les plus complexes, et reconstituons peu à peu toute la civilisation à partir de zéro.
Le code suivant montre comment une méthode est analysée dans ce système sensible au contexte :
def analyze_method(self, node: MethodNode) -> Dict:
    """
    Perform full AI analysis on a method including explanation, deobfuscation and security audit.
    """
    # Get source code
    class_source_code = self.methods_engine.get_class_source(node)
    method_source_code = self.methods_engine.get_method_source(node)

    # Get context from callees (methods this one calls)
    callee_info = self.methods_engine.get_callees(node)

    # Deobfuscate the code using both DalvikFLIRT and LLM approaches
    deobfuscated_code = self.deobfuscate_code(
        class_source_code,
        method_source_code,
        context=callee_info
    )

    # Generate a human-readable explanation
    explanation = self.explain_code(deobfuscated_code, node)

    # Store results for use as context in analyzing methods that call this one
    return {
        'source_code': method_source_code,
        'deobfuscated_code': deobfuscated_code,
        'explanation': explanation,
        'security_issues': security_audit,
    }
En combinant ces techniques - l'identification par signatures de DalvikFLIRT pour les composants connus et la réécriture de code par LLM pour la logique propre à l'application - nous avons créé un système capable de désobfusquer efficacement même des applications Android fortement protégées.
Conclusion et perspectives
Notre approche duale, qui associe la reconnaissance par signatures de DalvikFLIRT et les réécritures par LLM, crée un système puissant pour contourner l'obfuscation dans les applications Android. Cette approche nous donne des capacités sans précédent pour comprendre un code qui resterait autrement impénétrable.
Le principal atout de notre méthodologie est d'identifier automatiquement, avec un haut niveau de confiance, les composants du SDK Android, puis de les utiliser comme ancres contextuelles pour générer du code de haute qualité pour la logique propre à l'application. Le système gère simultanément plusieurs techniques d'obfuscation, de la simple obfuscation des noms à des manipulations plus complexes du flot de contrôle.
L'approche récursive ascendante signifie que le système gagne progressivement en efficacité à mesure qu'il analyse davantage de code, chaque nouvel enseignement améliorant les analyses suivantes.
Ce travail ne vise pas à affaiblir la sécurité, mais à faire progresser les capacités d'automatisation. En rendant le code obfusqué compréhensible, nous permettons une analyse de sécurité et une détection de vulnérabilités plus approfondies.
Tags :
ai