MongoDB : un use-after-free dans les replica sets permet un crash non authentifié (CVE-2026-118383)
Des requêtes non authentifiées peuvent faire planter un primaire MongoDB en retard avant 4.4.32, 5.0.35, 6.0.30, 7.0.48, 8.0.37, 8.3.16 et 9.0.7.
En bref
- Un use-after-free dans la phase de rattrapage de MongoDB permet à un client non authentifié de déposer des waiters qui font planter un membre du replica set lorsqu'il devient primaire. MongoDB a publié CVE-2026-118383 le 10 novembre 2026.
- Tous les membres d'un replica set des branches concernées sont exposés, y compris les membres des shards et des serveurs de configuration. Un
mongodautonome ne fait pas de rattrapage et n'est pas concerné. - MongoDB la note CVSS v4.0 9,5 Critique. Datadog a reproduit un crash ; une exécution de code reste possible selon MongoDB. Aucune attaque signalée, et elle n'est pas dans le KEV de la CISA au 13 novembre 2026.
- Mettez à niveau chaque membre vers la version corrigée de sa branche : 4.4.32, 5.0.35, 6.0.30, 7.0.48, 8.0.37, 8.3.16 ou 9.0.7. Voir « Comment corriger ? » pour Atlas et les conteneurs.
Suis-je concerné ?
Vous êtes exposé lorsque toutes les conditions suivantes sont réunies :
- Le serveur est membre d'un replica set MongoDB, y compris un membre de shard ou de serveur de configuration dans un cluster shardé.
- Sa version se trouve dans l'une des plages concernées du tableau.
- Un attaquant peut joindre le port MongoDB du membre et envoyer des commandes
pingqui portentreadConcern.afterOpTime. Sur les versions vulnérables, le serveur accepte ces requêtes avant de vérifier les identifiants, donc activer l'authentification ne bloque pas la préparation.
Un mongod autonome n'est pas exposé. Il n'a pas d'état de rattrapage de primaire et ne peut pas participer à l'élection nécessaire au crash.
Le crash exige aussi que le membre prenne du retard puis gagne une élection. L'attaquant ne peut provoquer ni l'un ni l'autre, donc les waiters déposés sont un piège qui se déclenche lors d'une vraie maintenance ou d'un basculement.
| Branche | Versions concernées | Version corrigée |
|---|---|---|
| 9.0 | 9.0.0 à 9.0.6 | 9.0.7 |
| 8.3 | 8.3.0 à 8.3.15 | 8.3.16 |
| 8.0 | 8.0.0 à 8.0.36 | 8.0.37 |
| 7.0 | 7.0.0 à 7.0.47 | 7.0.48 |
| 6.0 | 6.0.0 à 6.0.29 | 6.0.30 |
| 5.0 | 5.0.0 à 5.0.34 | 5.0.35 |
| 4.4 | 4.4.0 à 4.4.31 | 4.4.32 |
L'avis de MongoDB ne cite pas la branche 8.2, arrivée en fin de vie le 31 juillet 2026 et qui ne reçoit plus de correctifs. La preuve de concept publique indique que 8.2.12 présentait encore le bug dans un laboratoire utilisant un réglage réservé aux tests. Considérez 8.2 comme non pris en charge et migrez vers une branche corrigée.
Vérifiez la version de chaque membre, pas seulement du primaire :
# On each host, including members in containers and members that were offline
mongosh --quiet --eval 'db.version()'

# In a replica set, list every member and its state
mongosh --quiet --eval 'rs.status().members.map(m => m.name + " " + m.stateStr)'

# Docker
docker exec <container> mongosh --quiet --eval 'db.version()'

# Kubernetes, for each member pod
kubectl exec <pod> -- mongosh --quiet --eval 'db.version()'
rs.status() renvoie une erreur sur un serveur autonome, ce qui confirme que cet hôte n'est pas membre d'un replica set. Pour Atlas, ouvrez les réglages de maintenance du cluster ; MongoDB indique que les clusters sont mis à niveau automatiquement pendant la maintenance.
Comment corriger ?
Mettez à niveau chaque membre du replica set vers la version corrigée de sa branche. Une mise à niveau partielle laisse les autres membres exposés, et une élection ultérieure peut transférer le rôle de primaire à l'un d'eux.
- Sauvegardez le déploiement et confirmez la version corrigée de chaque branche sur la page de téléchargement de l'éditeur.
- Mettez à niveau un membre à la fois et laissez-le rejoindre le set avant de passer au suivant. Dans un replica set, faites d'abord descendre le primaire, ou mettez à niveau un secondaire, pour que le set conserve un primaire pendant l'opération.
- Après chaque mise à niveau, exécutez
db.version()sur le membre et confirmez la version corrigée. Vérifiez aussi les membres qui étaient hors ligne pendant la fenêtre de maintenance. - Pour Docker, téléchargez l'image corrigée et recréez le conteneur. Remplacer l'image sans recréer le conteneur laisse l'ancien processus en marche. La preuve de concept publique utilise
mongodb/mongodb-community-server:8.0.37-ubi9pour son test de contrôle corrigé. - Pour Atlas, appliquez la maintenance en attente. Si le projet diffère la maintenance, MongoDB recommande d'appliquer la mise à niveau dès que possible.
Aucun réglage du serveur ne désactive le chemin de rattrapage vulnérable. Restreindre l'accès réseau au membre, par exemple aux hôtes applicatifs et aux autres membres, réduit le nombre de clients qui peuvent déposer les waiters. Cela ne supprime pas les waiters déjà déposés et ne corrige pas la course. Gardez cette restriction seulement jusqu'à ce que tous les membres soient à niveau.
Les versions corrigées changent deux choses. Le callback de rattrapage ne conclut plus qu'un état de rattrapage vivant et courant, et seuls les utilisateurs internes peuvent envoyer readConcern.afterOpTime. Les deux changements sont nécessaires : le premier arrête le double nettoyage, le second empêche un client de déposer les waiters.
Quelle est la cause racine ?
Le callback de fin de rattrapage du primaire détenait un pointeur brut vers un état de rattrapage qui peut se libérer pendant son exécution. Un rattrapage interrompu rappelle donc abort_inlock() sur une mémoire libérée.
ReplicationCoordinatorImpl conserve un CatchupState pendant qu'un primaire nouvellement élu applique les opérations manquées. L'état enregistre un waiter dans _lastAppliedOpTimeWaiterList, un multimap indexé par OpTime. Quand l'OpTime appliqué atteint la cible, le waiter se termine et le callback appelle abort_inlock() pour quitter le mode de rattrapage. abort_inlock() remet _catchupState à zéro, ce qui détruit l'objet d'état.
Le callback vulnérable ignorait le statut de fin et ne vérifiait pas que son état était toujours le courant. Dans MongoDB 8.0.34, à la ligne 5267 de src/mongo/db/repl/replication_coordinator_impl.cpp, le callback est :
auto targetOpTimeCB = [this](Status status) {
    // Double check the target time since stepdown may signal us too.
    const auto myLastApplied = _repl->_getMyLastAppliedOpTime_inlock();
    if (_targetOpTime <= myLastApplied) {
        ...
        abort_inlock(PrimaryCatchUpConclusionReason::kSucceeded);
    }
};
L'état était détenu par un std::unique_ptr, donc l'objet n'avait pas de durée de vie partagée. L'en-tête déclare à la ligne 1972 std::unique_ptr<CatchupState> _catchupState;.
La preuve de concept publique ajoute l'étape manquante. Deux waiters readConcern.afterOpTime avec des termes OpTime choisis créent un cycle d'ordre dans le multimap, donc le vrai waiter de rattrapage n'est jamais atteint par setValueIf_inlock(). Le battement de cœur suivant conclut que le membre est déjà à jour et interrompt le rattrapage. Cette interruption réinitialise le waiter non satisfait, ce qui exécute le callback de façon synchrone. Le callback appelle de nouveau abort_inlock(), et la trame extérieure continue de lire l'état que l'appel intérieur a libéré.
Comment la faille est-elle exploitée ?
- L'attaquant envoie deux commandes
pingnon authentifiées avecreadConcern.afterOpTimeà un membre joignable. Les termes OpTime choisis trient mal les waiters dans le multimap, donc le vrai waiter de rattrapage ne peut pas se terminer. - Les waiters restent en place. Ils n'expirent pas et survivent jusqu'au redémarrage du membre, à un rollback ou à sa descente du rôle de primaire.
- Le membre prend ensuite du retard sur un autre membre et gagne une élection. L'attaquant ne peut provoquer ni le retard ni l'élection, donc cette étape dépend d'une vraie maintenance ou d'une panne.
- À la fin du rattrapage, le nettoyage s'exécute deux fois. Le nouveau primaire lit et écrit une mémoire déjà libérée, et plante avant d'accepter des écritures.
- Datadog a reproduit le crash sur 8.0.34 avec une erreur de segmentation dans
CatchupState::abort_inlock(). Le laboratoire a utilisé un accès administrateur pour suspendre un membre et forcer le basculement ; seules les deux requêtes ping venaient d'un client non authentifié.
L'avis de MongoDB indique que la faille peut aussi permettre une exécution de code arbitraire dans le processus serveur dans certaines conditions. Datadog n'a pas obtenu d'exécution de code dans son laboratoire et ne prétend pas que le crash est fiable dans tous les déploiements.
Comment se déroule l'attaque ?
Un client non authentifié dépose deux waiters afterOpTime, un basculement ultérieur rend ce membre primaire alors qu'il est en retard, et le nettoyage du rattrapage s'exécute deux fois sur une mémoire libérée.
avec readConcern.afterOpTime"] --> B["Waiters stockés dans le
multimap lastAppliedOpTime"] B --> C["L'ordre des OpTime laisse le
vrai waiter de rattrapage inachevé"] C --> D["Le membre prend du retard,
puis gagne une élection"] D --> E["Le rattrapage se termine et
abort_inlock() réinitialise le waiter"] E --> F["Le callback rappelle
abort_inlock() sur l'état libéré"] F --> G["Le nouveau primaire plante
avant d'accepter des écritures"]
Que peut faire un attaquant ?
Un attaquant non authentifié peut faire planter un membre du replica set au moment où il devient primaire, ce qui retire le primaire du set et interrompt les écritures jusqu'à ce qu'un autre membre prenne le relais.
L'impact dépend du rôle du membre qui plante :
- Un primaire de replica set normal qui plante provoque une élection et une courte interruption des écritures. Un autre membre peut prendre le relais s'il est disponible.
- Un primaire de shard qui plante peut bloquer les opérations routées vers ce shard jusqu'à l'élection d'un nouveau primaire.
- Un primaire de serveur de configuration qui plante peut bloquer les changements de métadonnées du cluster jusqu'à ce que le set de configuration élise un nouveau primaire.
Les conditions font partie de l'impact :
- L'attaquant doit pouvoir joindre le port MongoDB du membre.
- La requête ne demande ni compte ni interaction de l'utilisateur.
- Le membre doit ensuite gagner une élection alors qu'il est en retard sur un autre membre. L'attaquant ne peut pas le forcer, donc le crash est un piège différé plutôt qu'une attaque immédiate.
- Un
mongodautonome n'est pas concerné.
MongoDB indique que la faille peut permettre une exécution de code arbitraire dans certaines conditions. Aucune source ne démontre cette exécution, et la reproduction de Datadog s'est terminée par un crash. Considérez l'exécution de code comme une évaluation de l'éditeur, pas comme une capacité démontrée.
Pourquoi le correctif fonctionne-t-il ?
Le correctif donne une durée de vie partagée à l'état de rattrapage et fait vérifier au callback le statut du waiter et le fait que son état est toujours courant. Le callback ne peut plus exécuter abort_inlock() une seconde fois.
Le diff entre MongoDB 8.0.34 et 8.0.37 change la propriété et le callback :
-    _catchupState = std::make_unique<CatchupState>(this);
+    _catchupState = std::make_shared<CatchupState>(this);
...
-    auto targetOpTimeCB = [this](Status status) {
+    auto targetOpTimeCB = [weakSelf = weak_from_this()](Status status) {
+        if (!status.isOK()) {
+            return;
+        }
+        auto self = weakSelf.lock();
+        if (!self || self->_repl->_catchupState != self) {
+            return;
+        }
         const auto myLastApplied = _repl->_getMyLastAppliedOpTime_inlock();
         if (_targetOpTime <= myLastApplied) {
             ...
-            abort_inlock(PrimaryCatchUpConclusionReason::kSucceeded);
+            self->abort_inlock(PrimaryCatchUpConclusionReason::kSucceeded);
         }
     };
L'en-tête fait hériter CatchupState de std::enable_shared_from_this<CatchupState> et le détient dans un std::shared_ptr. Le callback garde un weak_ptr, donc il ne peut conclure qu'un état encore vivant et encore installé dans _catchupState. Un statut non OK signifie qu'un autre chemin a déjà conclu le rattrapage, et le callback revient sans toucher l'état.
Le second correctif, le commit 6111165c32, exige le privilège d'utilisateur interne pour un readConcern.afterOpTime fourni par le client. Cela supprime la condition de dépôt des waiters pour les clients ordinaires. Les deux commits forment le correctif de 8.0.37 ; l'éditeur liste les versions corrigées correspondantes pour chaque branche concernée.
Comment vérifier si j'ai été compromis ?
Aucune exploitation n'a été signalée et aucun indicateur de compromission n'a été publié. Les vérifications cherchent la signature du crash et les requêtes des waiters dans les journaux du serveur.
- Cherchez une entrée
Slow queryavec l'identifiant de log 51803 pour unpingnon authentifié qui portaitreadConcern.afterOpTimeet s'est terminé parMaxTimeMSExpired. - Cherchez un membre qui entre en rattrapage de primaire (identifiant 21359) puis en sort deux fois (identifiant 21363) dans une même transition.
- Cherchez un signal fatal ou une trace qui nomme
CatchupState::abort_inlock()après ces deux sorties. - Consultez les journaux antérieurs du même membre. Les deux requêtes peuvent arriver avant le basculement, et un membre qui devient primaire plus tard les conserve.
Une élection normale ou une seule sortie de rattrapage ne correspond pas à ce schéma. La présence des champs de requête dans le journal dépend des réglages de journalisation, et le champ attr.remote peut afficher une adresse de bouclage au lieu de l'adresse réelle du client. Une tentative qui échoue peut ne laisser aucune trace.
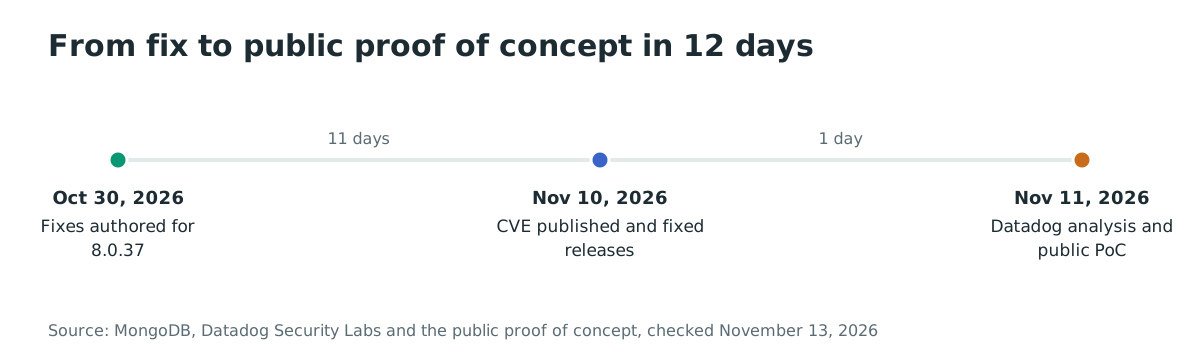
Chronologie
- 2026-10-30 : MongoDB rédige les deux correctifs du hotfix 8.0.37, l'un pour l'état de rattrapage et l'autre pour
readConcern.afterOpTime. - 2026-11-10 : MongoDB publie CVE-2026-118383 à 20 h 23 UTC et diffuse les versions corrigées. Les deux commits de correctif arrivent à 23 h 07 et 23 h 09 UTC.
- 2026-11-11 : Datadog Security Labs publie son analyse et sa reproduction, et la preuve de concept publique est créée.
- 2026-11-12 : The Hacker News relaie la faille et la déclaration de MongoDB, qui ne connaît pas d'exploitation.
- 2026-11-13 : le catalogue KEV de la CISA ne liste pas la CVE.
FAQ
CVE-2026-118383 est-elle exploitée en environnements réels ?
Non. MongoDB indique avoir trouvé la faille en interne et ne pas avoir connaissance de tentatives d'exploitation. La CVE n'est pas dans le catalogue KEV de la CISA au 13 novembre 2026.
L'authentification bloque-t-elle l'attaque ?
Non, pas sur une version concernée. Les deux commandes ping sont acceptées avant la vérification des identifiants, ce qui a permis à Datadog de déposer les waiters avec un client non authentifié. Le correctif de 8.0.37 rejette un readConcern.afterOpTime fourni par un client qui n'est pas un utilisateur interne.
Un mongod autonome peut-il planter de cette façon ?
Non. Un serveur autonome n'a ni replica set ni état de rattrapage de primaire, donc le double nettoyage qui provoque le use-after-free ne peut pas s'exécuter. L'avis exclut les instances autonomes.
L'attaquant peut-il forcer le basculement ?
Non. L'attaquant peut déposer les waiters, mais le membre doit prendre du retard et gagner une élection de lui-même. Dans le laboratoire de Datadog, les chercheurs ont utilisé un accès administrateur pour suspendre un membre et déclencher l'élection ; seules les deux requêtes étaient non authentifiées.
Qu'arrive-t-il à un cluster Atlas ?
MongoDB indique que les clusters Atlas sont mis à niveau automatiquement vers les versions corrigées pendant la maintenance du cluster. Si le projet diffère la maintenance, MongoDB recommande d'appliquer la mise à niveau dès que possible.
J'utilise la branche 8.2. Est-elle corrigée ?
L'avis ne cite pas 8.2, arrivée en fin de vie le 31 juillet 2026. La preuve de concept publique indique que 8.2.12 présentait encore le bug avec un réglage réservé aux tests. Migrez le déploiement vers une branche prise en charge et une version corrigée.
Trouver les membres MongoDB exposés avec Ostorlab
La découverte de surface d'attaque d'Ostorlab inventorie les hôtes et services exposés à Internet de votre parc. Utilisez-la pour lister les ports MongoDB que vous exposez, afin de savoir quels membres mettre à niveau ou restreindre en premier. C'est un inventaire des hôtes exposés, pas une détection de cette CVE.
Références
- Enregistrement CVE-2026-118383, CNA MongoDB, publié le 2026-11-10, CVSS v4.0 9.5 et CVSS v3.1 9.0 : https://www.cve.org/CVERecord?id=CVE-2026-118383 (vérifié le 13 novembre 2026)
- MongoDB, « Important MongoDB security update available (Action Required) - November 10, 2026 », la déclaration de l'éditeur et les consignes de maintenance Atlas : https://www.mongodb.com/community/forums/t/important-mongodb-security-update-available-action-required-november-10-2026/344843 (vérifié le 13 novembre 2026)
- Datadog Security Labs, « CVE-2026-118383: Use-after-free vulnerability in MongoDB », 11 novembre 2026, la reproduction, les journaux du crash et les conditions d'exploitation : https://securitylabs.datadoghq.com/articles/cve-2026-118383-mongodb-server-use-after-free/ (vérifié le 13 novembre 2026)
- Preuve de concept et analyse publiques, le déclencheur à deux requêtes, le cycle d'ordre des waiters et les commits de correctif : https://github.com/googlesky/CVE-2026-118383 (vérifié le 13 novembre 2026)
- Commit de correctif 23dfc542199ab3b88d6a9420b6cd3f125a897620, « SERVER-138175 [v8.0.37-hotfix] Conclude primary catch-up only from a live, current catch-up state », fusionné le 2026-11-10 : https://github.com/mongodb/mongo/commit/23dfc542199ab3b88d6a9420b6cd3f125a897620 (vérifié le 13 novembre 2026)
- Commit de correctif 6111165c32bfc74f197e2dfeb9480d0b52154d68, « SERVER-138119 [v8.0.37-hotfix] Allow only internal users to use readConcern.afterOpTime », fusionné le 2026-11-10 : https://github.com/mongodb/mongo/commit/6111165c32bfc74f197e2dfeb9480d0b52154d68 (vérifié le 13 novembre 2026)
- Source MongoDB 8.0.34, le callback vulnérable à la ligne 5267 de
src/mongo/db/repl/replication_coordinator_impl.cppet leunique_ptrà la ligne 1972 de l'en-tête : https://github.com/mongodb/mongo/blob/r8.0.34/src/mongo/db/repl/replication_coordinator_impl.cpp (vérifié le 13 novembre 2026) - Source MongoDB 8.0.37, le callback corrigé et la propriété partagée : https://github.com/mongodb/mongo/blob/r8.0.37/src/mongo/db/repl/replication_coordinator_impl.cpp (vérifié le 13 novembre 2026)
- Page de téléchargement de MongoDB, les builds corrigés de Community Server : https://www.mongodb.com/try/download/community (vérifié le 13 novembre 2026)
- Calendrier de cycle de vie de MongoDB, la fin de vie de 8.2 au 31 juillet 2026 : https://www.mongodb.com/legal/support-policy/lifecycles (vérifié le 13 novembre 2026)
- Docker Hub, l'image officielle
mongoet son nombre de téléchargements : https://hub.docker.com/_/mongo (vérifié le 13 novembre 2026) - Flux JSON du catalogue des vulnérabilités exploitées de la CISA, vérifié pour CVE-2026-118383 le 13 novembre 2026 (non listée) : https://www.cisa.gov/sites/default/files/feeds/known_exploited_vulnerabilities.json (vérifié le 13 novembre 2026)
- The Hacker News, « Critical Pre-Auth MongoDB Flaw (CVE-2026-118383) Can Crash Lagging Servers on Failover », 12 novembre 2026, la reproduction de Datadog et la déclaration de l'éditeur : https://thehackernews.com/2026/11/critical-pre-auth-mongodb-flaw-cve-2026.html (vérifié le 13 novembre 2026)