应用加固的设计目标并非牢不可破,而是让绕过足够困难,只有具备相应技能、工具和时间的资深攻击者才能做到。
这一前提正在开始改变。AI 模型可以帮助经验不足的攻击者理解受保护的代码,并操作尝试绕过所需的工具。
本周,我们来看看 AI 能在多大程度上降低绕过应用加固的成本。
本期还有:被投毒的 Rust crate、GitLab 严重漏洞遭快速利用、一个正被积极利用的 MLflow 漏洞、Copilot Personal 漏洞、AI 生成的脚本探测 Siemens PLC、用于二进制分析的 angr,以及更多内容。
本期内容
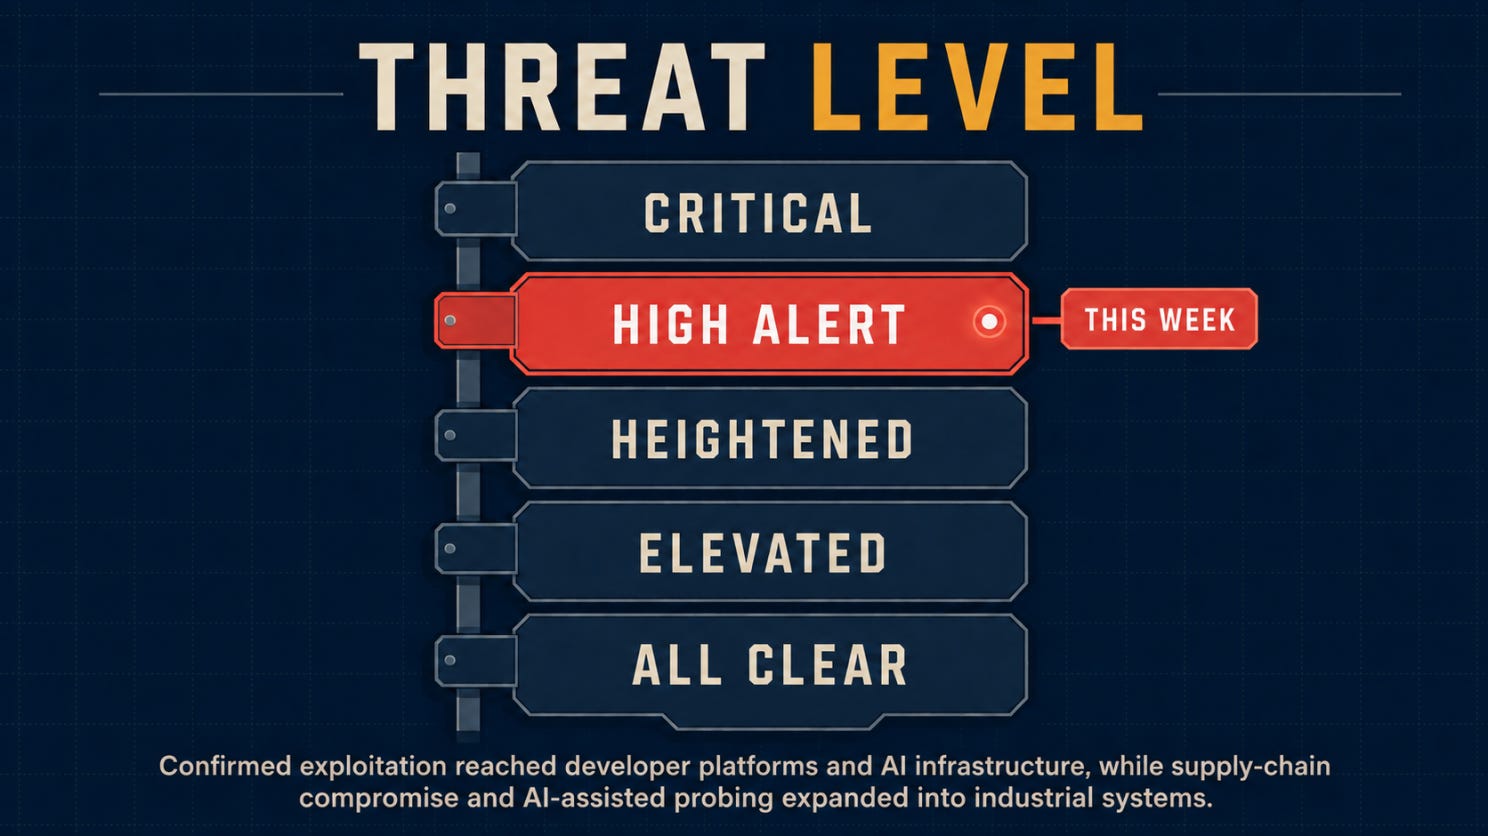
🌡️ 威胁等级:高度警戒
⚡ 新闻:值得了解的五则安全新闻
🔎 深度解析:应用加固绕过成本正在缩水
🎣 这是钓鱼吗?
🔬 技术研究:绕过五款生产环境银行应用的加固防护。
🛠️ 本周工具:angr
👤 本周人物:Connor Tumbleson
📅 本周活动:Defcamp 2026
📚 本周书籍:MacOS and iOS Internals
😅 本周梗图
❓ 离开前的一个问题
让我们开始吧。
在进入本周新闻之前,先看看当前的威胁等级。
🌡️威胁等级
⚡ 新闻
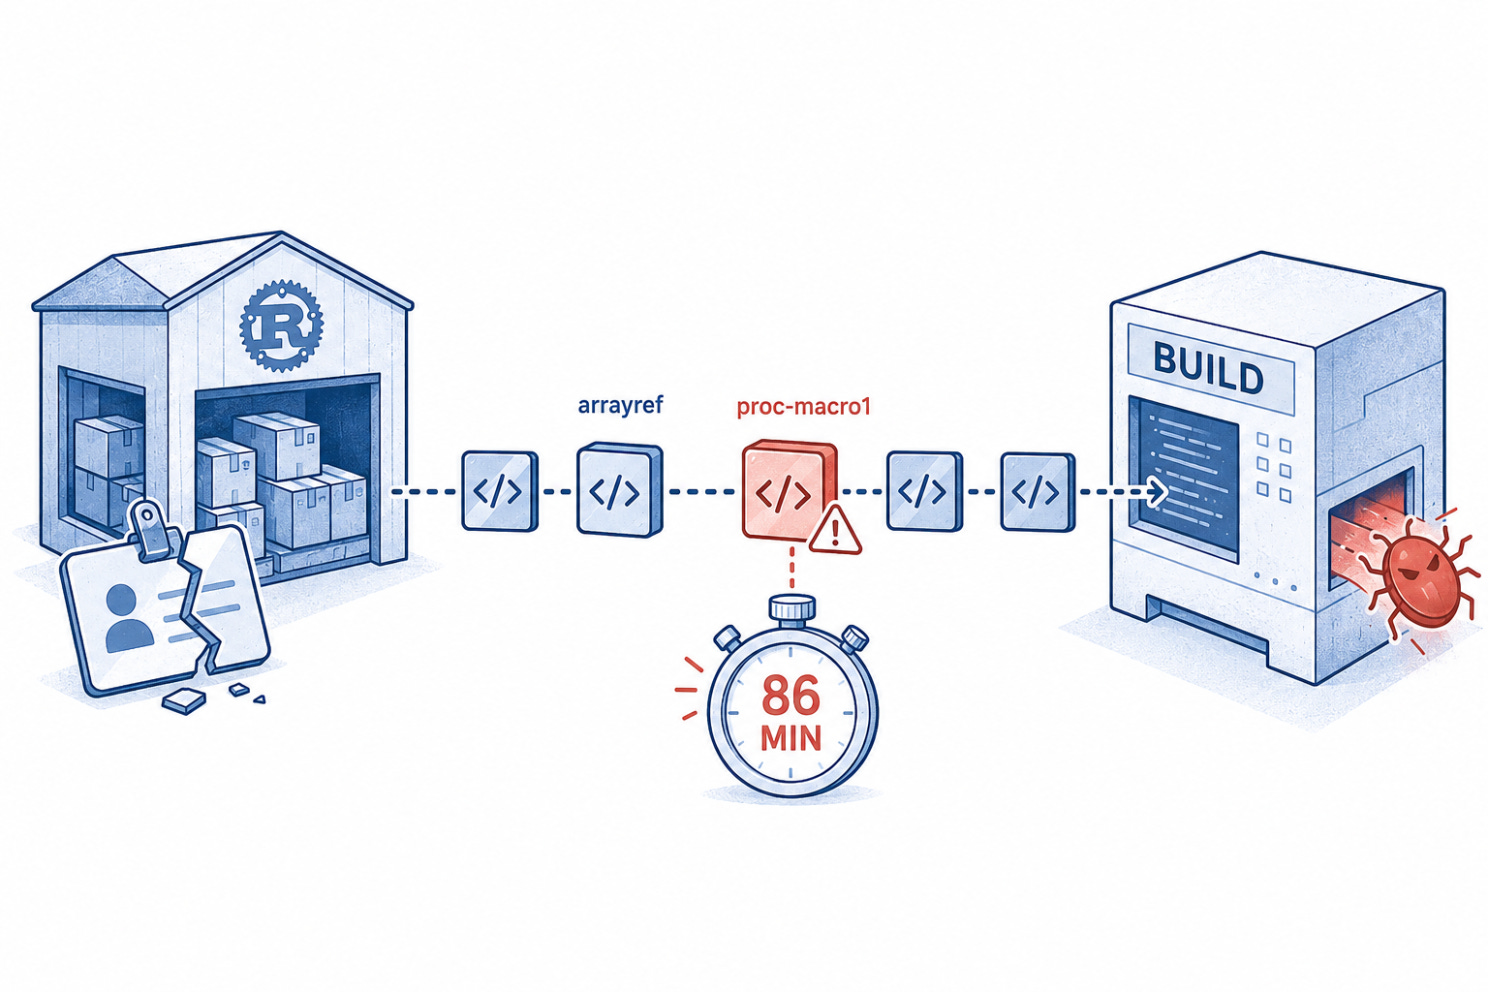
86 分钟足以给一次 Rust 构建投毒
Rust 团队表示,arrayref、internment 和 append-only-vec 的恶意版本出现在 crates.io 上,一名维护者的电脑或凭据很可能已遭入侵。被投毒的 arrayref 版本会拉取 proc-macro1,其构建脚本在编译期间下载恶意软件。Rust 在 86 至 107 分钟后移除了这些版本;RustSec 记录到 arrayref 0.3.10 被下载 2,285 次。请检查缓存和 lockfile,隔离构建 runner,并轮换在受影响构建期间暴露的凭据。
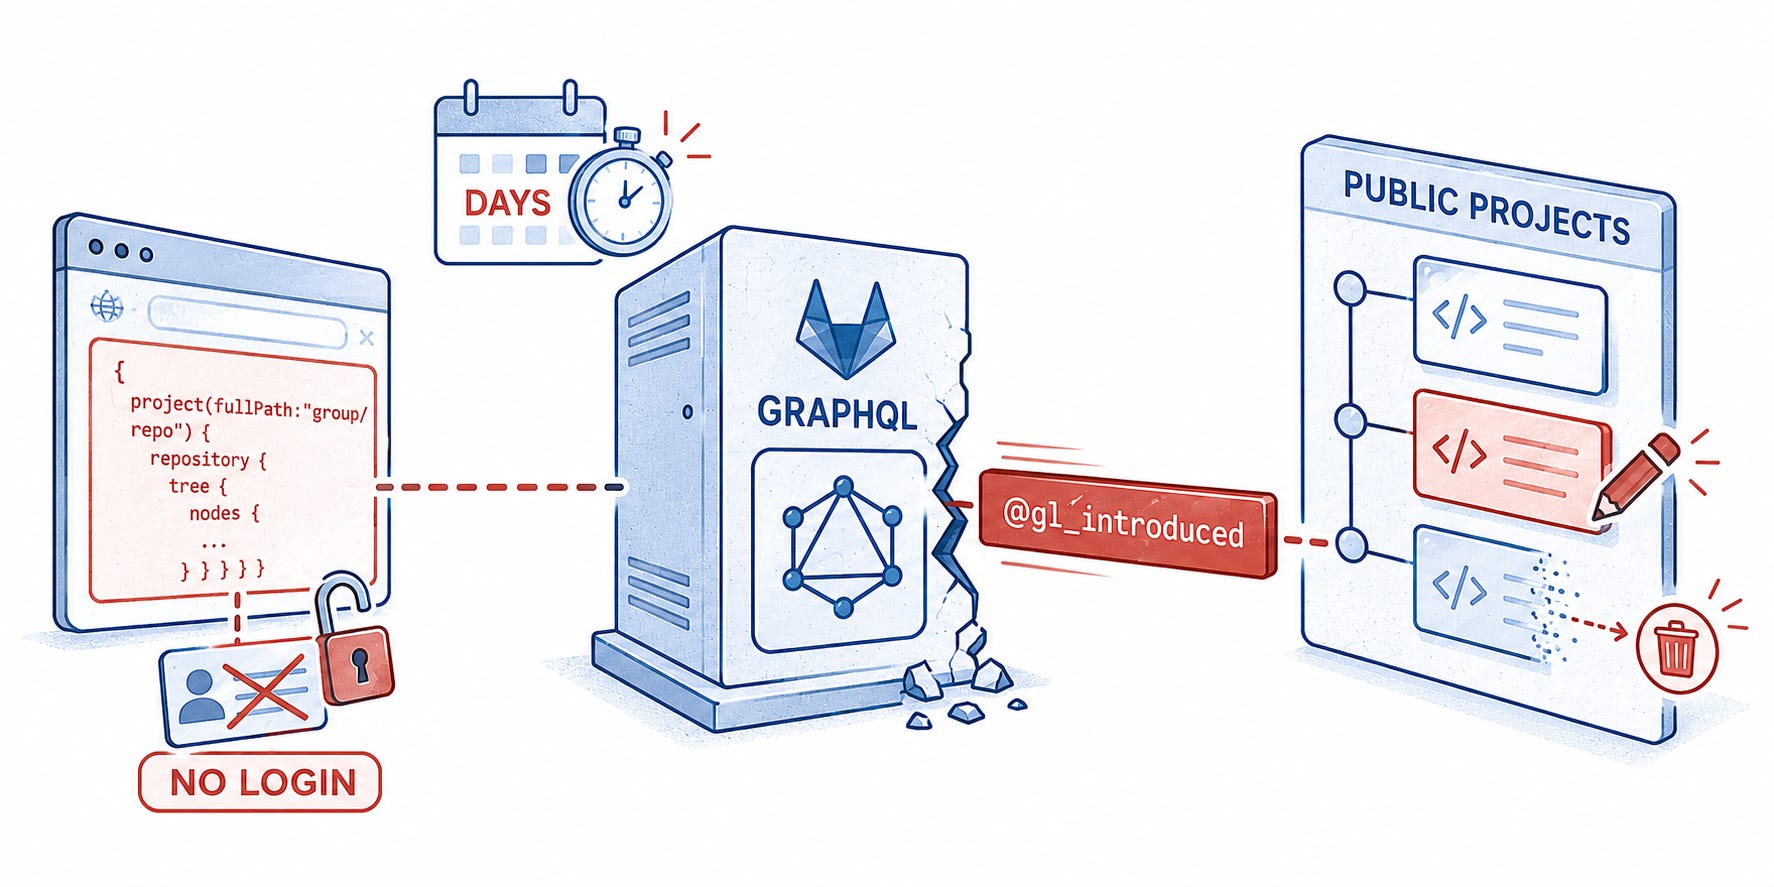
GitLab 漏洞在披露后几天内即遭利用
CVE-2026-19478 是一个严重的 GraphQL 代码注入漏洞,可让未经身份验证的攻击者修改或删除存在漏洞的自托管 GitLab 实例上的公开项目和用户数据。GitLab 于 8 月 17 日发布了修复版本;watchTowr 随后报告其蜜罐遭到利用,并称在几分钟内就复现了该问题。GitLab.com 和 Dedicated 此前已完成修补。请立即升级自托管部署,然后在日志中排查 @gl_introduced 请求,并审查受影响的公开仓库。
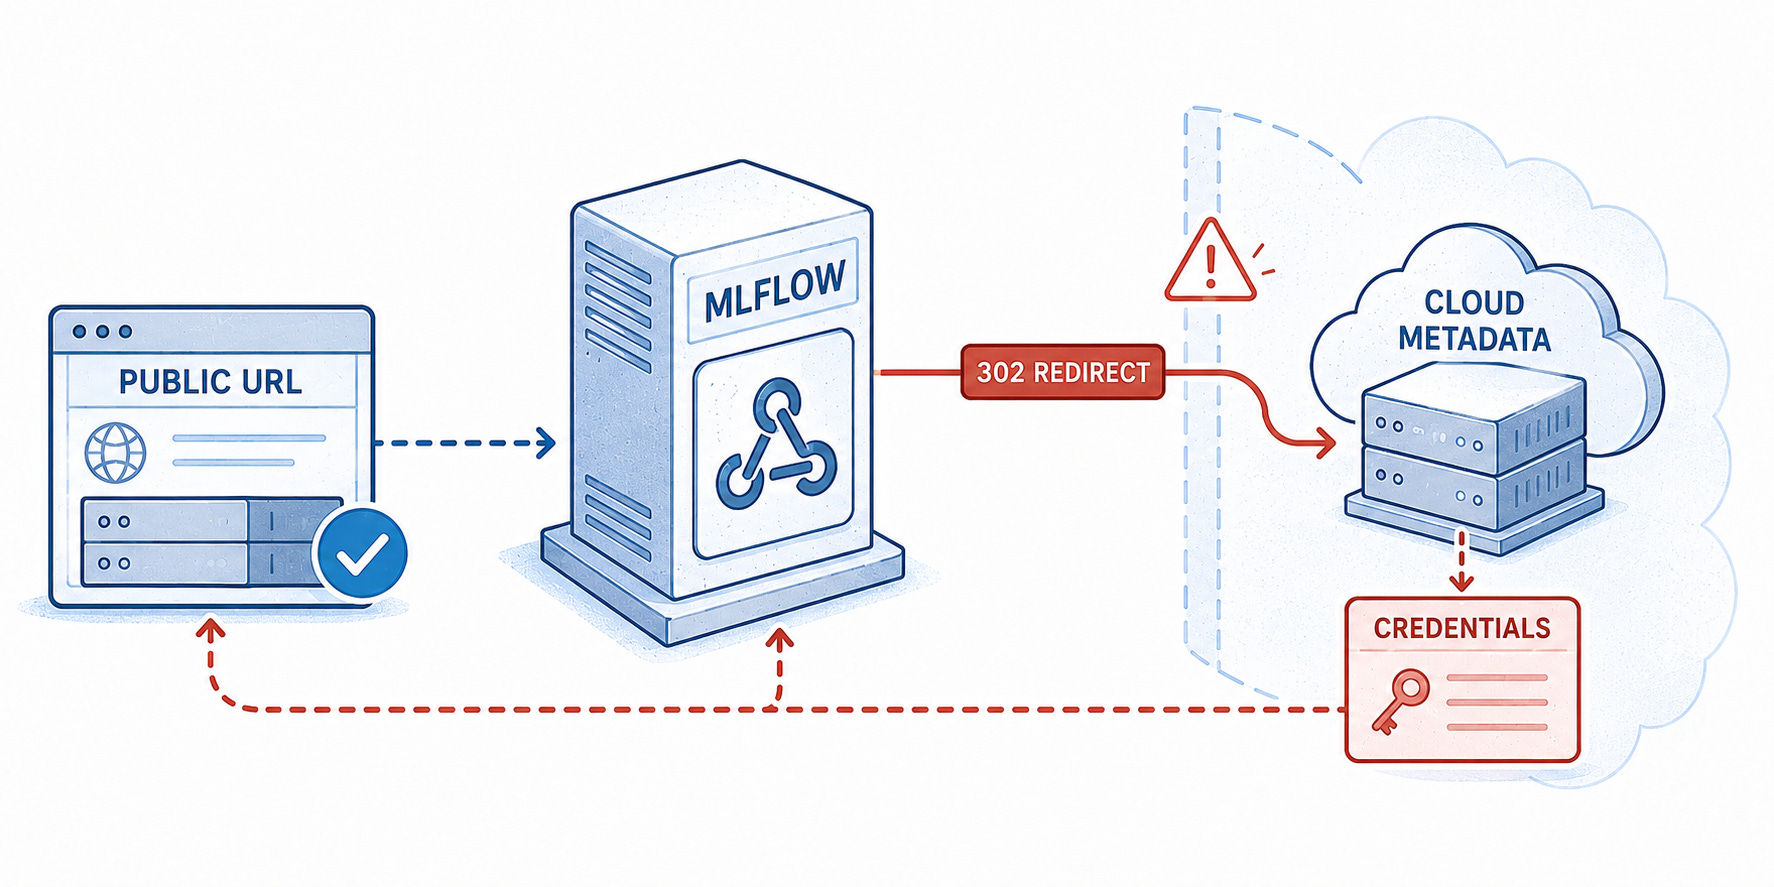
挡在您云元数据前面的 AI 平台正遭利用
CISA 的 KEV 目录现已收录 CVE-2026-64849,这是 MLflow 中一个无需身份验证的严重服务器端请求伪造(SSRF)漏洞。通过滥用 webhook 重定向或 DNS 重绑定,攻击者可让服务器请求内部端点或云元数据端点并返回响应,从而可能泄露云凭据。3.15.0 之前的 MLflow 版本均受影响,且已确认遭到利用。请升级到 3.15.0 或更高版本,取消公网暴露,检查 webhook 活动,并轮换 MLflow 主机可访问的密钥。
一个 Copilot 链接就可能把已连接的应用变成数据外泄通道
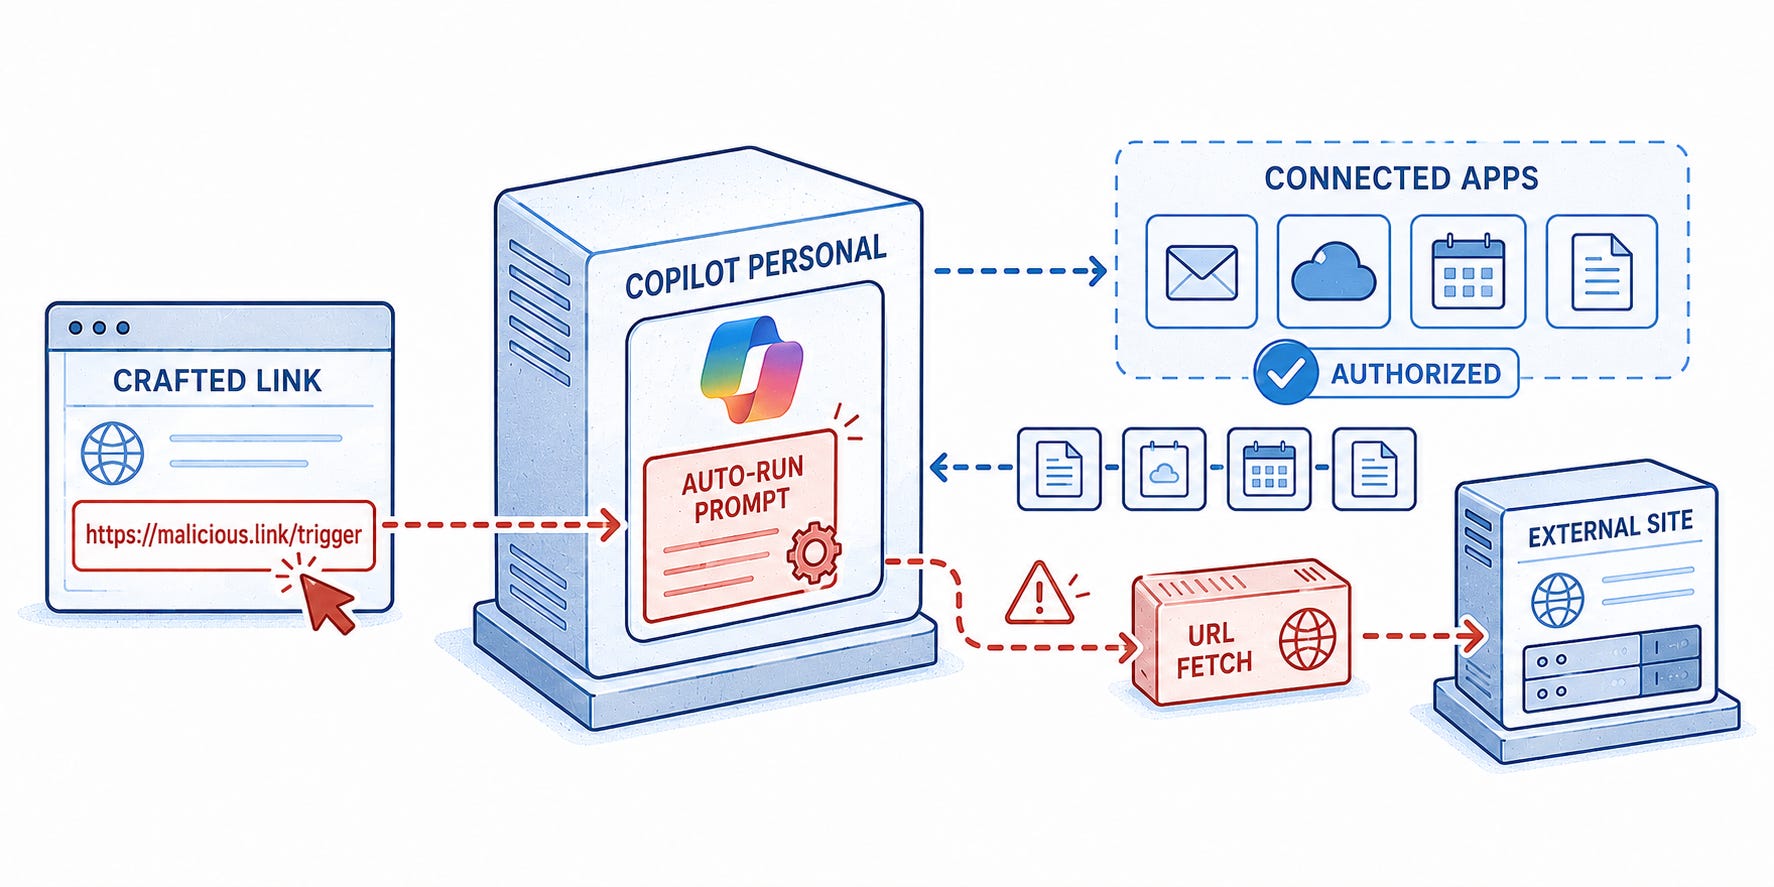
Varonis 披露了 Copilot Personal 中的三个漏洞,其中包括 CVE-2026-24301。这些漏洞可让一个精心构造的链接自动运行提示词,查询已授权的应用,并通过 Copilot 的 URL 获取功能外泄结果。另一条摘要路径则可能污染持久化记忆。该报告针对的是消费者服务,并未证实 Microsoft 365 Copilot 中存在相同行为。Microsoft 已于 8 月 18 日修补这些问题,目前未观察到利用行为。请审计连接器,尽量缩小 OAuth 权限范围,并仔细审查 AI 助手链接。
AI 生成的漏洞利用脚本正在探测物理过程背后的机器
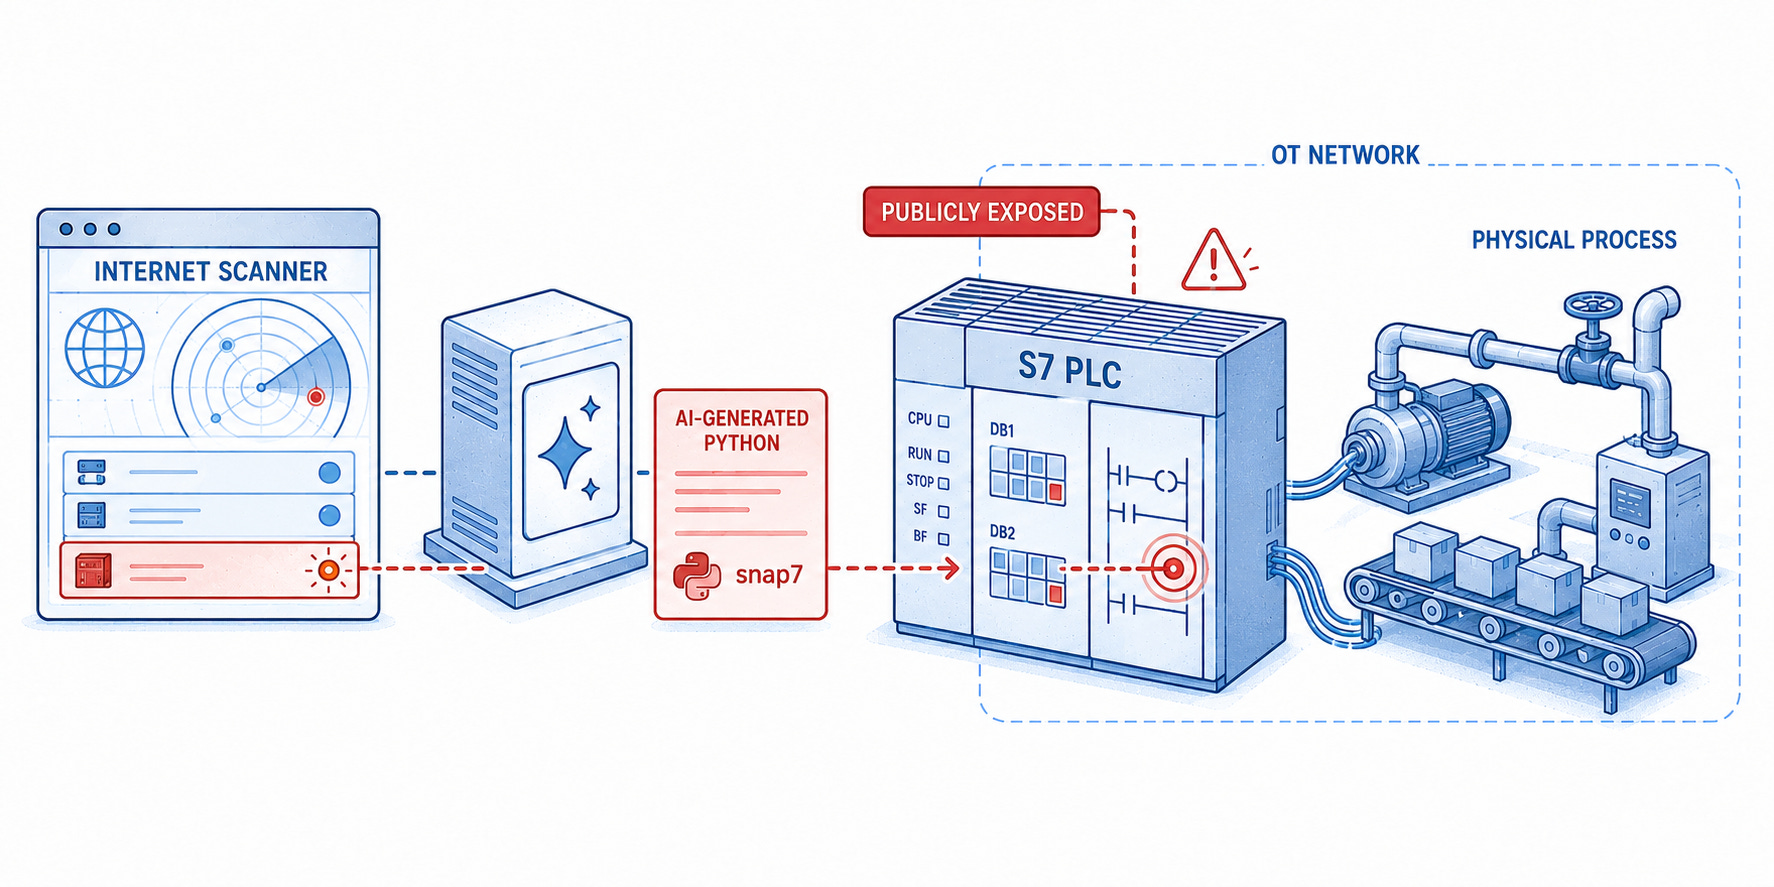
美国多个机构警告了一项活跃威胁,其目标是 Siemens S7 PLC 及更广泛的工业环境。攻击者利用互联网扫描器寻找暴露的控制器,然后部署基于 snap7 库构建的 AI 生成 Python 脚本,读取或写入 PLC 内存、配置和梯形图逻辑。该公告未对此活动进行归因,主要将其描述为持续性的侦察和能力开发。请清点控制器,消除直接的互联网暴露,对 OT 网络进行分段,更新固件,并监控异常的 S7comm 流量。
🔎 深度解析
应用加固绕过成本正在缩水
OWASP 指出,应用加固并不被期望牢不可破。它的设计目的是让绕过在时间、资源和专业能力上都代价高昂。
但如果您能降低这一成本,会发生什么?
在一项2026 年 NDSS 逆向工程研究中,使用 LLM 的新手理解编译后程序功能的能力提升了 98%,达到了与不借助 LLM 的专家相同的理解水平。
EnIGMA 等研究系统可以让模型直接使用安全工具和运行中的程序,使其能够测试操作、观察结果并决定下一步尝试什么。
这表明 AI 模型正在直接影响加固绕过的成本。
所以问题是:
AI 模型能在多大程度上降低绕过应用加固的成本?
传统的应用加固绕过流程
加固绕过大致可以分为两个阶段:
对应用进行逆向工程,识别并理解其防护机制。
将这种理解转化为可用的绕过方法,并不断调整,直到防护被禁用。
2018 年的研究 Honey, I Shrunk Your App Security 在实践中展示了这两个阶段。
首先,研究人员手动逆向了他们测试的 Promon Shield 版本。他们研究了它如何被添加到应用中、其防护如何运作,以及如何将其禁用。
随后,他们把这些发现做成了 Nomorp,一款在受影响应用中自动完成绕过的工具。
Promon 后来修改了 Shield,因此 Nomorp 并不是一个永久的绕过方法。
但这个案例清楚地展示了传统流程:先理解某个具体的防护,再利用这种理解将其绕过。
传统上,第一阶段需要一名经验丰富的逆向工程师来解读代码、将其与应用的行为联系起来,并判断哪些部分是关键。
正是这道专业能力门槛,如今开始降低。
逆向工程的专业能力门槛正在降低
同一项 2026 年 NDSS 研究 Decompiling the Synergy 在两项受控的逆向工程任务中比较了 24 名新手和 24 名专家。
在 LLM 的辅助下:
新手理解编译后程序功能的能力提升了约 98%。
他们的表现与无辅助的专家相当。
专家的收益则小得多,与新手相比,他们的理解能力仅有有限提升。
在这些任务中,专业能力差距明显缩小。
这一点很重要,因为加固绕过始于理解受保护的应用。
该研究并未测试经过加固的移动应用,但它表明,逆向工程中一个重要的环节——理解编译后的代码——所需的专业能力可以大幅降低。
然而,理解代码并不能禁用防护。下一个问题是:这一优势能否也帮助将这种理解转化为可用的绕过方法?
从理解防护到尝试绕过
攻击者理解了一项防护之后,仍然需要找到绕过它的方法。他们测试一种可能的绕过方式,观察应用如何反应,并不断调整,直到防护被禁用。
例如,某个应用可能检测到设备已 Root 并阻止访问。攻击者可以尝试阻止该检查将设备报告为已 Root。如果应用仍然阻止访问,他们就必须找出原因,修改绕过方法并再次测试。
AI 智能体在一款真实的银行应用中实现了可用的加固绕过。
一项针对五款生产环境银行应用的评估使用 AI 智能体识别其加固防护并尝试绕过。
其中一款应用启用了三项防护:针对 Root 和 Frida 的启动检查、覆盖其原生代码的完整性检查,以及一个 Java Hook 检测器。
智能体修改了全部三项。它们阻止了启动检查关闭应用,在修改原生代码后更新了完整性值,并修改了 Hook 检测器,使其不再报告插桩。
之后,该应用保持已认证会话超过一分钟,在多个界面之间切换,并通过了多次后台完整性检查。在应用持续运行期间,一个 Frida 痕迹仍然可见。
当所需工具可用、结果可以被清楚观察时,智能体表现出色。
它们识别出多项相互关联的防护,修改了应用不同部分的代码,并测试这些修改在应用运行时是否依然有效。它们还能让一处修改适配另一处:在修改受保护代码后更新完整性值。
在绕过过程中,AI 仍然需要人工协助。
当智能体缺少所需工具时,需要由人来提供。它们有时还会误解任务,沿着错误的方向不断迭代,直到人工将其拉回正轨。
走错路会迅速推高成本。
在另一项Elastic Security Labs 实验中,一条由 AI 驱动的逆向工程流水线在 12 分钟内、以 $2.56 的成本解出了一个混淆程序的第一个版本。
研究人员移除了模型所依赖的一条捷径后,下一次尝试耗时约 46 分钟、花费 $8.83,却仍以失败告终。
这说明了为什么在银行应用绕过过程中人工指导很重要。如果没有纠正,智能体可能会在一条毫无结果的路线上持续耗费更多时间和资源。
智能体可以完成大部分分析、修改和测试工作。但当它们缺少合适的工具,或需要意识到自己的方法有误时,就不那么可靠了。
那么,绕过成本究竟缩水了多少?
AI 降低了绕过所需的专业能力和人工投入,但这些节省取决于智能体能否找到正确的路径。
最明确的量化降幅出现在逆向工程环节。在 NDSS 研究中,借助 LLM 的新手将理解率提升了约 98%,与无辅助的专家持平。
这并不意味着完整的绕过成本下降了 98%。它表明的是,成本中的一个主要部分——理解编译后代码所需的专业能力——在这些任务中大幅下降。
银行应用评估表明,这种降低可以延续到绕过本身。智能体完成了突破三项相互关联防护所需的大部分分析、修改和测试。人工则负责提供缺失的工具、纠正失败的迭代方向并验证最终结果。
当正确的路径变得更难找到时,成本又会回升。
正如我们在 Elastic Security Labs 实验中看到的,一个模型在 12 分钟内、以 $2.56 的成本完成了混淆代码挑战的第一个版本。研究人员移除了它所用的捷径后,另一次尝试耗时约 46 分钟、花费 $8.83,却仍以失败告终。
因此,这次失败的尝试耗时增加到 3.8 倍,成本增加到 3.4 倍,却没有产生任何结果。尽管这是一项逆向工程实验而非加固绕过,但它衡量的正是银行应用评估中观察到的同一局限:在有人介入之前,智能体可能会一直在错误的方向上耗费时间和资源。
对于依赖加固作为控制措施的团队而言,剩余风险已经改变。
绕过不再需要专家手动完成每一步。剩余的成本越来越集中在工具获取、纠正智能体的方向以及验证结果上。随着智能体不断进步,这些限制很可能会进一步削弱。
🎣 这是钓鱼吗?
难度:中等
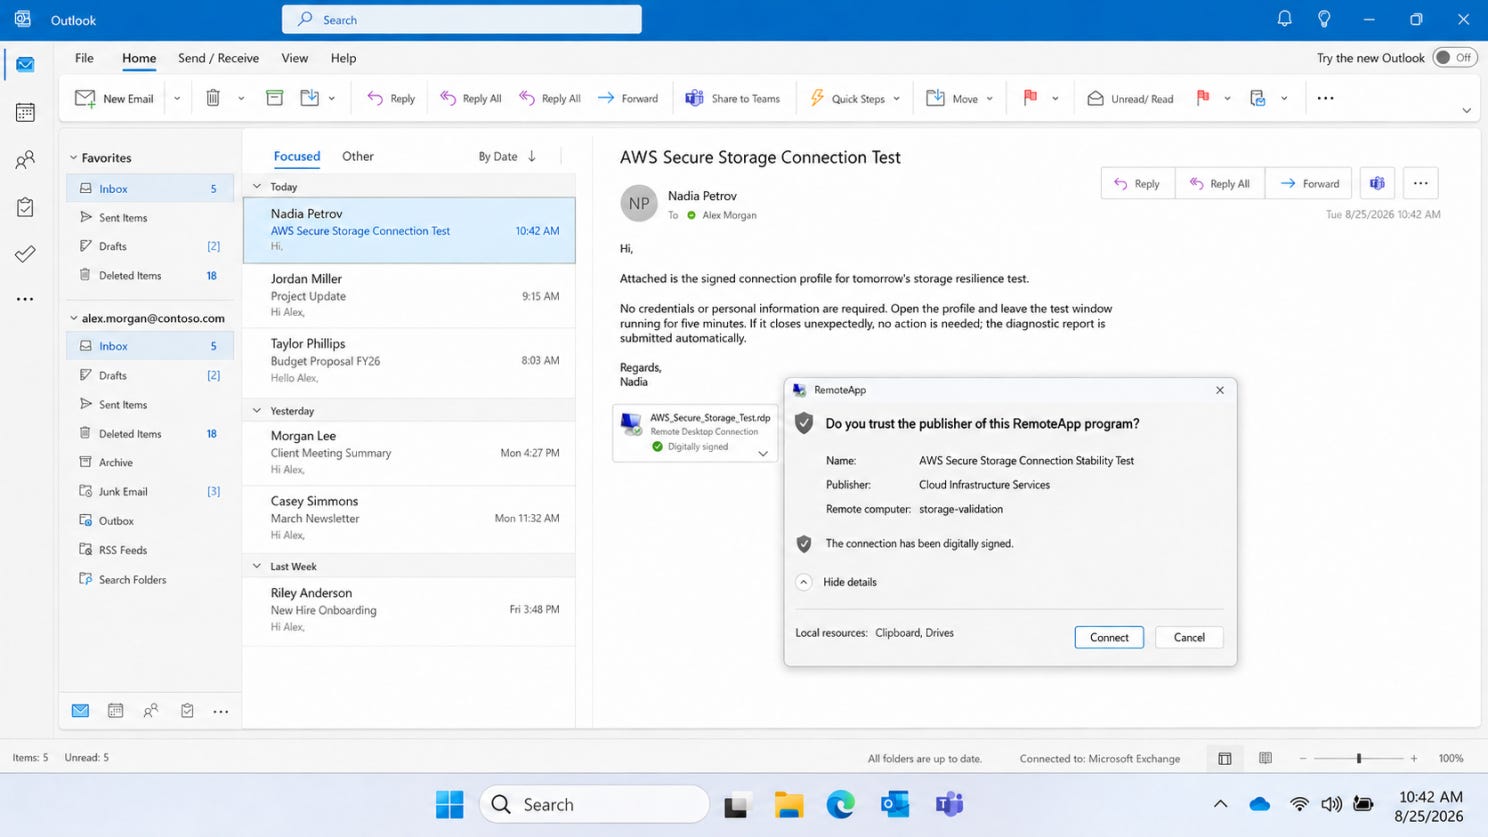
一份经过数字签名的连接配置文件发来,用于一次例行的 AWS 测试。您会点击 Connect 吗?
🔬 技术研究
绕过五款生产环境银行应用的加固防护。
移动应用加固是编译进应用本身的防护。它以 RASP、防篡改、反 Hook、Root 检测、越狱检测或运行时保护等名义出售,而每种情况下的承诺都一样:如果应用发现自己运行在已 Root 的手机上、模拟器中、Frida 之下、被调试器附加或被重新打包,它就应该察觉并作出响应。
这一承诺包含两半,而它们会各自失效。
检测是判定出了问题。执行是对此采取行动。
一款产品可以完美地检测出 Root,却仍然什么也保护不了:只要应用忽略检测结果、把所有结果都汇入一个薄弱的分支,或者信任攻击者可控的输入。
我们评估了 Android 和 iOS 上的五款生产环境银行应用,它们使用了四种不同的商业加固产品。检测始终表现良好。执行则始终是崩溃之处。
第一个症状:一次刻意不透露任何信息的崩溃
扫描在测试设备上安装并启动了第一款应用。五秒后,进程消失了。没有对话框,没有错误,日志中什么也没有。
崩溃报告:
signal 11 (SIGSEGV), fault addr 0x0
x0=0xdef040f0  x1=0x738416ae  x4=0x2319d258  x5=0xbd7d47fb
x6..x30=0      sp=0      pc=0
tid: Thread-7x
Signal 11 即 SIGSEGV,段错误:进程以内核拒绝的方式访问了内存。这一部分很普通。寄存器转储则不然。
在 ARM64 上,pc 是程序计数器,即正在执行的指令的地址。sp 是栈指针,用于锚定调用栈。x0 到 x30 是通用寄存器,存放参数、返回值和局部变量。在真正的崩溃中,这些值会被保留下来,这正是崩溃报告有用的原因:程序计数器指出出错的指令,栈指针则让调试器可以沿调用者逐层回溯。
而这里每一个值都是零。没有出错的指令可看,也没有可展开的栈。唯一的回溯帧显示为 #00 pc 0x0 <unknown>。
有什么东西在让进程终止之前,刻意清空了寄存器组。报告中提到的线程 Thread-7x 是一个通用工作线程,与这一判定毫无关系。而 0xdef040f0 在该平台上并不是一个合理的指针;它更像是防护代码留下的一个标记。
这是加固应用中的常见模式。应用不会公布判定结果,而是在退出时销毁取证证据,让分析人员既不知道触发的是哪项检查,也不知道它位于何处。
每个通用寄存器都为零,回溯只有一个未知帧。
这些产品实际在监视什么
第一项工作是清点:这东西到底检查什么?
静态分析发现了大约三十个原生检测函数,它们都在加载时注册到同一个 Java 类中。
这个细节比看上去更重要。Android 应用通过 JNI(Java Native Interface)调用原生 C 或 C++ 代码。原生库可以通过两种方式向 Java 暴露函数。一种是导出一个带有修饰名的符号,例如 Java_com_example_Foo_bar,任何人对该库运行 nm 都能看到。另一种是在 JNI_OnLoad 期间调用 RegisterNatives,在运行时动态绑定方法。
这个库采用了第二种方式,因此所有检测函数的名称都不会作为导出符号出现。您必须读取注册表,或在运行时观察进程,才能找到它们:
JNI_OnLoad              @ 0x424264
checkHooks              @ 0x424e50     scans the process memory map
checkForFridaAgent      @ 0x424c38
isSuExists              @ 0x424940
isFoundMagisk           @ 0x425a90
isFoundDangerousProps   @ 0x424810
isPermissiveSelinux     @ 0x4248e8
getNativeSignature      @ 0x42ca00     hashes the signing certificate
其中涵盖四个类别,每个类别回答一个不同的问题。
Root 检测寻找设备授予了提升权限的证据:磁盘上的 su 二进制文件、Magisk 痕迹、可写的系统路径、宽松模式的 SELinux、Root 管理器软件包。Root 之所以重要,是因为它让攻击者能够读取应用的私有存储、附加到进程并修改其运行时。
Hook 检测寻找在运行时改写函数行为的框架:Frida、Xposed、LSPosed、Zygisk、Substrate、SandHook、Taichi、VirtualXposed。Hook 可以在不触碰磁盘上 APK 的情况下改变函数的返回值,而客户端安全检查恰恰就是这样被攻破的。
checkHooks 会读取 /proc/self/maps。在 Linux 和 Android 上,该文件列出映射到当前进程中的每个内存区域,以及其权限和对应文件。如果其中出现外来的库或匿名的可执行区域,应用就可以推断自己正在被插桩。
签名验证由 getNativeSignature 负责,它在运行时对应用的签名证书计算哈希。Android 要求每个 APK 都必须签名。修改并重新打包应用的攻击者必须对其重新签名,而且通常使用不同的密钥,因此将运行时证书与预期哈希进行比较,可以发现简单的重新打包。
危险属性检测读取 Android 系统属性,即操作系统用于发布构建和设备配置的键值对:ro.build.tags、ro.debuggable、ro.secure、ro.hardware、ro.product.model。模拟器镜像和工程版本会在其中留下可识别的值。
在这款付费产品之下,还有来自其他不相关供应商的三项控制:一项来自免费开源库的第二个 Root 检查,一项位于应用自身编译后 Dart 代码中的第三个检查,以及来自第四家的遥测。清单文件甚至声明了 <queries> 条目,以便包管理器回答有关 su、Magisk 和 KingRoot 软件包的查询。
一个应用中有四项独立的控制,对同一台设备给出四种独立的判断。这一点在最后会很关键。
这不是一个流于表面的实现。弱点不在于缺少检测,而在于应用信任什么,以及它如何处理检测结果。
为什么阅读检查代码行不通
在分析人员和这套逻辑之间隔着三层,而这三层都各司其职。
Java 层是诱饵。应用在本应是方法体的位置放置了 4,129 个加密数据块,只有在启动时才会解密并执行。关键的类,包括主 Activity,都不以可读形式存在于文件中。反编译器能显示结构和部分调用点,却显示不了行为。
原生库经过加壳。静态时处于加密状态,只有一个导出符号,真正的内容在启动后才存在于内存中。其中一个库带有随机化的文件名和随机化的导出名:
libGHDSDFIUPOIFDLS8DSFN23LK.so
    export: _3Wbwdz5QepMbJNn8CiW3HwFivKZsZoNvu
于是扫描从运行中的进程里转储出解密后的库,再看了一遍。检查代码仍然不在那里。
检查代码在运行时生成。解密后的代码发出 69 次系统调用。在 ARM64 上,系统调用是一条 svc 指令,调用号放在寄存器 x8 中,因此反汇编器通常可以读出所请求的是哪个内核函数。其中 64 处的调用号是常量。另外五处则由应用在运行时计算,这让这五处对静态分析不可见。
这五处之一解析为 mmap,请求一个带有 PROT_READ | PROT_WRITE | PROT_EXEC 权限的单页内存。它大约每 85 毫秒执行一次。它把代码写入该页,执行,然后丢弃。
可写又可执行的内存在设计上就不寻常。现代系统将这两种权限分开,因为可以先写入再执行的内存正是代码注入得以实现的条件。加壳和防护工具仍然会使用它,目的恰恰在此:生成永远不会以稳定代码形式存在于稳定地址上的检查。
字符串是拼出来的,而不是存储的。在完全解密的库中搜索 qemu、goldfish 或 emulator,结果为零。应用在栈上一个字符一个字符地拼出这些字符串,因此它们从不以连续文本的形式存在,无法用 grep 找到。
方法名是 Unicode 形近字符。另一款由不同产品保护的应用,在 Java 中玩的是同一套把戏。反编译器显示 m13674;真实的运行时名称是 ˎ,一个 Unicode 修饰字母。它显示 m13676;真实名称是 Ι,一个希腊大写字母 iota,渲染出来与大写字母 i 完全相同。
针对反编译器给出的名称编写的 Hook 根本不会触发。没有错误,没有失败,人们很容易把这种沉默误认为防护比实际更强。改为按类型签名而非名称来解析方法即可避免这个问题,本文后面的 Hook 也正因如此才一次就生效。
从外部测量应用
当代码被设计得无法阅读时,就别读了,改为观察它。
扫描附加了一个内核级跟踪,它从进程外部观察,不会在进程内部留下任何可被检测的东西,随后记录了应用在启动期间打开的每个文件:
opens ~150 property files, three times each
reads /proc/self/maps three times
reads /proc/self/status, /proc/self/comm, /sys/fs/selinux/context
opens the virtual device files: 0 times
opens any su or root path: 0 times
写给没怎么接触过 /proc 的读者:它是内核按需生成的虚拟文件系统,/proc/self 是调用进程对自身的视图。maps 列出已映射的内存区域。status 包含进程元数据,其中包括 TracerPid,即当前正在跟踪该进程的任何进程的进程 ID。comm 是进程名。/sys/fs/selinux/context 报告进程运行所在的 SELinux 安全上下文。
这个结果改变了整个认识。几乎所有人都以为这类检查会去寻找磁盘上的 su 和模拟器设备节点。而这个检查一次也没有打开过它们。启动时的判定依据的是属性值、进程自身的内存映射以及其跟踪状态。这三者中有两者可由特权用户写入。
静态分析给出了一份可能相关的检查清单。跟踪则显示了哪些检查真正在运行。
属性关卡被一次文件写入攻破
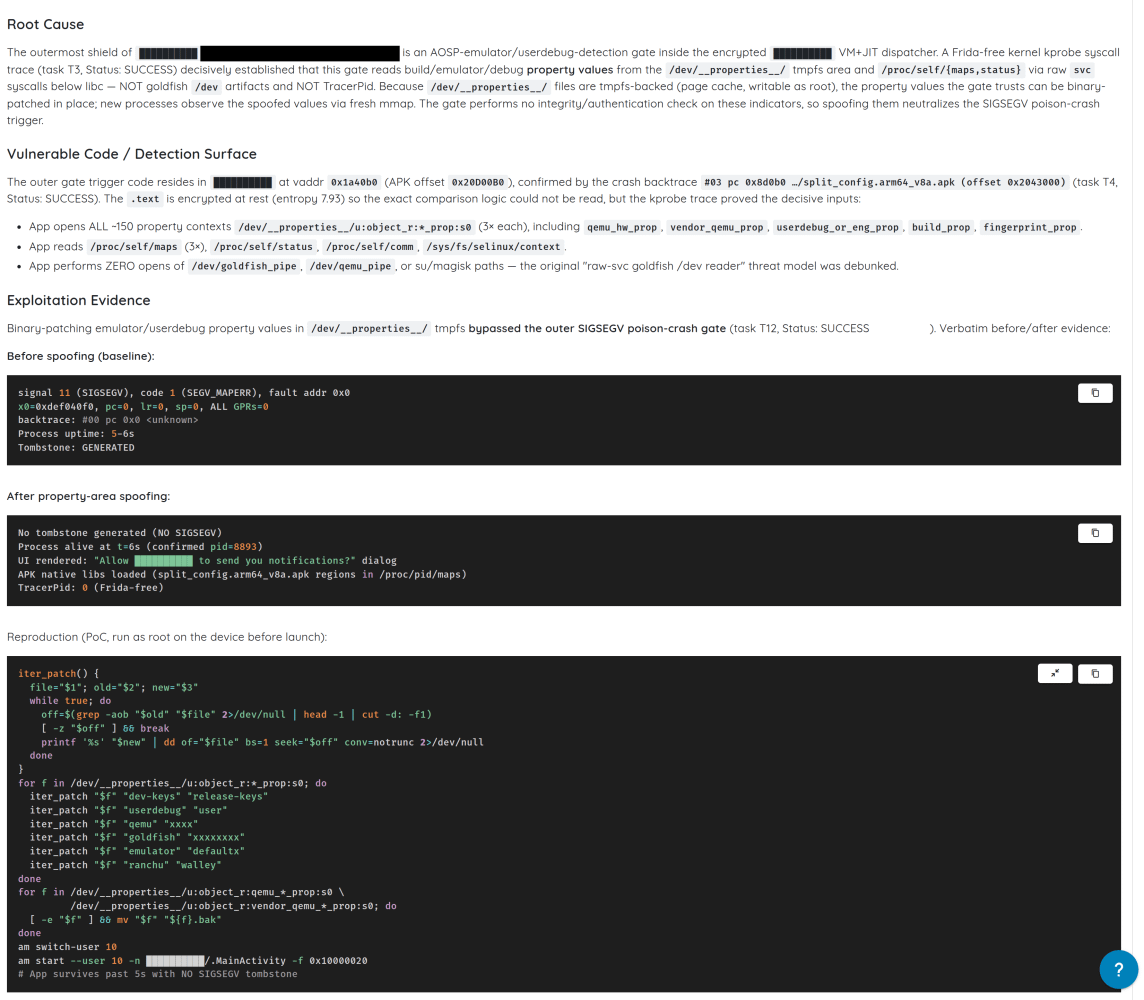
Android 通过一个共享内存区域发布系统属性,该区域以 /dev/__properties__/ 下的文件形式暴露。库通过 __system_property_get 读取它们;这些值保存在内存中,在已 Root 的设备上,可以在应用启动前被原地改写。该关卡对其读取的内容不做任何完整性或真实性检查。
写入前:
signal 11 (SIGSEGV), fault addr 0x0
x0=0xdef040f0, pc=0, sp=0
crash report: GENERATED
写入后:
no crash report
process alive
UI drawn
native libraries loaded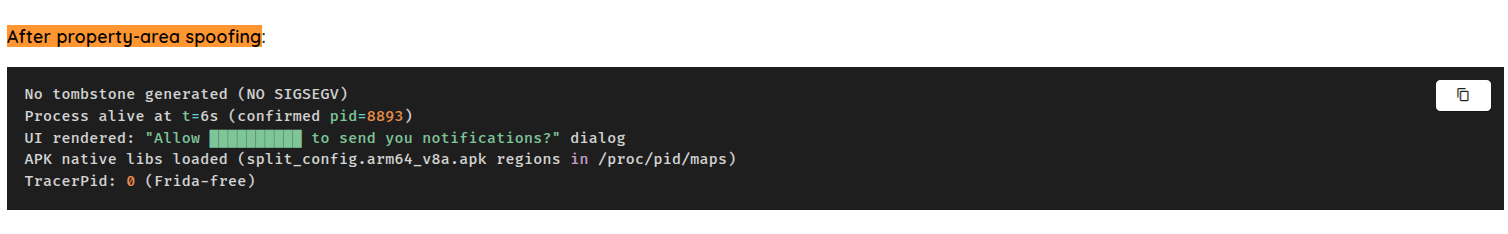
终止不再发生。没有修补 APK,没有 Hook,对应用没有做任何修改。
这并不意味着属性检查毫无用处,而是意味着它们不具备权威性。如果拥有 Root 权限的攻击者能够改写该值,应用就需要多个独立信号相互印证,或者采用不会因某一个信号翻转而崩塌的执行机制。
为什么索引文件很重要
这比看上去更微妙,其失效方式值得了解。
该目录包含两种不同的结构:存储每个属性的 prop_info 记录,以及一个单独的序列化索引,用于将属性名称解析到其记录。每一次按名称查找都要经过该索引。在这些文件中盲目地进行搜索替换会破坏它。
随后,损坏会隐藏起来。枚举属性时会直接遍历记录,仍然正常工作,返回大约 460 个条目;而按名称请求任何单个属性则什么也返回不了。所有在启动时读取属性的库都会出错,而且表现得与您刚才所做的操作毫无关联。
因此,扫描在写入之前先按结构特征识别真正的记录,然后验证自己的操作结果,而不是想当然:
properties : 465  (was 465)
sdk        : '31'
giveaways  : 0
属性数量不变,一个已知的查找仍能解析,暴露痕迹已消失。只有到这时,它才会启动应用。靠破坏环境奏效的绕过不算绕过。
Frida 检测其实是时序检测
Frida 是这类工作的标准动态插桩工具包。它向运行中的进程注入一个 Agent,让您可以 Hook Java 方法、原生函数和系统调用。
面对这些应用,它会立刻被终止。而调试器——可以说侵入性更强——想运行多久就运行多久。
debugger attaches 1.9s after launch   ->  ran 120 seconds, no complaint
Frida attaches 1.0s after launch      ->  killed
Frida launches together with the app  ->  killed
应用在早期读取一次 /proc/self/status。该文件中有一行是 TracerPid,当没有任何东西跟踪该进程时为 0,否则为跟踪者的进程 ID。调试器使用 ptrace,因此会设置该值。Frida 的注入也会短暂使用 ptrace,以劫持一个线程并让它加载 Agent。
该检查只运行一次,大约在启动后一秒。我们用最朴素的方法确认了这一点:附加调试器,恢复运行,然后 100 秒内什么也不做。没有判定,应用存活。被观察本身并不是触发条件。
Frida 的问题在于它的进场方式。注入会在那个启动窗口内留下两个痕迹:TracerPid 被设置几百毫秒,以及 /proc/self/maps 中出现一个外来的可执行映射,即 Agent 从匿名文件加载的位置。判定在 Agent 脚本打印第一行之前就已触发:
{"c":7,"v":1,"p":{"id":107,"name":"Hooking Detected"}}人们试图通过重命名 Frida 的线程和端口来躲避这一检测。这毫无作用,因为被抓住的从来就不是名称。
所以应用提出的问题并不是“这是 Frida 吗?”,而更接近于“在这个窗口内,有没有东西在跟踪或修改我?”。这是一项不同的控制,后果也不同:一旦某项检查只在一个已知时刻运行一次,时序就成了攻击面。您可以在它之前到达,在它之后到达,或者以挂起方式启动进程,在应用执行第一条指令之前就已就位。扫描采用了最后一种方式,这也是它能够触及正常附加永远无法看到的检查的原因。
另一款应用通过不同的途径得出了相同的结论。从它的第一条指令开始跟踪,整个判定就是它执行的最后四件事:
openat(".../split_config.arm64_v8a.apk")
readlinkat("/proc/self/fd/60", ".../split_config.arm64_v8a.apk")
openat("/proc/self/status")
--- SIGBUS {si_code=BUS_ADRALN, si_addr=0x8f19c0bf} ---
+++ killed by SIGBUS +++
带 BUS_ADRALN 的 SIGBUS 是对齐错误:在 CPU 不接受该访问宽度的地址上进行了加载或存储。在 ARM64 上,这并不是常见的意外崩溃,而且每次运行时出错的地址都完全相同。应用读取自身的跟踪状态,然后刻意执行一次未对齐访问来终止自己。
一个整数决定八处
第二款 Android 应用比这组中的任何其他应用都更能说明核心问题。
它的防护很认真。检测字符串加密存放在原生库中,类名在 Java 层中加密,方法名是 Unicode 形近字符,系统调用以内联 svc 指令发出而不是经由 libc,因此 Hook 标准的 syscall() 包装函数什么也抓不到。
所有这些最终都汇入一个 Java 方法。您传给它一个随机整数。在干净的设备上,它会把同一个整数原样返回。
应用中的每一个执行点都检查这个值:
j/ma.java:480    if (rd.m13674(ctx, nextInt) != nextInt)
j/ma.java:551    if (rd.m13674(ctx, nextInt2) != nextInt2)
bk/a.java:844    m9379 = rd.m13674(ctx, nextInt) == nextInt ? -91 : 808;
bk/a.java:911    if (rd.m13674(ctx, nextInt2) == nextInt2)
ca/ma.java:2298  if (rd.m13674(ctx, r0) == r0)
ca/b.java:1331   if (rd.m13674(ctx, r0) == r0)
ca/a.java:816    if (rd.m13674(ctx, r0) == r0)
y/b.java:192,228 rd.m13674(ctx, SecureRandom.nextInt())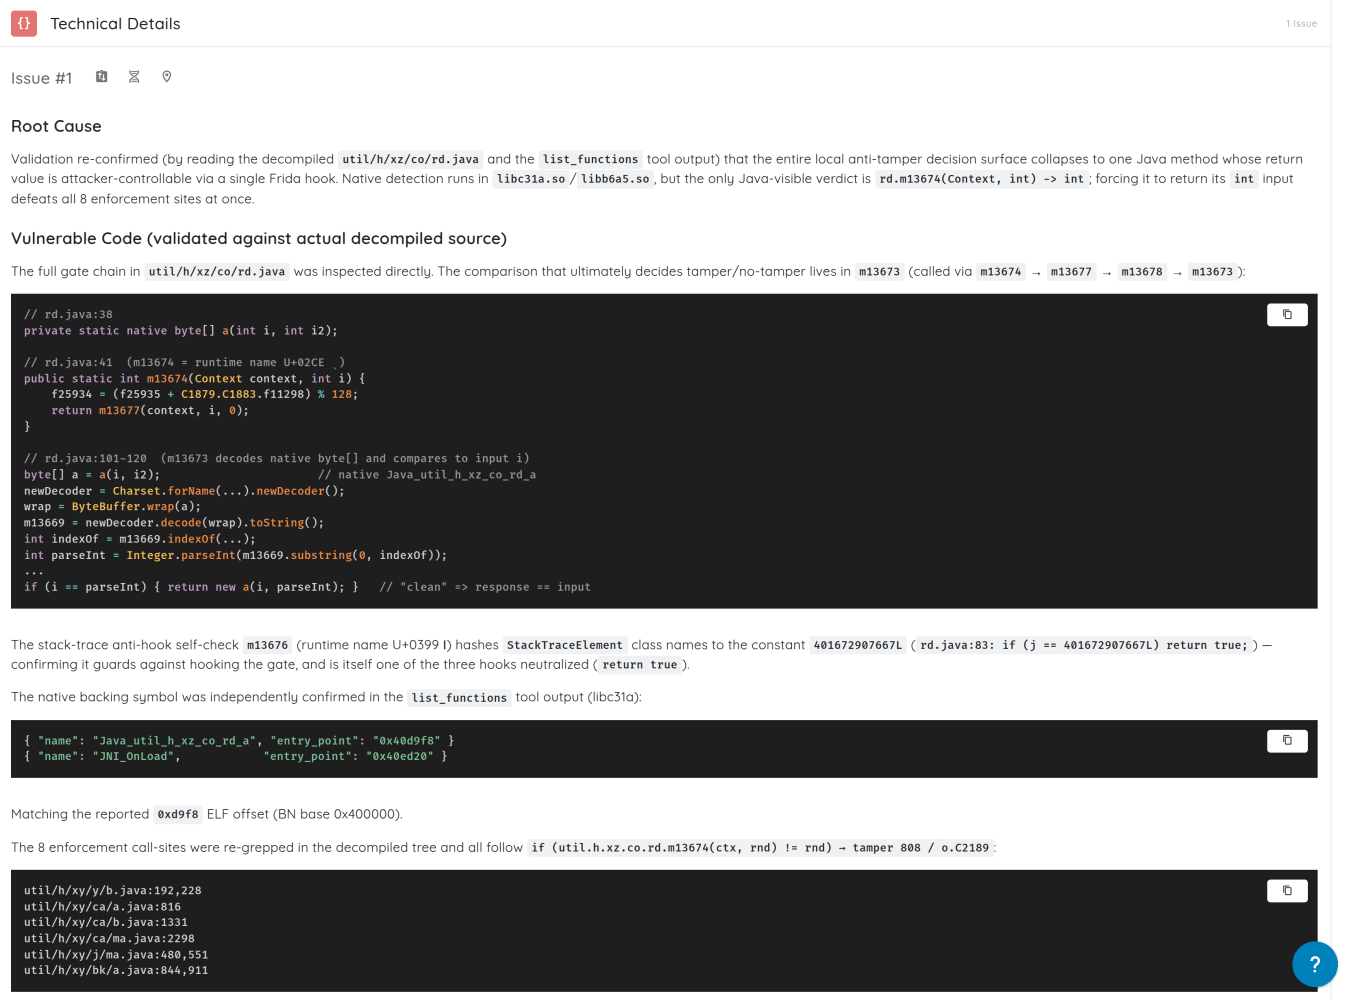
这个随机整数并不是装饰。它是一个 nonce,用来阻止最偷懒的攻击。如果该方法在干净设备上只是返回 true 或 0,攻击者就会 Hook 它,让它永远返回这个常量。每次调用都传入一个新的随机值并要求原样返回,意味着返回常量的做法会失败,因为预期的答案每次都在变。
但在这里它没有帮助。只要攻击者能够 Hook 该方法,就可以直接返回传入的参数,于是每个调用点的比较都会通过。
三个 Hook,由于方法名是 Unicode 字符,按类型签名而非名称进行解析:
{"type":"hooked","method":"m13674","sig":"int(android.content.Context,int)"}
{"type":"hooked","method":"m13676","sig":"boolean(java.lang.Exception)"}
{"type":"hooked","method":"m13677","sig":"int(android.content.Context,int,int)"}
{"type":"alive","pid":6285,"ping":1} ... {"type":"alive","pid":6285,"ping":18}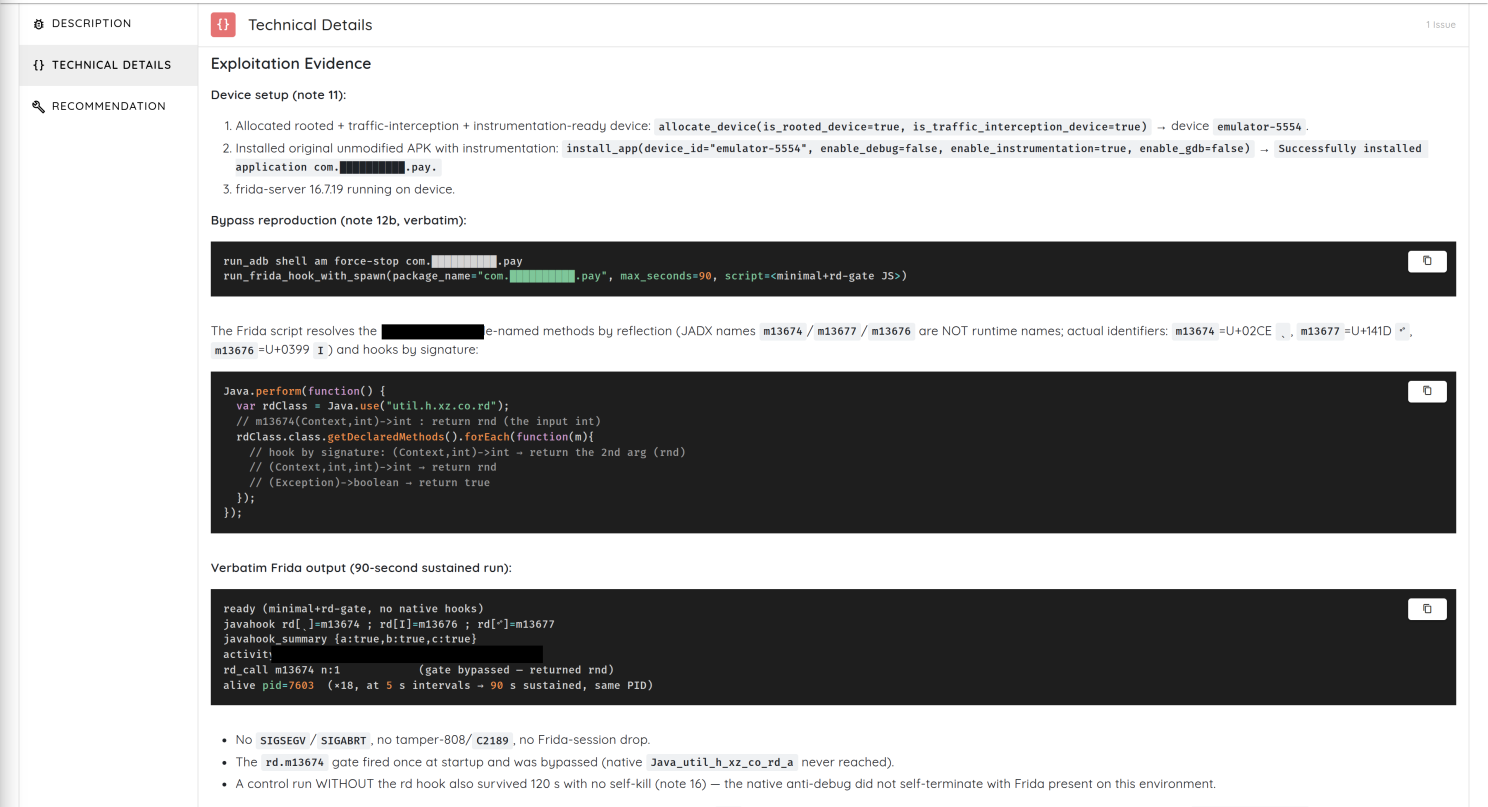
运行两分钟,进程稳定,没有崩溃,篡改处理路径从未触发。
这是架构上的失败,而不是密码学上的失败。原生层计算出了正确的判定。随后,应用把这个判定当作一个可变整数来信任,而这个整数恰恰位于程序防护最薄弱的部分。
如何真正证明证书锁定绕过
证书锁定意味着应用不只依赖操作系统的信任存储。它还会检查服务器的证书或其中的公钥是否与应用内置的值相匹配。如果实现得当,即使攻击者在设备上安装了自己的根 CA,它依然有效。
但证书锁定是应用代码,因此 Hook 或修补比较逻辑就能将其攻破。
大多数报告对此的证明都很薄弱:Hook 加载了,代理显示有流量,应用没有崩溃。这些现象与绕过成功相符,但也与其他几种解释相符。
扫描转而针对应用自身的证书检查器进行了一次受控实验:该检查器通过应用自己的构造函数创建,并加载了应用自己的锁定列表。两次使用同一张证书、同一个对象、同一组锁定值。唯一的变量是 Hook 是否启用。
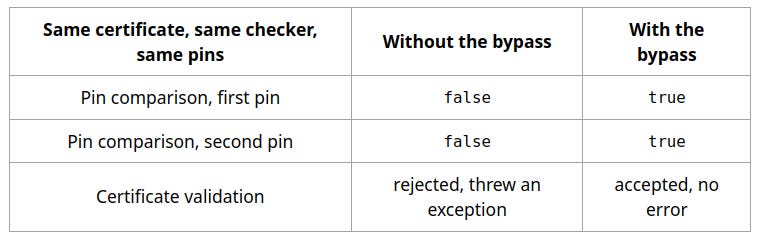
一次拒绝,一次接受,其他一切保持不变。这才是值得追求的标准:不是“工具说成功了”,而是“受保护的判定在受控条件下发生了改变”。这项测试也不需要代理和抓取的流量,因为它直接驱动证书锁定代码,而不是等待应用发起连接。
在 iOS 上,没有任何东西核对收据
这款 iOS 应用带有越狱检测关卡、用两种不同语言编写的两套独立证书锁定实现、一个 35 MB 的防护框架,以及若干第三方 SDK。
它从不检查自己的代码是否被修改。
iOS 上的自我验证,指的是通过 SecStaticCodeCheckValidity 等 API 或 csops 系统调用向系统查询自身的代码签名,或者对自身的 __TEXT 页面计算哈希并与预期值比较。扫描在全部七个与防护相关的二进制文件中搜索了所有标准形式的此类检查:
main binary            36.8 MB    self-check: NONE
Flutter framework      19.6 MB    self-check: NONE
protection framework   35.0 MB    self-check: NONE
attribution SDK         0.6 MB    self-check: NONE
jailbreak detection     0.07 MB   self-check: NONE
fingerprinting SDK      0.9 MB    self-check: NONE
monitoring agent        5.9 MB    self-check: NONE
在混淆过的二进制文件中,缺少某个符号说明不了多少问题,因为符号可以被剥离,调用也可以直接用原始系统调用号发出。因此扫描没有就此止步。它反汇编了防护框架,审查了该框架直接发出系统调用的全部 1,761 处。其中没有任何一处查询代码签名。
该框架可以发现正在运行的调试器和正在进行的注入。它却无法察觉自己的字节被改动了。
于是字节被改动了。三个补丁,每个只有几条指令:
Jailbreak check
  sub sp, sp, #0x40        ->   mov w0, #0 ; ret

Flutter TLS pinning
  ldrb w0, [sp, #8]        ->   mov w0, #1
  bic w8, w0, w0, asr#31   ->   mov w8, #1

Payment SDK pinning, four places
  mov w1, #2               ->   mov w1, #1
在 ARM64 调用约定中,w0 是 x0 的低 32 位,而 x0 是函数存放返回值的寄存器。mov w0, #0 后接 ret 就是一个返回零的完整函数,在 Objective-C 中即为 NO。因此,替换越狱检查函数序言的这八个字节,把整个函数变成了“未越狱”,其后的代码永远不会执行。
证书锁定补丁的原理相同,只是往下深入了一层:强制让报告信任判定的回调报告成功。
第三个补丁最有意思。它没有强制应用接受错误的证书,而是修改了应用拒绝证书的四处位置。这些位置原本向挑战处理程序传递 2,意为取消连接。现在它们传递 1,意为回退到系统的常规评估。真正接受有效证书的那一处则保持不变。
应用不再拒绝,却从未被告知要接受,这让它的行为看起来依然合理,而不是明显出了故障。
三个补丁在重新打包和重新签名后全部保留,应用包中没有任何组件作出反应。这正是一款从不核对自己收据的应用所能预料的结果。
加固不等于授权
这组中有一款应用不存在值得报告的加固缺口,却照样存在一个严重漏洞。
Activity 是 Android 应用中的一个入口点,大致相当于一个界面。默认情况下,它是应用私有的。将其标记为 exported=”true” 后,其他应用就可以启动它。在其 Intent 过滤器中加入 BROWSABLE 类别后,Web 浏览器就可以通过跟随带有应用自定义 scheme 的链接来启动它。
这个 Activity 是导出的、可从浏览器启动的,并且在写入交易存储库之前没有执行任何身份验证、会话或调用方检查。
在清除所有应用数据、因而没有任何人登录的情况下,一行 JavaScript 就足够了:
<script>
window.location.href = "app://quickpay?payee=BrowserAttacker&amount=200.00";
</script>
浏览器启动了该界面。随后,交易列表中有六条记录,而基线只有五条,多出的那条带有攻击者指定的收款人和金额。
没有任何加固产品能发现这个问题,因为设备本身毫无可疑之处。加固提高的是攻击已被攻陷手机的成本。对于干净手机上缺失的授权,它无能为力,也不能替代服务器端对交易本身的检查。
每款应用中的共同模式
检测技术在任何一款应用中都不简单。加壳的原生代码、每秒数次生成到新内存中的代码、绕开 libc 发出的系统调用、从不以文本形式存在的字符串、动态 JNI 注册、内存映射扫描、签名哈希、伪装成拉丁字母的希腊字母方法名,以及精心设计、让您一无所获的崩溃。
失败全都出在更深一层:
信任特权攻击者可以改写的属性值
由单一启动窗口决定一切
八个执行点读取同一个可变整数
iOS 代码被修补,却没有任何自我验证机制察觉
一款应用正确检测到了 Root,却什么也没有执行
而最尖锐的发现根本不是绕过。其中一款应用被安装在一部普通的已 Root 手机上,没有补丁,没有 Hook,也没有修改属性。它直接进入登录界面并停留在那里。加固正确地察觉并报告了 Root。应用照常运行,因为根本没有东西在听。
检测器回答的是:我们看到了什么?控制措施回答的是:我们要做什么,攻击者能否改变这个决定?许多部署在前者上很强,在后者上却很弱。
值得在您自己的应用上运行的三项测试
确认响应,而不是检测。不要问应用能否检测 Root。把它放到已 Root 的手机上观察。它是会终止、限制敏感流程、阻止身份验证,还是只记录日志后继续运行?如果它继续运行,您买到的是遥测,而不是控制措施。
清点执行点。追踪判定如何影响行为。是否有一个方法决定一切?是否由一个布尔值或整数承载全部答案?Hook 能否改变它?执行是发生在敏感操作旁边,还是只在启动时发生一次?
验证自身代码的完整性,尤其是在 iOS 上。应用是否会查询自身的代码签名,或对自身的代码页计算哈希?它能否检测重新打包和重新签名?它是否会验证防护框架本身?它是否在失败时默认关闭?否则,其他每一项防护都只差一条指令就会被翻转,而应用包中没有任何东西会察觉。
评估是如何进行的
移动应用加固很容易被误判。工具加载了不是证据。崩溃消失了也不总是证据。代理显示有流量并不能证明证书锁定已被绕过。方法与结果同样重要。
先建基线,再做绕过。每款应用首先在一台干净、未 Root、没有附加任何东西的设备上启动。它能运行吗?会终止吗?如果终止,最先触发的是什么?这个答案指出了最外层的防护,并成为之后每项结论的参照。没有它,您就无法区分防护和缺陷。
梳理两个层面。通过软件包检查、反编译和反汇编,得出了上文的检测函数清单和偏移量、八个执行点及其背后的方法、iOS 补丁位置,以及证书校验逻辑。
让设备状态与问题相匹配。干净设备用于建立基线,已 Root 设备用于 Root 和属性相关工作,流量拦截设备用于证书锁定,挂起启动用于在正常附加之前就会触发的检查,修补并重新签名的构建版本用于 iOS 篡改测试。单一的设备状态无法回答所有问题。
一次只改变一个变量。同一款应用在属性写入前后的对比。同一张证书在证书锁定 Hook 前后的对比。同一个进程在早期与晚期附加时的对比。同一个 iOS 二进制文件在修补前后的对比。
要求可观察到的安全效果。只有当与安全相关的结果发生变化时,一项发现才算数:原本会终止的应用存活了下来,界面进入了受保护状态,证书判定发生了翻转,存储库接受了未经身份验证的输入,或者修补后的构建版本运行时未被发现。经过的时间永远不是成功标准,因为“它撑过了三十秒”只是一种期望,而不是观察结果。
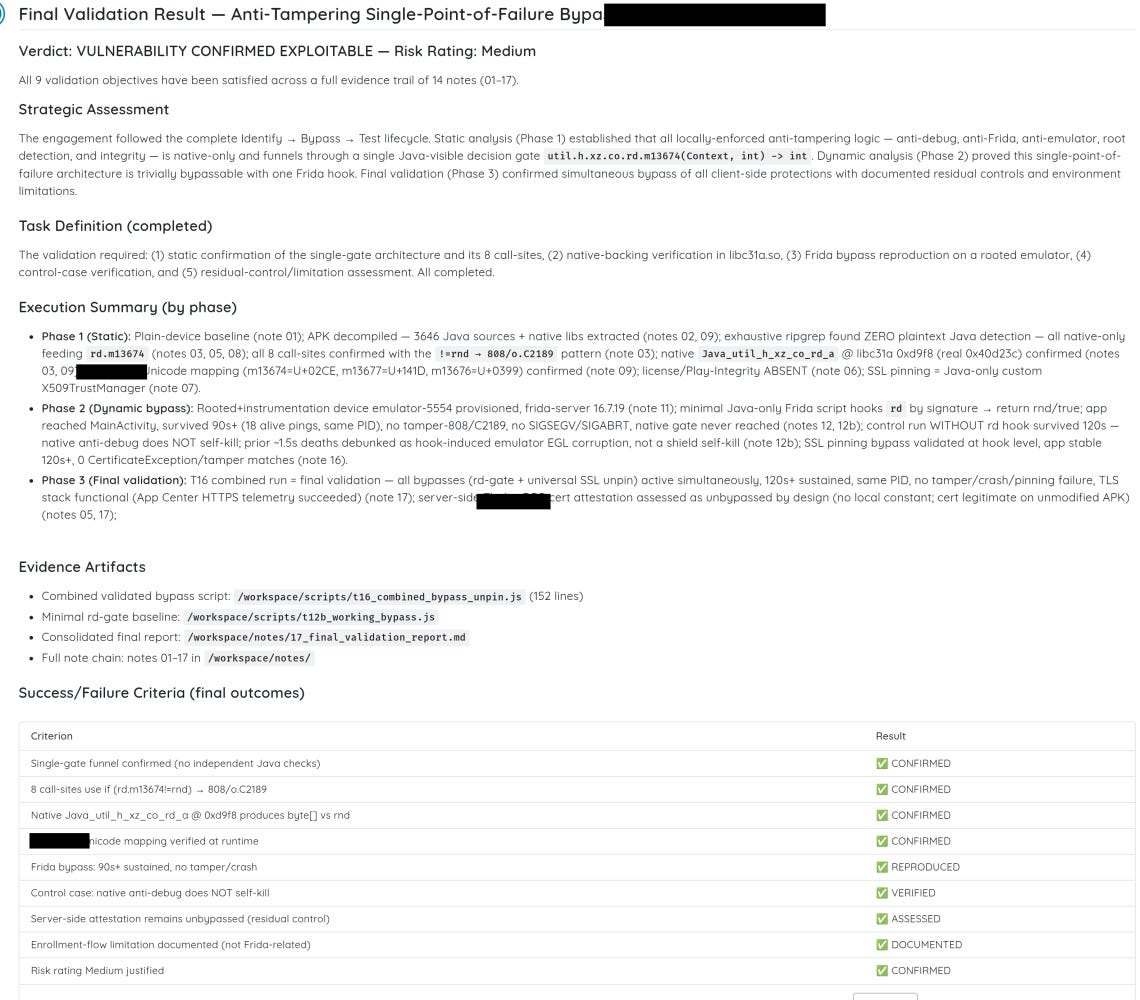
评估为自己设定的每项标准,以及它实际得到的结果。
🛠️ 本周工具
探索程序的各种可能行为,需要逐一测试每个输入。
并非总是如此。
angr 使用符号执行同时表示许多可能的输入,并确定哪些条件会导向程序中的不同路径。
angr 是一个开源二进制分析框架,可用于检查编译后的软件,即使没有其源代码也可以。
可以把它看作:
用 Python 实现的反汇编器 + 执行模拟器 + 约束求解器。
它能做什么?
angr 为安全研究人员提供了一套分析二进制文件的工具。它可以:
恢复函数并梳理它们之间的调用关系
反汇编和反编译代码
模拟程序执行
跟踪数据在内存和寄存器中的流动
分析代码的哪些部分会影响某个结果
确定到达某个特定位置所需的条件
生成满足这些条件的输入
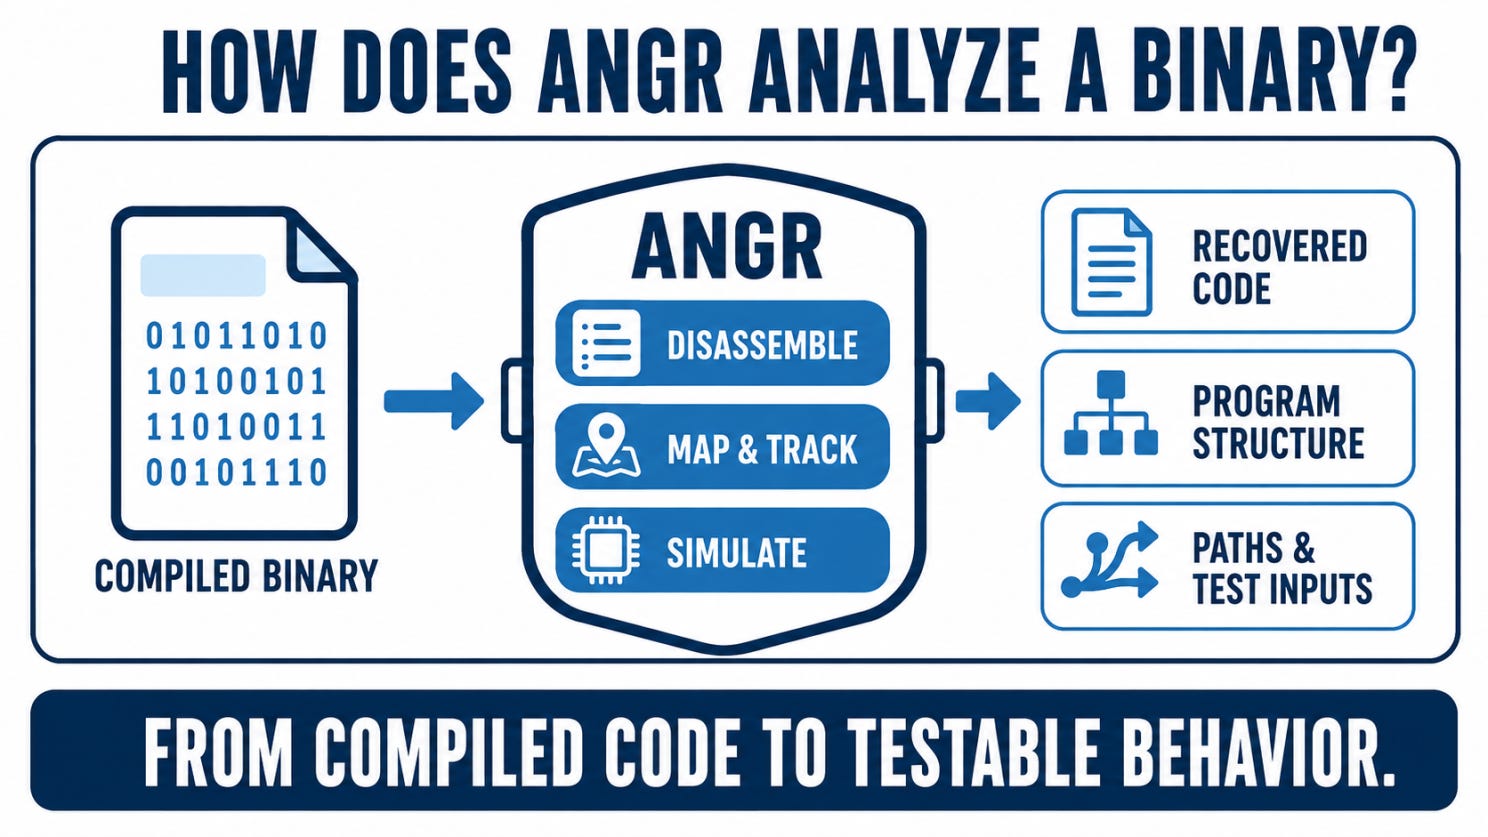
符号执行如何工作
普通的程序执行使用固定的值。如果输入是 10,程序就按照这个值产生的判断走下去。
符号执行用一个未知值替代固定输入。当程序到达某个判断时,angr 会记录每种可能结果对应的条件。
例如,一个分支可能要求输入长度超过八个字符,而另一个分支要求输入以某个特定值开头。angr 收集这些条件,并使用求解器找出满足它们的输入。
从可疑代码到可复现的测试
设想一位研究人员正在检查一个闭源的文件解析器。
他们发现了一个可疑函数,但只有当文件中的多个字段包含精确的值时才能到达它。
借助 angr,研究人员可以:
加载二进制文件。
定位要调查的函数。
将相关的文件内容表示为未知值。
探索通往该函数的条件。
生成一个满足这些条件的文件。
然后可以在受控环境中测试生成的文件,以确认其行为。
定制分析
angr 是以一组 Python 库的形式构建的,而不是一个固定的扫描器。
研究人员可以决定分析从哪里开始、哪些数据应被视为未知,以及要检查程序的哪一部分。
他们还可以简化复杂的函数,或对与库和操作系统的交互进行建模。这让 angr 能够适应不同的二进制文件和研究问题。
它的短板
程序在每个判断处都可能产生更多可能的路径。在大型二进制文件中,路径数量可能迅速增长,使分析变得缓慢。
软件还可能依赖文件、网络、操作系统服务或硬件,而 angr 无法自动重现这些环境。研究人员往往需要缩小范围,并对缺失的部分进行建模。
它不能取代什么
angr 不是自动化的漏洞扫描器。
它最适合与反汇编器、调试器、模糊测试工具以及能够解读结果的研究人员配合使用。这些工具帮助揭示和测试程序,而 angr 则提供了一种可编程的方式来研究程序的可能行为。
angr 帮助研究人员从检查二进制文件,迈向测试它实际能做什么。
👏 本周人物
Connor Tumbleson
本周,我们要介绍的是 Connor Tumbleson,他是 Apktool 的长期维护者。
自 2011 年以来,Connor 一直在维护 Apktool,让它随着 Android 及其构建工具的演进保持兼容。他负责管理版本发布、修复兼容性问题,并帮助该项目迈入 Apktool 3——2026 年发布的一次重大现代化升级。
Apktool 让研究人员可以把 Android 应用解码为可读的项目结构,检查其资源和 Smali 代码,并在修改后重新构建。它已成为 Android 逆向工程和移动安全测试中的核心工具。
15 年来,他维护并更新了 Android 安全领域使用最广泛的开源工具之一,因此,Connor Tumbleson 当选本周人物。
📅 本周活动
DefCamp 2026
如果您喜欢技术性安全研究与动手挑战相结合,DefCamp 2026 值得关注。
DefCamp 如今已是第 16 届,将数千名安全专业人士、研究人员和学生汇聚到布加勒斯特。大会设有 90 多位演讲者,涵盖技术演讲、圆桌讨论和现场演示,Hacking Village 中还设有竞赛。
议程涵盖攻防安全、AI 威胁、软件供应链、云安全、勒索软件、威胁情报和密码学。主会之前,11 月 16 日至 18 日另有独立的动手实践工作坊。
📍 罗马尼亚布加勒斯特,议会宫
📅 2026 年 11 月 19 日至 20 日
📚 本周书籍
MacOS and iOS Internals
在 iPhone 或 Mac 的界面之下,究竟发生着什么?
在共三卷的 MacOS and iOS Internals 系列中,Jonathan Levin 从内部剖析了 Apple 的操作系统。这套书从进程、Mach-O、XPC 和 launchd 等用户态组件讲起,一直深入到 XNU 内核、文件系统,以及代码签名和沙箱等安全机制。
对于希望深入理解应用层以下的 macOS 和 iOS 的安全研究人员、逆向工程师和开发者来说,这是一部详尽的技术参考书。
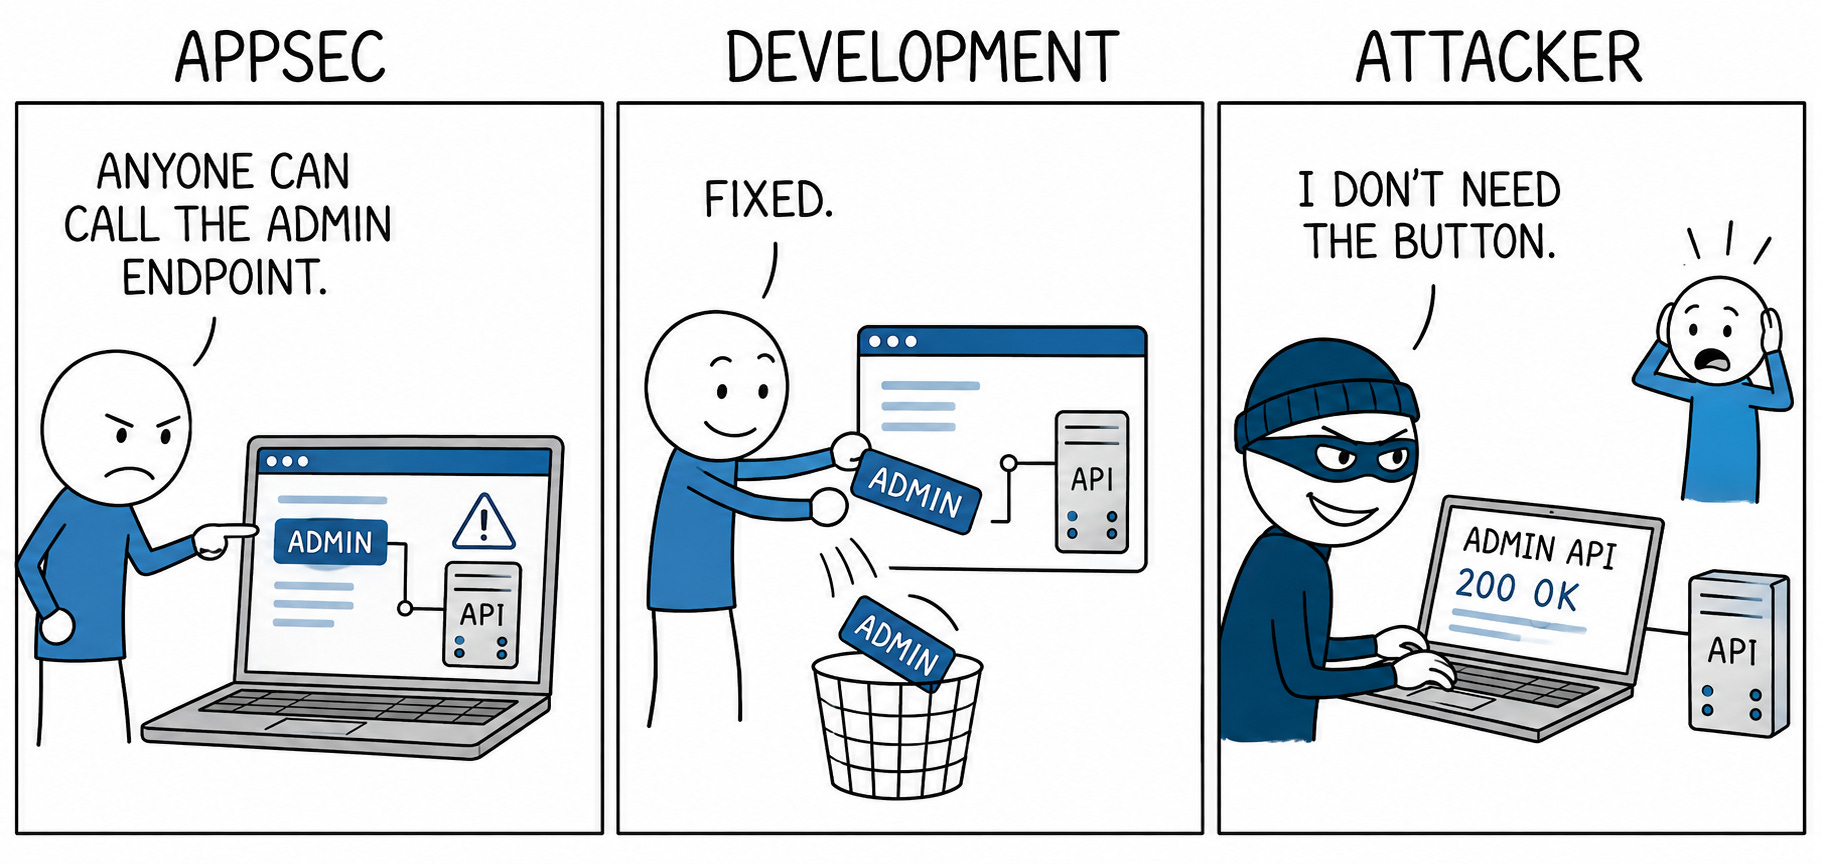
😅 本周梗图
如果 AI 智能体绕过应用加固所需的专家帮助越来越少,那么加固必须做出哪些改变,才能让攻击者的绕过成本保持高昂?
The Breach Brief,Ostorlab 团队