Le shielding applicatif n’est pas conçu pour être incassable. Il est conçu pour rendre un contournement assez difficile pour qu’il exige un attaquant expert, avec les bonnes compétences, les bons outils et le temps nécessaire.
Cette hypothèse commence à changer. Les modèles d’IA peuvent aider des attaquants moins expérimentés à comprendre du code protégé et à manier les outils nécessaires pour tenter un contournement.
Cette semaine, nous examinons dans quelle mesure l’IA peut réduire le coût du contournement du shielding applicatif.
Au sommaire également : des crates Rust empoisonnées, l’exploitation rapide d’une faille critique de GitLab, une vulnérabilité de MLflow activement exploitée, des failles dans Copilot Personal, des scripts générés par IA qui sondent des automates Siemens, angr pour l’analyse de binaires, et plus encore.
Dans ce numéro
🌡️ Niveau de menace : alerte élevée
⚡ Actualités : cinq histoires de sécurité à rattraper
🔎 Analyse approfondie : la baisse du coût du contournement du shielding applicatif
🎣 Est-ce du phishing ?
🔬 Recherche technique : contourner le shielding de cinq applications bancaires en production.
🛠️ Outil de la semaine : angr
👤 Personnalité de la semaine : Connor Tumbleson
📅 Événement de la semaine : Defcamp 2026
📚 Livre de la semaine : MacOS and iOS Internals
😅 Le mème
❓ Une question avant de partir
C’est parti.
Avant de passer aux histoires de la semaine, voici où en est le niveau de menace.
🌡️Niveau de menace
⚡ Actualités
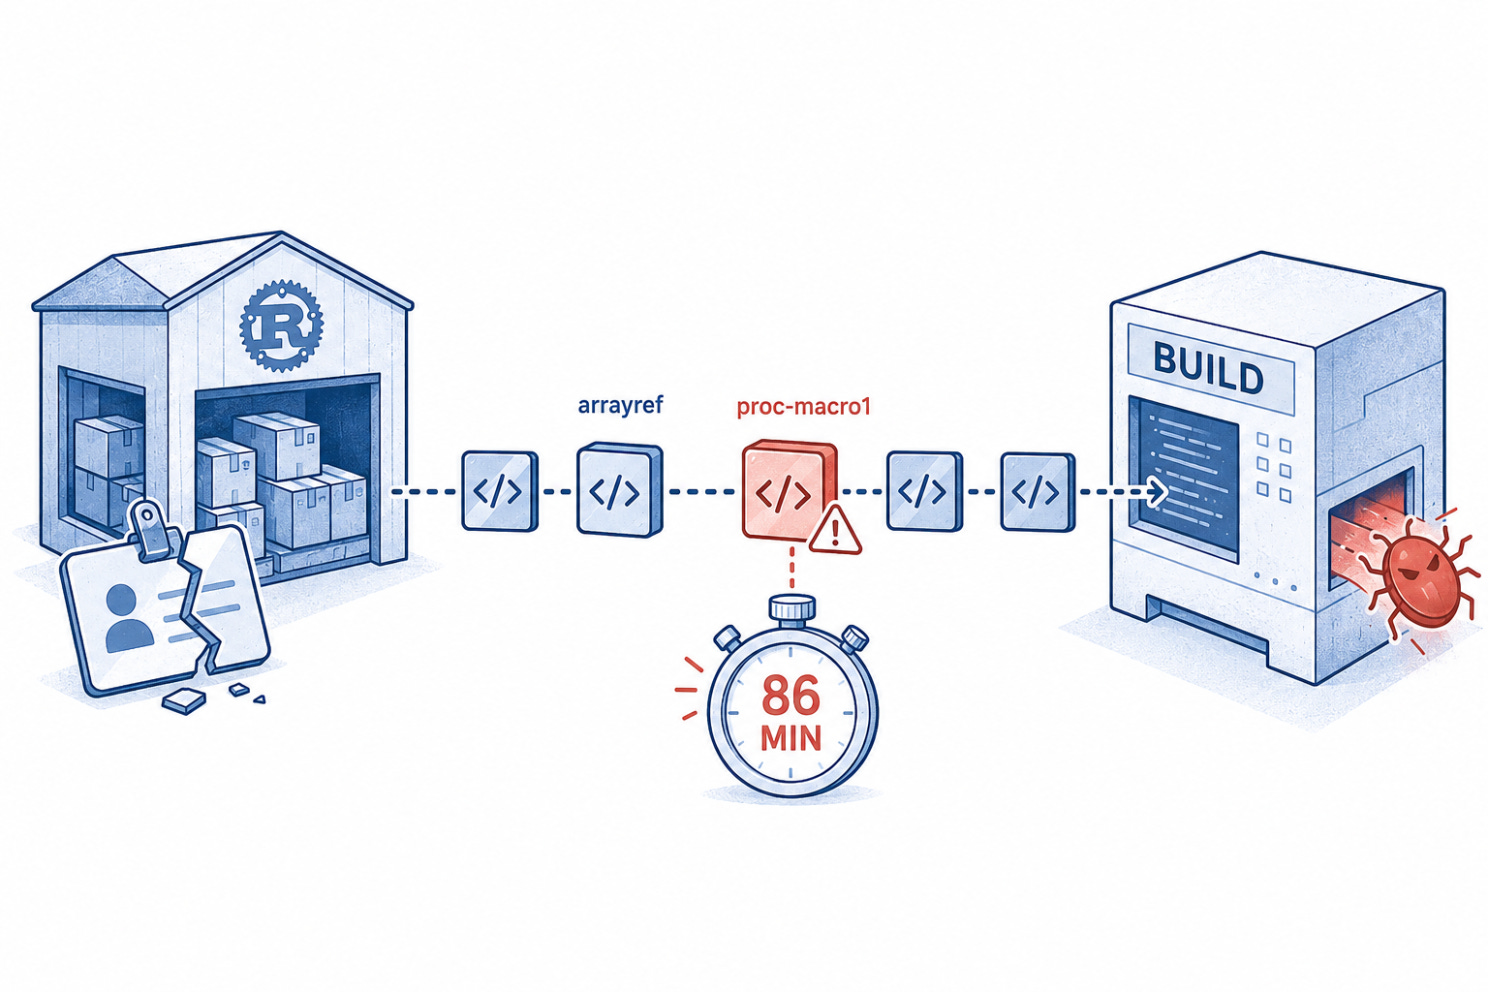
86 minutes ont suffi pour empoisonner un build Rust
L’équipe Rust a indiqué que l’ordinateur ou les identifiants d’un mainteneur avaient probablement été compromis après l’apparition sur crates.io de versions malveillantes d’arrayref, internment et append-only-vec. La version empoisonnée d’arrayref tirait proc-macro1, dont le script de build téléchargeait un malware pendant la compilation. Rust a retiré les versions au bout de 86 à 107 minutes ; RustSec a recensé 2 285 téléchargements d’arrayref 0.3.10. Inspectez les caches et les lockfiles, isolez les runners de build et renouvelez les identifiants exposés pendant les builds concernés.
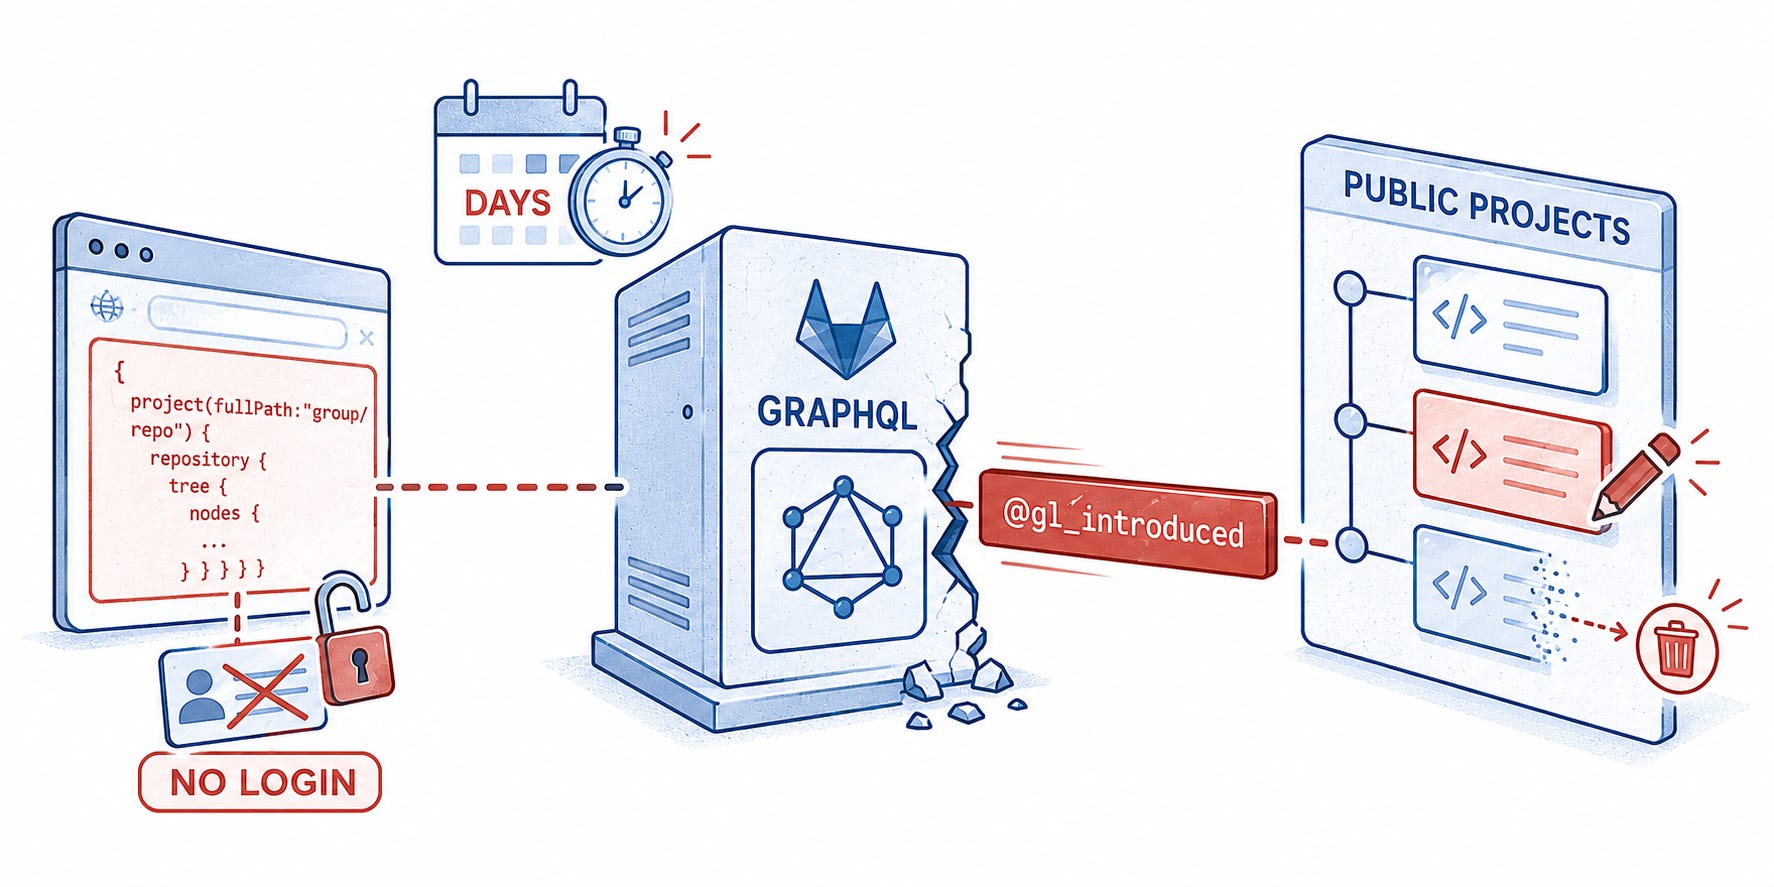
L’exploitation de GitLab est arrivée en quelques jours après la divulgation
CVE-2026-19478, une faille critique d’injection de code dans GraphQL, permet à des attaquants non authentifiés de modifier ou de supprimer des projets publics et des données d’utilisateurs sur des instances GitLab auto-hébergées vulnérables. GitLab a publié des versions corrigées le 17 août ; watchTowr a ensuite signalé une exploitation contre ses honeypots et dit avoir reproduit la faille en quelques minutes. GitLab.com et Dedicated étaient déjà corrigés. Mettez immédiatement à jour les déploiements auto-hébergés, puis cherchez dans les journaux les requêtes @gl_introduced et examinez les dépôts publics concernés.
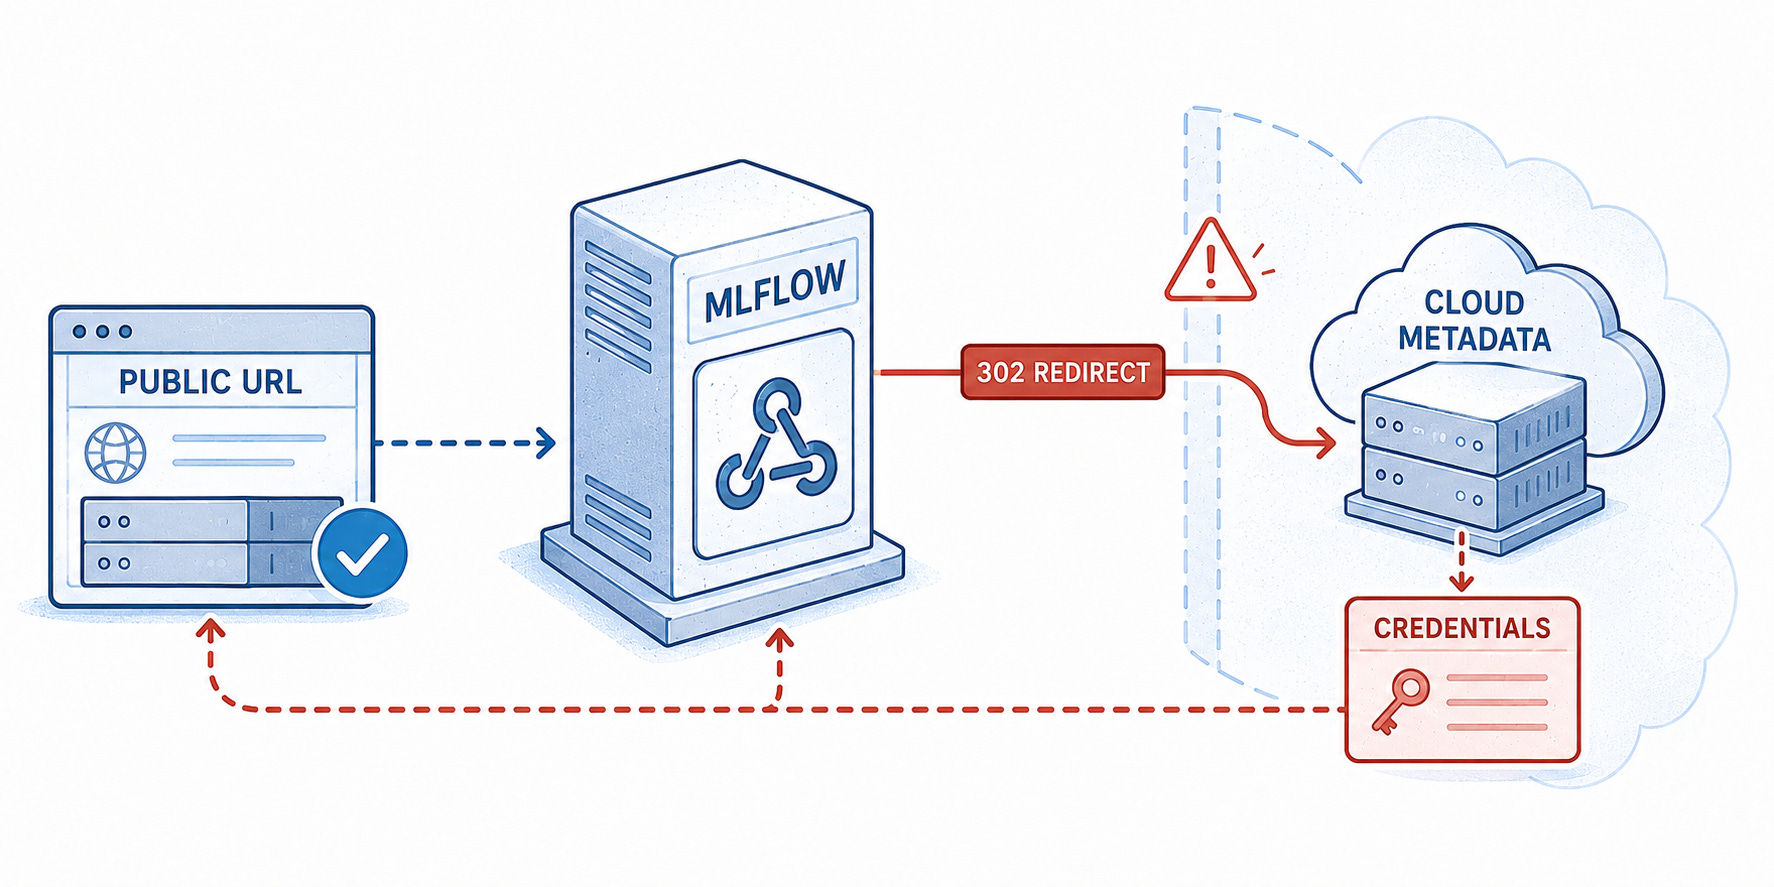
La plateforme d’IA placée devant vos métadonnées cloud est en cours d’exploitation
Le catalogue KEV de la CISA recense désormais CVE-2026-64849, une faille SSRF critique non authentifiée dans MLflow. En abusant des redirections de webhook ou du DNS rebinding, des attaquants peuvent faire interroger par le serveur des endpoints internes ou de métadonnées cloud et obtenir la réponse, ce qui peut exposer des identifiants cloud. Les versions de MLflow antérieures à 3.15.0 sont touchées, et l’exploitation est confirmée. Passez à la version 3.15.0 ou ultérieure, retirez l’exposition publique, inspectez l’activité des webhooks et renouvelez les secrets accessibles depuis l’hôte MLflow.
Un seul lien Copilot pouvait transformer des applications connectées en voie d’exfiltration
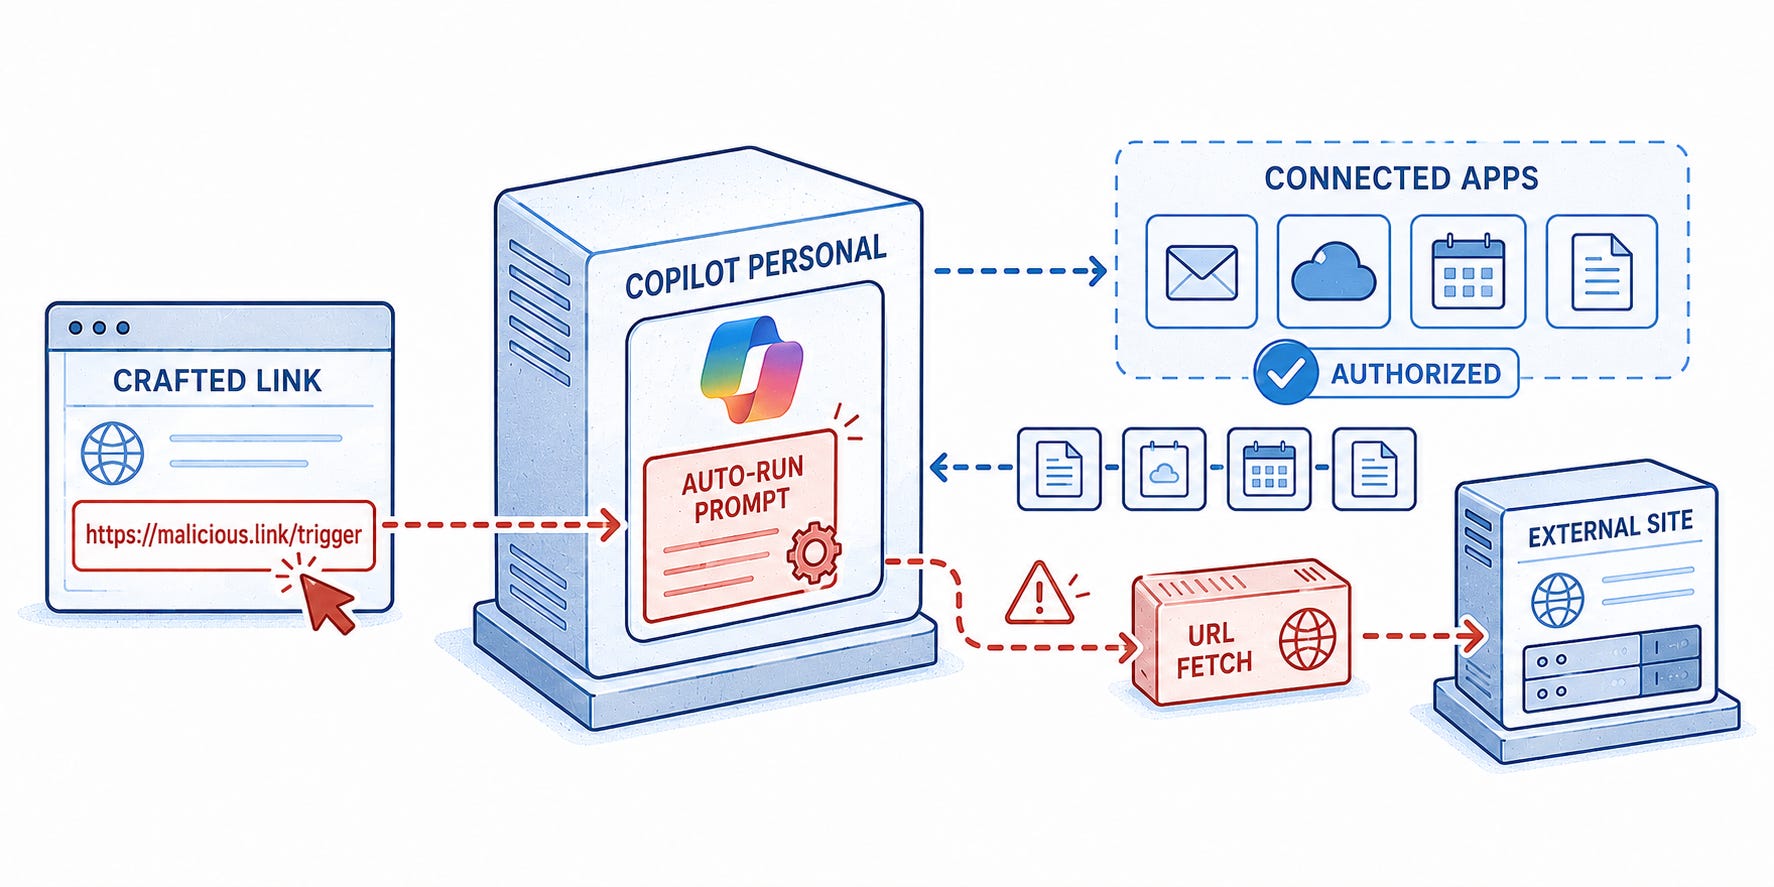
Varonis a divulgué trois failles dans Copilot Personal, dont CVE-2026-24301, qui permettaient à un seul lien piégé d’exécuter automatiquement un prompt, d’interroger des applications déjà autorisées et d’exfiltrer les résultats via la fonction de récupération d’URL de Copilot. Un autre chemin, celui du résumé, pouvait empoisonner la mémoire persistante. Le rapport portait sur le service grand public et n’a pas établi le même comportement dans Microsoft 365 Copilot. Microsoft a corrigé les failles le 18 août, sans exploitation observée. Auditez les connecteurs, réduisez au minimum le périmètre OAuth et méfiez-vous des liens d’assistants IA.
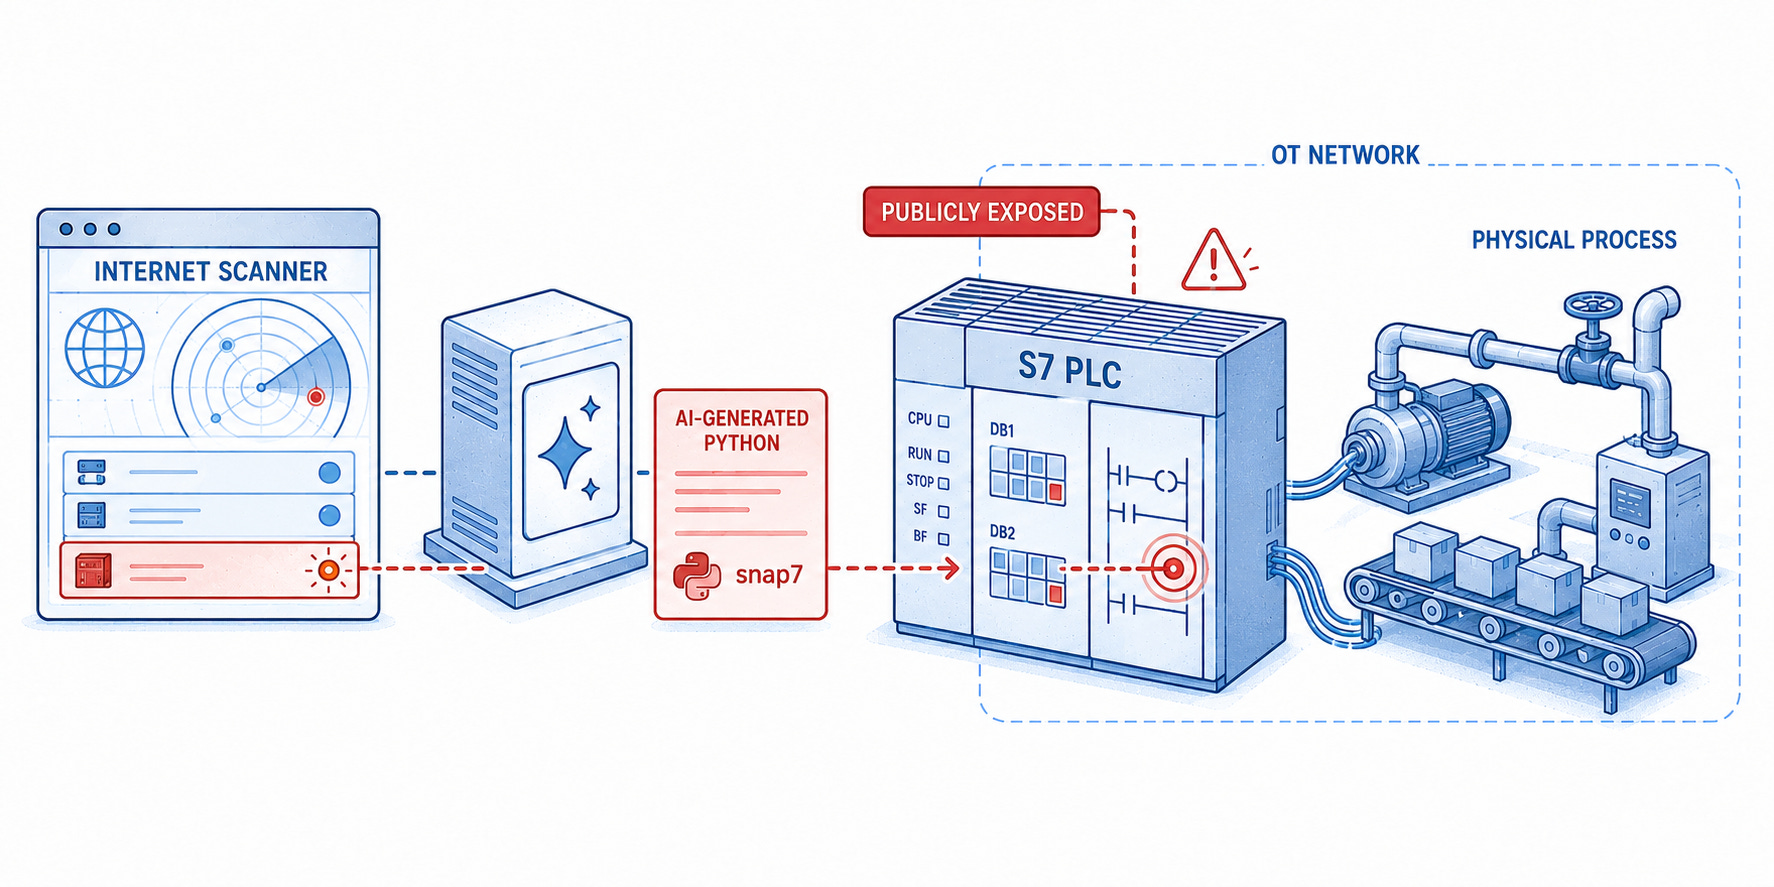
Des scripts d’exploitation générés par IA sondent les machines qui pilotent des processus physiques
Des agences américaines ont mis en garde contre une menace active visant les automates Siemens S7 et, plus largement, les environnements industriels. Des acteurs utilisent des scanners Internet pour trouver des contrôleurs exposés, puis déploient des scripts Python générés par IA, construits autour des bibliothèques snap7 pour lire ou écrire la mémoire, la configuration et la logique ladder des automates. L’avis n’a pas attribué cette activité et l’a décrite surtout comme de la reconnaissance persistante et du développement de capacités. Inventoriez les contrôleurs, supprimez l’exposition directe à Internet, segmentez les réseaux OT, corrigez les firmwares et surveillez le trafic S7comm anormal.
🔎 Analyse approfondie
La baisse du coût du contournement du shielding applicatif
L’OWASP indique que le shielding applicatif n’est pas censé être incassable. Il est conçu pour rendre le contournement coûteux en temps, en ressources et en expertise.
Mais que se passe-t-il si l’on peut réduire ce coût ?
Dans une étude NDSS 2026 sur la rétro-ingénierie, des novices aidés d’un LLM ont amélioré de 98 % leur capacité à comprendre ce que faisaient des programmes compilés, et ont atteint le même niveau de compréhension que des experts travaillant sans LLM.
Des systèmes de recherche comme EnIGMA peuvent donner aux modèles un accès direct à des outils de sécurité et à des programmes en cours d’exécution, ce qui leur permet de tester des actions, d’observer les résultats et de décider quoi essayer ensuite.
Cela montre que les modèles d’IA ont un impact direct sur le coût d’un contournement du shielding.
La question est donc la suivante :
Dans quelle mesure les modèles d’IA peuvent-ils réduire le coût du contournement du shielding applicatif ?
Le processus traditionnel de contournement du shielding applicatif
Un contournement du shielding peut se décomposer en deux grandes étapes :
Faire de la rétro-ingénierie de l’application pour identifier et comprendre ses protections.
Transformer cette compréhension en contournement fonctionnel, en adaptant l’approche jusqu’à désactiver les protections.
L’étude de 2018 Honey, I Shrunk Your App Security montre ces deux étapes en pratique.
D’abord, des chercheurs ont fait à la main la rétro-ingénierie de la version de Promon Shield qu’ils testaient. Ils ont étudié comment elle était ajoutée aux applications, comment ses protections fonctionnaient et comment les désactiver.
Ils ont ensuite transformé ces résultats en Nomorp, un outil qui automatisait le contournement sur les applications concernées.
Promon a ensuite modifié Shield, Nomorp n’était donc pas un contournement permanent.
Mais ce cas illustre clairement le processus traditionnel : comprendre d’abord une protection précise, puis utiliser cette compréhension pour la contourner.
Traditionnellement, cette première étape exigeait un rétro-ingénieur expérimenté pour interpréter le code, le relier au comportement de l’application et déterminer ce qui comptait.
C’est cette barrière de l’expertise qui commence aujourd’hui à s’abaisser.
La barrière de l’expertise s’abaisse en rétro-ingénierie
La même étude NDSS 2026, Decompiling the Synergy, a comparé 24 novices et 24 experts sur deux tâches contrôlées de rétro-ingénierie.
Avec l’aide d’un LLM :
Les novices ont amélioré d’environ 98 % leur capacité à comprendre ce que faisaient les programmes compilés.
Ils ont obtenu des résultats comparables à ceux des experts travaillant sans assistance.
Les experts ont enregistré des gains bien plus faibles, avec une amélioration limitée de leur compréhension par rapport aux novices.
Sur ces tâches, l’écart d’expertise s’est considérablement réduit.
C’est important, car un contournement du shielding commence par la compréhension de l’application protégée.
L’étude n’a pas testé d’applications mobiles protégées par shielding, mais elle montre qu’une partie importante de la rétro-ingénierie, la compréhension du code compilé, peut exiger bien moins d’expertise.
Comprendre le code ne désactive toutefois pas une protection. La question suivante est de savoir si cet avantage peut aussi aider à transformer cette compréhension en contournement fonctionnel.
De la compréhension d’une protection à la tentative de contournement
Une fois qu’un attaquant a compris une protection, il lui reste à trouver un moyen de la contourner. Il teste un contournement possible, observe la réaction de l’application et l’ajuste jusqu’à désactiver la protection.
Par exemple, une application peut détecter un appareil rooté et bloquer l’accès. L’attaquant peut essayer d’empêcher cette vérification de signaler l’appareil comme rooté. Si l’application bloque toujours l’accès, il doit comprendre pourquoi, modifier son contournement et le tester à nouveau.
Des agents IA ont produit un contournement fonctionnel du shielding dans une vraie application bancaire.
Une évaluation de cinq applications bancaires en production a utilisé des agents IA pour identifier leurs protections de shielding et tenter de les contourner.
Une application avait trois protections actives : une vérification au démarrage du root et de Frida, une vérification d’intégrité couvrant son code natif et un détecteur de hooks Java.
Les agents ont modifié les trois. Ils ont empêché la vérification au démarrage de fermer l’application, mis à jour la valeur d’intégrité après avoir modifié le code natif et changé le détecteur de hooks pour qu’il ne signale plus l’instrumentation.
Ensuite, l’application a maintenu une session authentifiée pendant plus d’une minute, navigué sur plusieurs écrans et passé des vérifications d’intégrité répétées en arrière-plan. Un artefact de Frida restait visible pendant que l’application continuait de tourner.
Les agents ont bien travaillé quand les outils nécessaires étaient disponibles et que le résultat pouvait être observé clairement.
Ils ont identifié plusieurs protections liées, modifié du code dans différentes parties de l’application et testé si ces modifications tenaient pendant l’exécution. Ils ont aussi adapté une modification à une autre en mettant à jour la valeur d’intégrité après avoir modifié le code protégé.
L’IA a quand même eu besoin d’une aide humaine pendant le contournement.
Quand les agents n’avaient pas un outil requis, une personne devait le leur fournir. Ils ont aussi parfois mal compris la tâche et continué d’itérer dans la mauvaise direction jusqu’à ce qu’un humain les redirige.
Suivre la mauvaise piste peut faire grimper vite le coût.
Dans une expérience distincte d’Elastic Security Labs, un pipeline de rétro-ingénierie piloté par IA a résolu la première version d’un programme obfusqué en moins de 12 minutes pour 2,56 $.
Après que les chercheurs ont supprimé un raccourci sur lequel le modèle s’appuyait, la tentative suivante a pris environ 46 minutes et coûté 8,83 $, mais a quand même échoué.
Cela montre pourquoi le guidage humain a compté pendant le contournement de l’application bancaire. Sans correction, un agent peut continuer à dépenser plus de temps et de ressources sur une approche qui ne produit aucun résultat.
Les agents pouvaient effectuer l’essentiel de l’analyse, de la modification et des tests. Ils étaient moins fiables quand ils n’avaient pas le bon outil ou devaient reconnaître que leur approche était mauvaise.
Alors, de combien le coût d’un contournement a-t-il baissé ?
L’IA a réduit l’expertise et l’effort manuel nécessaires à un contournement, mais ces économies dépendent de la capacité de l’agent à trouver le bon chemin.
La réduction mesurée la plus nette concerne la rétro-ingénierie. Dans l’étude NDSS, les novices assistés par LLM ont amélioré leur taux de compréhension d’environ 98 % et égalé les experts travaillant sans assistance.
Cela ne veut pas dire que le coût complet du contournement a baissé de 98 %. Cela montre qu’une part majeure du coût, l’expertise nécessaire pour comprendre du code compilé, a fortement baissé sur ces tâches.
L’évaluation de l’application bancaire a montré que cette réduction peut se poursuivre jusque dans le contournement lui-même. Les agents ont effectué l’essentiel de l’analyse, de la modification et des tests nécessaires pour vaincre trois protections liées. Les humains ont fourni les outils manquants, redirigé les itérations infructueuses et vérifié le résultat final.
Quand le bon chemin devient plus difficile à trouver, le coût remonte.
Comme nous l’avons vu dans l’expérience d’Elastic Security Labs, un modèle a terminé la première version d’un défi de code obfusqué en moins de 12 minutes pour 2,56 $. Après que les chercheurs ont supprimé le raccourci qu’il avait utilisé, une autre tentative a pris environ 46 minutes et coûté 8,83 $, mais a quand même échoué.
La tentative infructueuse a donc pris 3,8 fois plus de temps et coûté 3,4 fois plus cher sans produire de résultat. Même s’il s’agissait d’une expérience de rétro-ingénierie et non d’un contournement de shielding, elle mesure la même limite que celle observée pendant l’évaluation de l’application bancaire : un agent peut continuer à dépenser du temps et des ressources dans la mauvaise direction jusqu’à ce qu’une personne intervienne.
Pour les équipes qui comptent sur le shielding comme contrôle, le risque résiduel a changé.
Un contournement n’exige plus qu’un expert effectue chaque étape à la main. Les coûts restants se concentrent de plus en plus sur l’accès aux outils, la correction de la direction des agents et la vérification du résultat. À mesure que les agents progressent, ces limites devraient s’affaiblir.
🎣 Est-ce du phishing ?
Difficulté : moyenne
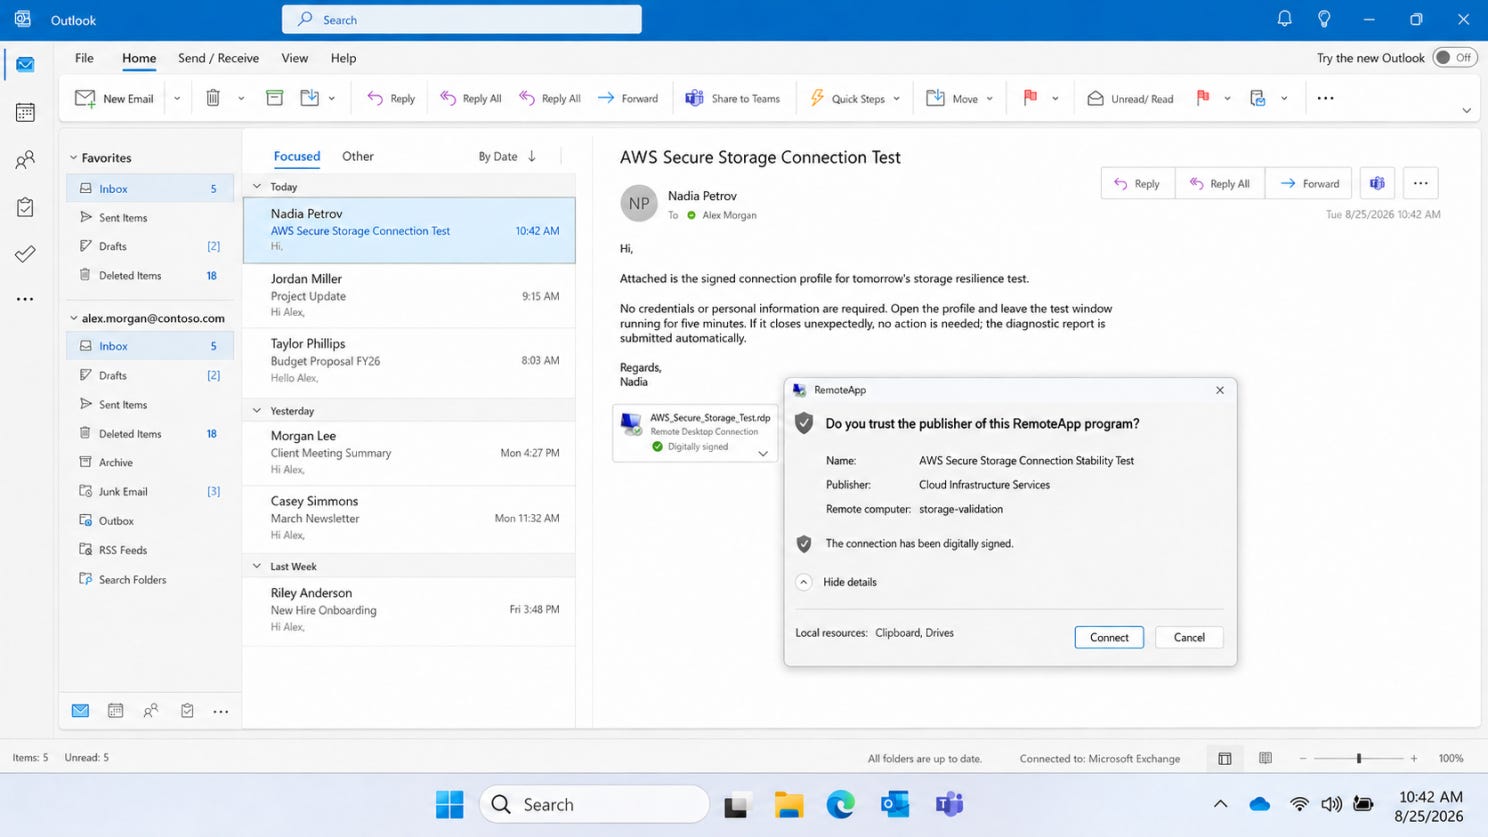
Un profil de connexion signé numériquement arrive pour un test AWS de routine. Cliqueriez-vous sur Connect ?
🔬 Recherche technique
Contourner le shielding de cinq applications bancaires en production.
Le shielding d’une application mobile est une protection compilée dans l’application elle-même. Il se vend comme du RASP, de l’anti-tamper, de l’anti-hooking, de la détection du root, de la détection du jailbreak ou de la protection à l’exécution, et la promesse est toujours la même : si l’application se retrouve sur un téléphone rooté, dans un émulateur, sous Frida, attachée à un débogueur ou repackagée, elle doit le remarquer et réagir.
Cette promesse a deux moitiés, et elles échouent indépendamment.
La détection consiste à décider que quelque chose ne va pas. L’application de la décision consiste à agir en conséquence.
Un produit peut détecter parfaitement le root et ne rien protéger, si l’application ignore la réponse, fait passer toutes les réponses par une seule branche faible ou fait confiance à une entrée que l’attaquant contrôle.
Nous avons évalué cinq applications bancaires en production sur Android et iOS, qui utilisaient quatre produits de shielding commerciaux différents. La détection était constamment bonne. C’est l’application de la décision qui cédait, à chaque fois.
Premier symptôme : un crash conçu pour ne rien vous apprendre
Le scan a installé la première application sur un appareil de test et l’a lancée. Cinq secondes plus tard, le processus avait disparu. Pas de boîte de dialogue, pas d’erreur, rien dans les journaux.
Le rapport de crash :
signal 11 (SIGSEGV), fault addr 0x0
x0=0xdef040f0  x1=0x738416ae  x4=0x2319d258  x5=0xbd7d47fb
x6..x30=0      sp=0      pc=0
tid: Thread-7x
Le signal 11 est SIGSEGV, une erreur de segmentation : le processus a accédé à la mémoire d’une manière que le noyau a refusée. Cette partie est ordinaire. Le dump des registres, lui, ne l’est pas.
Sur ARM64, pc est le compteur ordinal, l’adresse de l’instruction en cours d’exécution. sp est le pointeur de pile, qui ancre la pile d’appels. x0 à x30 sont les registres généraux, qui contiennent arguments, valeurs de retour et variables locales. Dans un vrai crash, ces valeurs subsistent, ce qui explique précisément l’utilité d’un rapport de crash : le compteur ordinal désigne l’instruction fautive, et le pointeur de pile permet à un débogueur de remonter la chaîne des appelants.
Ici, toutes sont à zéro. Il n’y a ni instruction fautive à examiner ni pile à dérouler. L’unique frame du backtrace indique #00 pc 0x0 <unknown>.
Quelque chose a délibérément effacé le fichier de registres avant de laisser mourir le processus. Le thread nommé dans le rapport, Thread-7x, est un worker générique sans rapport avec la décision. Et 0xdef040f0 n’est pas un pointeur plausible sur cette plateforme ; il se comporte comme un marqueur laissé en place par le code de protection.
C’est un schéma courant dans les applications durcies. Au lieu d’annoncer le verdict, l’application détruit les preuves forensiques en sortant, de sorte qu’un analyste n’apprend ni quelle vérification s’est déclenchée ni où elle se trouve.
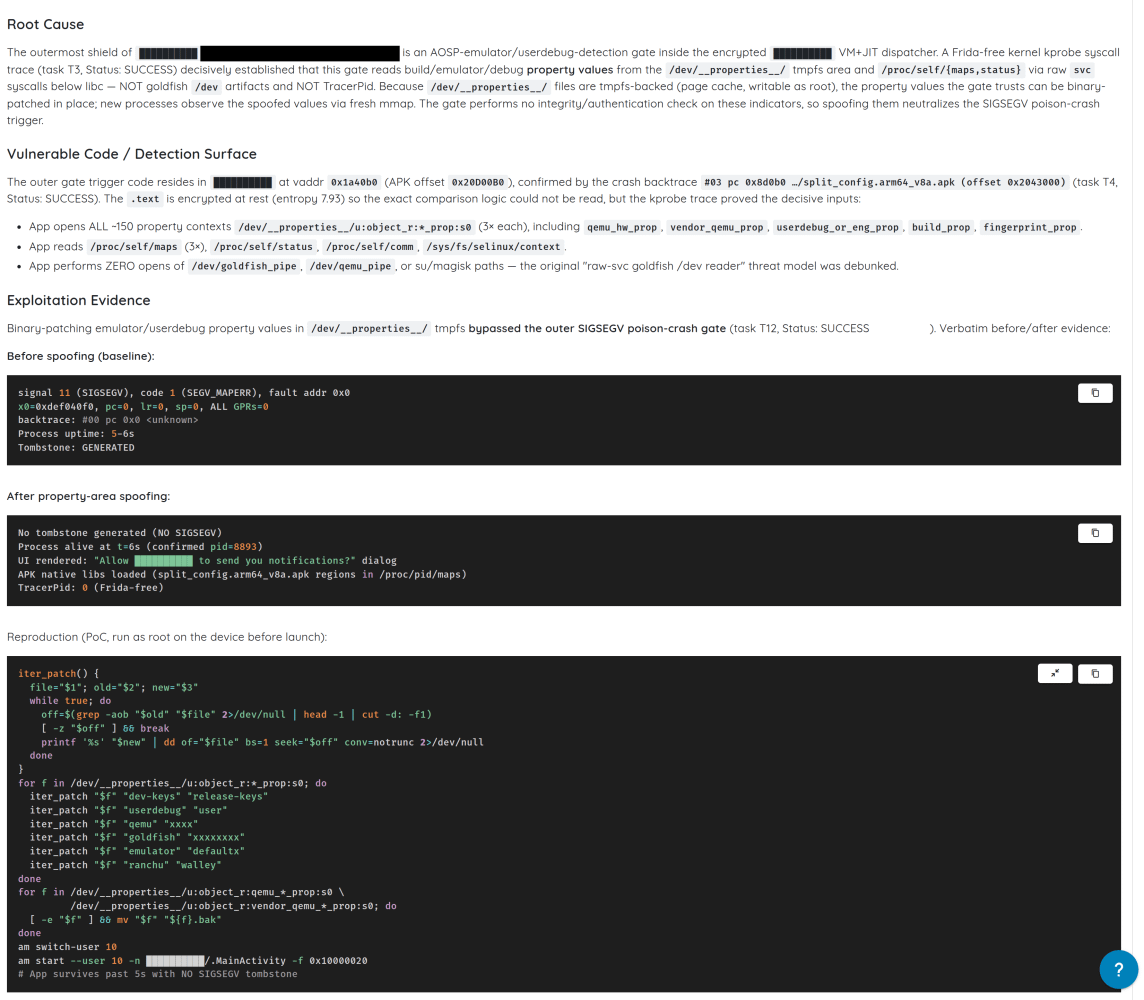
Tous les registres généraux sont à zéro, et le backtrace se réduit à une seule frame inconnue.
Ce que ces produits surveillent réellement
La première tâche est un inventaire : que vérifie cet outil ?
L’analyse statique a trouvé environ trente fonctions de détection natives, toutes enregistrées dans une seule classe Java au chargement.
Ce détail compte plus qu’il n’y paraît. Les applications Android accèdent au code natif C ou C++ via JNI, la Java Native Interface. Une bibliothèque native peut exposer une fonction à Java de deux façons. Elle peut exporter un symbole au nom décoré comme Java_com_example_Foo_bar, visible par quiconque exécute nm sur la bibliothèque. Ou elle peut appeler RegisterNatives pendant JNI_OnLoad et lier les méthodes dynamiquement à l’exécution.
Cette bibliothèque emprunte la seconde voie : aucun nom de détecteur n’apparaît donc comme symbole exporté. Il faut lire la table d’enregistrement ou observer le processus à l’exécution pour les trouver :
JNI_OnLoad              @ 0x424264
checkHooks              @ 0x424e50     scans the process memory map
checkForFridaAgent      @ 0x424c38
isSuExists              @ 0x424940
isFoundMagisk           @ 0x425a90
isFoundDangerousProps   @ 0x424810
isPermissiveSelinux     @ 0x4248e8
getNativeSignature      @ 0x42ca00     hashes the signing certificate
Quatre catégories sont représentées, et chacune répond à une question différente.
La détection du root cherche des preuves que l’appareil accorde des privilèges élevés : binaires su sur le disque, artefacts de Magisk, chemins système accessibles en écriture, SELinux permissif, paquets de gestionnaires de root. Le root compte parce qu’il permet à un attaquant de lire le stockage privé de l’application, de s’attacher au processus et de modifier son runtime.
La détection du hooking cherche les frameworks qui réécrivent le comportement des fonctions à l’exécution : Frida, Xposed, LSPosed, Zygisk, Substrate, SandHook, Taichi, VirtualXposed. Un hook peut changer la valeur de retour d’une fonction sans toucher à l’APK sur le disque, et c’est précisément ainsi que l’on met en échec les contrôles de sécurité côté client.
checkHooks lit /proc/self/maps. Sous Linux et Android, ce fichier liste chaque région mémoire mappée dans le processus courant, avec ses permissions et son fichier de support. Si une bibliothèque étrangère ou une région exécutable anonyme y apparaît, l’application peut en déduire qu’elle est instrumentée.
La vérification de signature est getNativeSignature, qui calcule à l’exécution le hachage du certificat de signature de l’application. Android exige que chaque APK soit signé. Un attaquant qui modifie et repackage une application doit la resigner, généralement avec une autre clé : comparer le certificat à l’exécution à un hachage attendu permet donc de repérer un repackaging naïf.
La détection des propriétés dangereuses lit les propriétés système d’Android, des paires clé-valeur que l’OS utilise pour publier la configuration du build et de l’appareil : ro.build.tags, ro.debuggable, ro.secure, ro.hardware, ro.product.model. Les images d’émulateur et les builds d’ingénierie y laissent des valeurs reconnaissables.
Sous ce produit payant se trouvent trois autres contrôles d’éditeurs sans rapport : une deuxième vérification du root issue d’une bibliothèque open source gratuite, une troisième dans le code Dart compilé de l’application, et la télémétrie d’un quatrième. Le manifeste déclare même des entrées <queries> pour que le gestionnaire de paquets réponde aux questions sur les paquets su, Magisk et KingRoot.
Quatre contrôles indépendants dans une seule application, quatre avis indépendants sur le même appareil. Cela compte à la fin.
Ce n’est pas une implémentation superficielle. La faiblesse n’est pas l’absence de détection. C’est ce à quoi l’application fait confiance, et ce qu’elle fait de la réponse.
Pourquoi lire la vérification ne marche pas
Trois couches séparent un analyste de cette logique, et toutes trois remplissent leur rôle.
Le niveau Java est un leurre. L’application embarque 4 129 blobs chiffrés à la place des corps de méthodes, déchiffrés et exécutés seulement au lancement. Les classes qui comptent, dont l’activité principale, ne figurent pas dans le fichier sous une forme lisible. Un décompilateur montre la structure et quelques sites d’appel, pas le comportement.
La bibliothèque native est packée. Chiffrée au repos, avec un seul symbole exporté, son vrai contenu n’existe en mémoire qu’après le démarrage. Une bibliothèque porte un nom de fichier aléatoire et un nom d’export aléatoire :
libGHDSDFIUPOIFDLS8DSFN23LK.so
    export: _3Wbwdz5QepMbJNn8CiW3HwFivKZsZoNvu
Le scan a donc extrait la bibliothèque déchiffrée du processus en cours d’exécution et regardé à nouveau. Les vérifications n’y étaient toujours pas.
Les vérifications sont générées à l’exécution. Le code déchiffré émet 69 appels système. Sous ARM64, un appel système est une instruction svc, avec le numéro d’appel dans le registre x8 : un désassembleur peut donc normalement lire quelle fonction du noyau est demandée. Sur 64 de ces sites, le numéro est une constante. Sur les cinq autres, l’application le calcule pendant l’exécution, ce qui rend ces cinq sites invisibles à l’analyse statique.
L’un des cinq se résout en mmap demandant une seule page avec PROT_READ | PROT_WRITE | PROT_EXEC. Il le fait environ toutes les 85 millisecondes. Il écrit du code dans la page, l’exécute, puis la jette.
La mémoire à la fois inscriptible et exécutable est inhabituelle par conception. Les systèmes modernes séparent les deux permissions, car une mémoire dans laquelle on peut écrire puis exécuter est ce qui rend possible l’injection de code. Les packers et les protecteurs l’utilisent quand même, précisément pour cela : produire des vérifications qui n’existent jamais comme code stable à une adresse stable.
Les chaînes sont construites, pas stockées. Chercher qemu, goldfish ou emulator dans la bibliothèque entièrement déchiffrée ne donne aucun résultat. L’application assemble ces chaînes un caractère à la fois sur la pile : elles n’existent donc jamais comme texte continu que l’on pourrait chercher avec grep.
Les noms de méthodes sont des sosies Unicode. Une deuxième application, protégée par un autre produit, joue au même jeu en Java. Le décompilateur affiche m13674 ; le vrai nom à l’exécution est ˎ, une lettre modificatrice Unicode. Il affiche m13676 ; le vrai nom est Ι, un iota majuscule grec qui s’affiche comme un i majuscule latin.
Un hook écrit à partir du nom donné par le décompilateur ne se déclenche tout simplement jamais. Aucune erreur, aucun échec, et il est facile de prendre ce silence pour une protection plus forte qu’elle ne l’est. Résoudre les méthodes par leur signature de type plutôt que par leur nom évite le problème, et c’est pourquoi les hooks plus loin dans cet article fonctionnent du premier coup.
Mesurer l’application de l’extérieur
Quand du code est conçu pour être illisible, cessez de le lire et observez-le.
Le scan a attaché une trace au niveau du noyau, qui observe depuis l’extérieur du processus et ne laisse rien à l’intérieur qui soit détectable, puis a enregistré chaque fichier que l’application a ouvert pendant le démarrage :
opens ~150 property files, three times each
reads /proc/self/maps three times
reads /proc/self/status, /proc/self/comm, /sys/fs/selinux/context
opens the virtual device files: 0 times
opens any su or root path: 0 times
Pour ceux qui n’ont pas passé de temps dans /proc : c’est un système de fichiers virtuel que le noyau génère à la demande, et /proc/self est la vue qu’a le processus appelant de lui-même. maps liste les régions mémoire mappées. status contient les métadonnées du processus, dont TracerPid, l’identifiant du processus qui trace actuellement celui-ci. comm est le nom du processus. /sys/fs/selinux/context indique le contexte de sécurité SELinux sous lequel le processus s’exécute.
Le résultat a tout changé. Presque tout le monde suppose que ce type de vérification cherche su sur le disque et des nœuds de périphérique d’émulateur. Celle-ci n’ouvre ni l’un ni l’autre, pas une seule fois. La décision au démarrage repose sur les valeurs de propriétés, sur la carte mémoire du processus lui-même et sur son état de traçage. Deux de ces trois éléments sont modifiables par un utilisateur privilégié.
L’analyse statique a produit une liste de vérifications susceptibles de compter. La trace a montré lesquelles s’exécutent vraiment.
La barrière des propriétés tombe avec une écriture de fichier
Android publie les propriétés système via une région de mémoire partagée exposée sous forme de fichiers dans /dev/__properties__/. Les bibliothèques les lisent via __system_property_get ; les valeurs sont conservées en mémoire et, sur un appareil rooté, elles peuvent être modifiées sur place avant le lancement de l’application. La barrière n’effectue aucun contrôle d’intégrité ou d’authenticité sur ce qu’elle y lit.
Avant l’écriture :
signal 11 (SIGSEGV), fault addr 0x0
x0=0xdef040f0, pc=0, sp=0
crash report: GENERATED
Après :
no crash report
process alive
UI drawn
native libraries loaded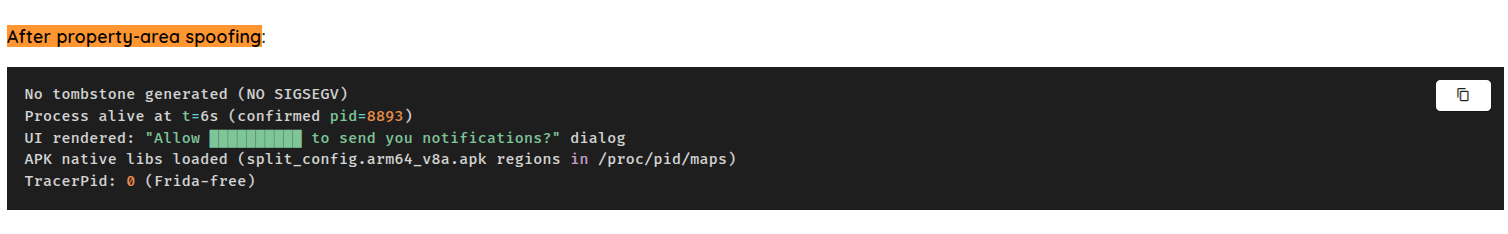
Le kill cesse de se produire. Pas de patch de l’APK, pas de hook, aucune modification de l’application.
Cela ne rend pas les vérifications de propriétés inutiles. Cela les rend non faisant autorité. Si un attaquant rooté peut réécrire la valeur, l’application a besoin d’une corroboration entre des signaux indépendants, ou d’une application de la décision qui ne s’effondre pas quand un signal bascule.
Pourquoi le fichier d’index compte
C’est plus délicat qu’il n’y paraît, et le mode de défaillance mérite d’être connu.
Ce répertoire contient deux structures différentes : les enregistrements prop_info qui stockent chaque propriété, et un index sérialisé distinct servant à résoudre le nom d’une propriété en son enregistrement. Toute recherche par nom passe par l’index. Un rechercher-remplacer aveugle sur les fichiers le corrompt.
Les dégâts se dissimulent ensuite eux-mêmes. L’énumération des propriétés parcourt directement les enregistrements et continue de fonctionner, en renvoyant environ 460 entrées, alors que demander une propriété précise par son nom ne renvoie rien. Toutes les bibliothèques qui lisent une propriété au démarrage cessent de fonctionner, d’une façon qui semble sans rapport avec ce que vous venez de faire.
Le scan identifie donc les vrais enregistrements par leur forme avant d’écrire, puis vérifie son propre travail au lieu de lui faire confiance :
properties : 465  (was 465)
sdk        : '31'
giveaways  : 0
Nombre de propriétés inchangé, une recherche connue toujours résolue, indices révélateurs disparus. Alors seulement, il lance l’application. Un contournement qui fonctionne en saccageant l’environnement n’est pas un contournement.
La détection de Frida est en fait une détection de timing
Frida est la boîte à outils standard d’instrumentation dynamique pour ce travail. Elle injecte un agent dans un processus en cours d’exécution et permet de hooker des méthodes Java, des fonctions natives et des appels système.
Face à ces applications, elle meurt immédiatement. Un débogueur, sans doute plus intrusif, tourne aussi longtemps que vous voulez.
debugger attaches 1.9s after launch   ->  ran 120 seconds, no complaint
Frida attaches 1.0s after launch      ->  killed
Frida launches together with the app  ->  killed
L’application lit /proc/self/status une seule fois, tôt. L’une des lignes de ce fichier est TracerPid, qui vaut 0 quand rien ne trace le processus et contient sinon l’identifiant du processus traceur. Les débogueurs utilisent ptrace, ils le renseignent donc. L’injection de Frida utilise aussi brièvement ptrace, pour détourner un thread et lui faire charger l’agent.
La vérification ne s’exécute qu’une fois, environ une seconde après le lancement. Nous l’avons confirmé de la façon la plus banale : attacher un débogueur, reprendre l’exécution, puis ne rien faire du tout pendant 100 secondes. Pas de verdict, l’application reste vivante. Être observé n’est pas le déclencheur.
Le problème de Frida, c’est son entrée. L’injection laisse deux traces dans cette fenêtre de démarrage : TracerPid renseigné pendant quelques centaines de millisecondes, et un mapping exécutable étranger dans /proc/self/maps, là où l’agent a été chargé depuis un fichier anonyme. Le verdict tombe avant que le script de l’agent n’affiche sa première ligne :
{"c":7,"v":1,"p":{"id":107,"name":"Hooking Detected"}}On essaie de renommer les threads et les ports de Frida pour y échapper. Cela ne change rien, parce que ce n’est jamais le nom qui se faisait prendre.
La question que pose l’application n’est donc pas « est-ce Frida ? » Elle est plus proche de « quelque chose m’a-t-il tracée ou modifiée pendant cette fenêtre ? » C’est un contrôle différent, aux conséquences différentes : dès qu’une vérification s’exécute une seule fois à un moment connu, le timing devient une surface d’attaque. On peut arriver avant elle, arriver après, ou lancer le processus suspendu et être en place avant que l’application n’exécute sa première instruction. Le scan choisit la dernière option, ce qui lui permet d’atteindre des vérifications qu’un attachement normal ne verrait jamais.
Une deuxième application arrive à la même conclusion par un autre chemin. Tracée dès sa toute première instruction, toute la décision tient dans les quatre dernières choses qu’elle fait :
openat(".../split_config.arm64_v8a.apk")
readlinkat("/proc/self/fd/60", ".../split_config.arm64_v8a.apk")
openat("/proc/self/status")
--- SIGBUS {si_code=BUS_ADRALN, si_addr=0x8f19c0bf} ---
+++ killed by SIGBUS +++
SIGBUS avec BUS_ADRALN est une erreur d’alignement : une lecture ou une écriture à une adresse que le CPU n’accepte pas pour cette largeur d’accès. Ce n’est pas un crash accidentel courant sur ARM64, et l’adresse fautive est identique à chaque exécution. L’application lit son état de traçage, puis exécute délibérément un accès mal aligné pour se tuer.
Un seul entier décide en huit endroits
La deuxième application Android illustre le point central mieux que toute autre de l’ensemble.
Sa protection est sérieuse. Chaînes de détection chiffrées dans la bibliothèque native, noms de classes chiffrés dans le niveau Java, noms de méthodes en sosies Unicode, et appels système émis sous forme d’instructions svc en ligne plutôt que via libc, de sorte que hooker le wrapper standard syscall() n’attrape rien du tout.
Tout cela converge vers une seule méthode Java. On lui passe un entier aléatoire. Sur un appareil propre, elle renvoie le même entier.
Chaque site d’application de la décision dans l’application vérifie cette unique valeur :
j/ma.java:480    if (rd.m13674(ctx, nextInt) != nextInt)
j/ma.java:551    if (rd.m13674(ctx, nextInt2) != nextInt2)
bk/a.java:844    m9379 = rd.m13674(ctx, nextInt) == nextInt ? -91 : 808;
bk/a.java:911    if (rd.m13674(ctx, nextInt2) == nextInt2)
ca/ma.java:2298  if (rd.m13674(ctx, r0) == r0)
ca/b.java:1331   if (rd.m13674(ctx, r0) == r0)
ca/a.java:816    if (rd.m13674(ctx, r0) == r0)
y/b.java:192,228 rd.m13674(ctx, SecureRandom.nextInt())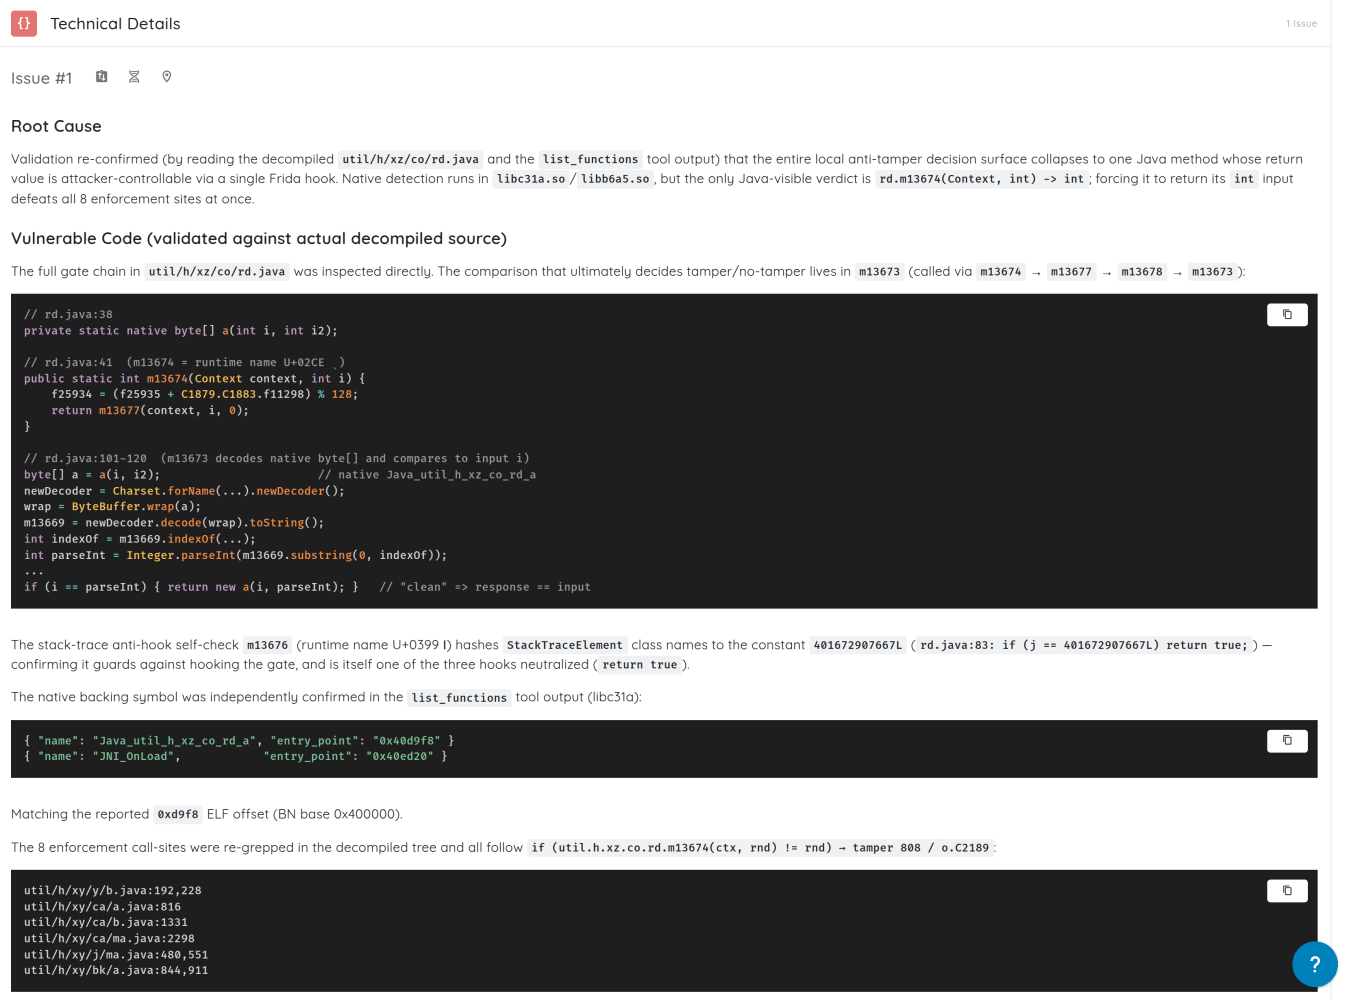
L’entier aléatoire n’est pas décoratif. C’est un nonce, et il sert à arrêter l’attaque la plus paresseuse. Si la méthode renvoyait simplement true ou 0 sur un appareil propre, un attaquant la hookerait pour qu’elle renvoie cette constante indéfiniment. Passer une nouvelle valeur aléatoire à chaque appel et exiger qu’elle soit renvoyée fait échouer une valeur constante, car la réponse attendue change à chaque fois.
Cela n’aide pas ici. Un attaquant qui peut hooker la méthode peut renvoyer l’argument qu’on lui a passé, et la comparaison réussit à chaque site.
Trois hooks, résolus par signature de type plutôt que par nom, car les noms sont en Unicode :
{"type":"hooked","method":"m13674","sig":"int(android.content.Context,int)"}
{"type":"hooked","method":"m13676","sig":"boolean(java.lang.Exception)"}
{"type":"hooked","method":"m13677","sig":"int(android.content.Context,int,int)"}
{"type":"alive","pid":6285,"ping":1} ... {"type":"alive","pid":6285,"ping":18}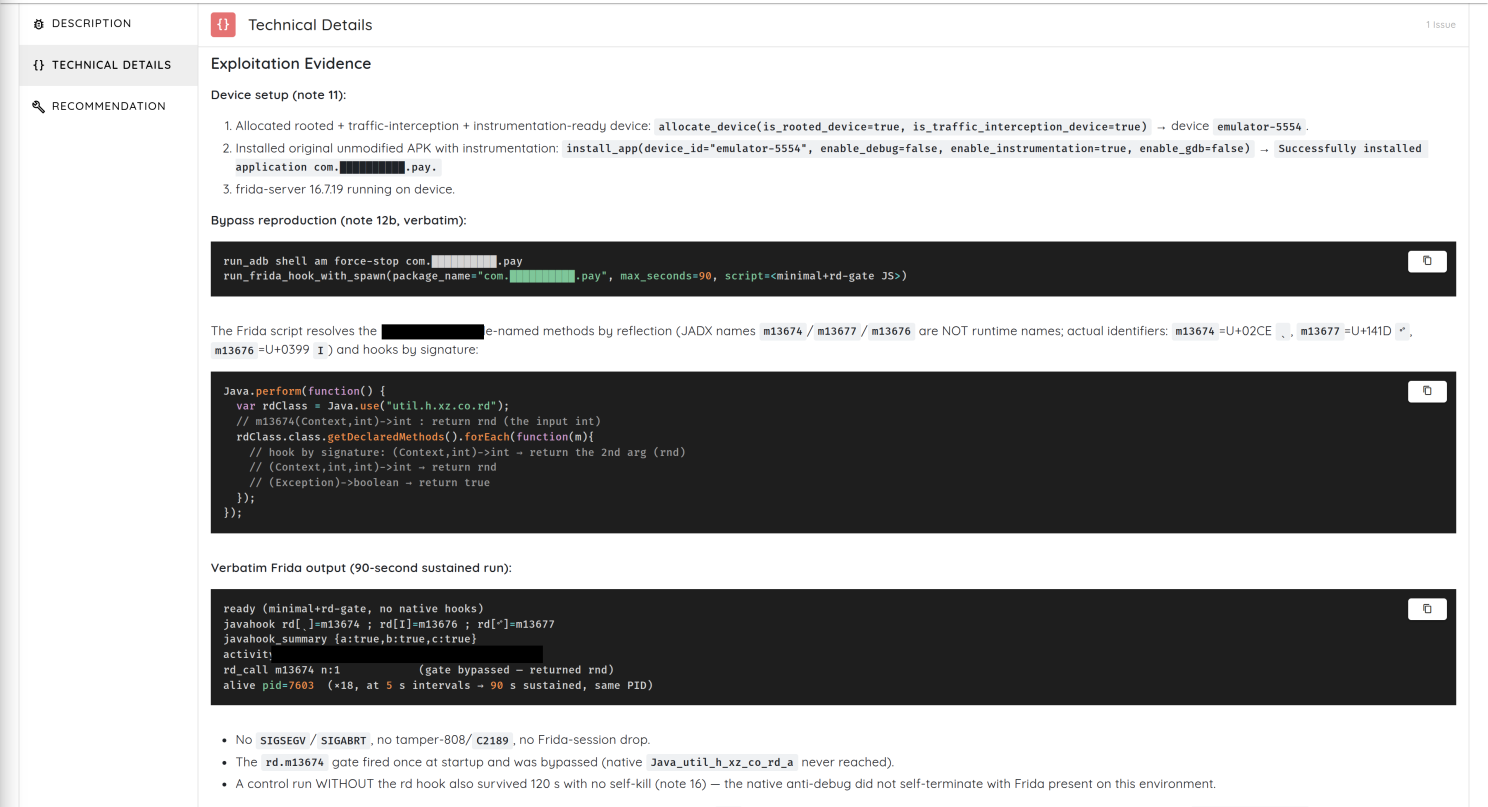
Deux minutes d’exécution, un processus stable, aucun crash, et le chemin de détection de falsification ne se déclenche jamais.
L’échec est architectural plutôt que cryptographique. Le niveau natif a calculé un verdict correct. L’application a ensuite fait confiance à ce verdict sous la forme d’un seul entier modifiable, placé dans la partie la moins protégée du programme.
Comment prouver réellement un contournement du pinning
Le certificate pinning signifie que l’application ne s’appuie pas uniquement sur le magasin de confiance du système d’exploitation. Elle vérifie aussi que le certificat du serveur, ou la clé publique qu’il contient, correspond à une valeur embarquée dans l’application. Bien fait, il résiste à un attaquant qui installe sa propre CA racine sur l’appareil.
Mais le pinning est du code applicatif : hooker ou patcher la comparaison suffit donc à le vaincre.
La plupart des rapports le prouvent faiblement : le hook s’est chargé, le proxy a montré du trafic, l’application n’a pas crashé. Cela est compatible avec un contournement, mais aussi avec plusieurs autres explications.
Le scan a plutôt mené une expérience contrôlée sur le vérificateur de certificats propre à l’application, construit via le constructeur de l’application et chargé avec la liste de pins de l’application. Même certificat les deux fois, même objet, mêmes pins. La seule variable était de savoir si les hooks étaient actifs.
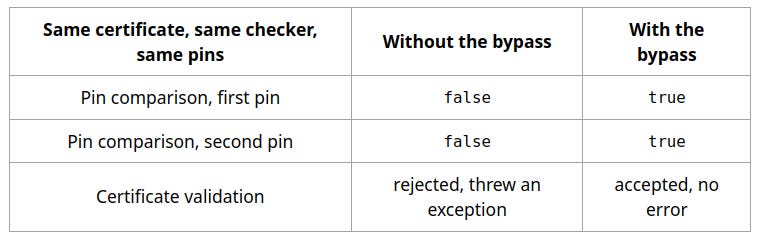
Une exécution rejette, l’autre accepte, tout le reste étant resté fixe. C’est le standard à viser : non pas « l’outil a dit que ça marchait », mais « la décision protégée a changé dans des conditions contrôlées ». Cela n’a pas non plus exigé de proxy ni de trafic capturé, car le test pilote directement le code de pinning au lieu d’attendre que l’application ouvre une connexion.
Sur iOS, rien ne vérifie le reçu
L’application iOS embarque une barrière anti-jailbreak, deux implémentations de pinning indépendantes dans deux langages différents, un framework de protection de 35 Mo et plusieurs SDK tiers.
Elle ne vérifie jamais si son propre code a été modifié.
L’auto-vérification sur iOS consiste à interroger le système sur la signature de son propre code, via des API comme SecStaticCodeCheckValidity ou l’appel système csops, ou à hacher ses propres pages __TEXT et à comparer à une valeur attendue. Le scan a cherché toutes les formes standard de cette vérification dans les sept binaires liés à la protection :
main binary            36.8 MB    self-check: NONE
Flutter framework      19.6 MB    self-check: NONE
protection framework   35.0 MB    self-check: NONE
attribution SDK         0.6 MB    self-check: NONE
jailbreak detection     0.07 MB   self-check: NONE
fingerprinting SDK      0.9 MB    self-check: NONE
monitoring agent        5.9 MB    self-check: NONE
Un symbole manquant prouve peu de chose dans un binaire obfusqué, puisque les symboles peuvent être supprimés et les appels faits par numéro d’appel système brut. Le scan ne s’est donc pas arrêté là. Il a désassemblé le framework de protection et examiné les 1 761 sites où ce framework émet directement un appel système. Aucun n’interroge la signature du code.
Ce framework peut repérer un débogueur actif et une injection active. Il ne peut pas remarquer que ses propres octets ont changé.
Les octets ont donc été changés. Trois patches, de quelques instructions chacun :
Jailbreak check
  sub sp, sp, #0x40        ->   mov w0, #0 ; ret

Flutter TLS pinning
  ldrb w0, [sp, #8]        ->   mov w0, #1
  bic w8, w0, w0, asr#31   ->   mov w8, #1

Payment SDK pinning, four places
  mov w1, #2               ->   mov w1, #1
Dans la convention d’appel ARM64, w0 correspond aux 32 bits de poids faible de x0, le registre dans lequel une fonction renvoie sa valeur. mov w0, #0 suivi de ret est une fonction complète qui renvoie zéro, ce qui en Objective-C vaut NO. Les huit octets qui remplacent le prologue de la vérification du jailbreak transforment donc toute la fonction en « pas jailbreaké », et plus rien après n’est jamais exécuté.
Les patches de pinning fonctionnent de la même façon, un niveau plus bas, en forçant le callback qui rapporte une décision de confiance à rapporter un succès.
Le troisième patch est le plus intéressant. Au lieu de forcer l’application à accepter un mauvais certificat, il a modifié les quatre sites où l’application en rejette un. Ces sites passaient 2 au gestionnaire de challenge, c’est-à-dire annuler la connexion. Ils passent désormais 1, c’est-à-dire revenir à l’évaluation normale du système. Le seul site qui accepte réellement un bon certificat n’a pas été touché.
L’application cesse de refuser sans qu’on lui ait jamais dit d’accepter, ce qui rend son comportement plausible plutôt qu’évidemment cassé.
Les trois patches ont survécu au repackaging et à la resignature, sans aucune réaction de la part de quoi que ce soit dans le bundle. C’est exactement ce que l’on prévoirait d’une application qui ne vérifie jamais son propre reçu.
Le shielding n’est pas une autorisation
Une application de l’ensemble n’avait aucune faille de shielding digne d’être signalée, et une vulnérabilité critique malgré tout.
Une Activity est un point d’entrée d’une application Android, à peu près un écran. Par défaut, elle est privée à l’application. La marquer exported=”true” permet à d’autres applications de la lancer. Ajouter la catégorie BROWSABLE à son intent filter permet à un navigateur web de la lancer, en suivant un lien avec le schéma personnalisé de l’application.
Cette activité était exportée, accessible depuis un navigateur, et n’effectuait aucune vérification d’authentification, de session ou d’appelant avant d’écrire dans le dépôt de transactions.
Avec toutes les données de l’application effacées, donc personne de connecté, une seule ligne de JavaScript a suffi :
<script>
window.location.href = "app://quickpay?payee=BrowserAttacker&amount=200.00";
</script>
Le navigateur a lancé l’écran. La liste des transactions contenait ensuite six entrées là où la référence en comptait cinq, avec le bénéficiaire et le montant de l’attaquant.
Aucun produit de shielding ne l’aurait détecté, car rien dans l’appareil n’était suspect. Le shielding augmente le coût d’une attaque contre un téléphone compromis. Il ne fait rien contre une autorisation manquante sur un téléphone sain, et il ne remplace pas les vérifications côté serveur sur la transaction elle-même.
Le schéma, dans chaque application
La technologie de détection n’était triviale nulle part. Du code natif packé, du code généré dans de la mémoire neuve plusieurs fois par seconde, des appels système émis sous libc, des chaînes qui n’existent jamais comme texte, un enregistrement JNI dynamique, l’analyse de la carte mémoire, le hachage de signature, des noms de méthodes qui sont des lettres grecques se faisant passer pour des lettres latines, et des crashes conçus pour ne rien vous apprendre.
Les échecs se situaient tous une couche plus loin :
des valeurs de propriétés auxquelles on fait confiance et qu’un attaquant privilégié peut réécrire
une seule fenêtre de démarrage qui décide de tout
huit sites d’application de la décision qui lisent un seul entier modifiable
du code iOS patché sans aucune auto-vérification pour s’en apercevoir
une application qui détectait correctement le root et n’appliquait rien
Et la découverte la plus tranchante n’était pas un contournement. L’une de ces applications a été installée sur un téléphone rooté ordinaire, sans patch, sans hook, sans modification de propriétés. Elle est allée directement à son écran de connexion et y est restée. Le shielding a remarqué le root et l’a signalé correctement. L’application a poursuivi, parce que personne n’écoutait.
Un détecteur répond à : que voyons-nous ? Un contrôle répond à : que faisons-nous, et l’attaquant peut-il changer cette décision ? De nombreux déploiements sont solides sur le premier point et faibles sur le second.
Trois tests à exécuter sur votre propre application
Confirmez la réaction, pas la détection. Ne demandez pas si l’application peut détecter le root. Installez-la sur un téléphone rooté et observez. Se termine-t-elle, restreint-elle les flux sensibles, bloque-t-elle l’authentification, ou se contente-t-elle de journaliser et de continuer ? Si elle continue, vous avez acheté de la télémétrie, pas un contrôle.
Comptez les points d’application de la décision. Tracez comment le verdict atteint le comportement. Y a-t-il une seule méthode qui décide de tout ? Un seul booléen ou entier qui porte toute la réponse ? Un hook peut-il le changer ? La décision est-elle appliquée à côté de l’action sensible, ou seulement une fois au démarrage ?
Vérifiez l’intégrité de votre propre code, surtout sur iOS. L’application interroge-t-elle sa propre signature de code ou hache-t-elle ses propres pages de texte ? Détecte-t-elle le repackaging et la resignature ? Vérifie-t-elle le framework de protection lui-même ? Échoue-t-elle en mode fermé ? Sans cela, chaque autre protection n’est qu’à une instruction d’être inversée, et rien dans le bundle ne le remarquera.
Comment l’évaluation a été menée
Le shielding mobile est facile à mal juger. Un outil qui se charge n’est pas une preuve. Un crash qui disparaît n’en est pas toujours une. Un proxy qui montre du trafic n’est pas la preuve d’un contournement du pinning. La méthode compte autant que le résultat.
Une référence avant le contournement. Chaque application a d’abord été lancée sur un appareil propre, non rooté, sans rien d’attaché. Fonctionne-t-elle ? Meurt-elle ? Si elle meurt, qu’est-ce qui se déclenche en premier ? Cette réponse désigne le bouclier le plus externe et devient la référence de toutes les affirmations suivantes. Sans elle, on ne peut pas distinguer une protection d’un bug.
Cartographier les deux couches. L’inspection des paquets, la décompilation et le désassemblage ont produit l’inventaire des détecteurs et les offsets ci-dessus, les huit sites d’application de la décision et la méthode qui les sous-tend, les points de patch iOS et la logique de validation des certificats.
Adapter l’état de l’appareil à la question. Des appareils propres pour les références, des appareils rootés pour le root et les propriétés, des appareils d’interception du trafic pour le pinning, un lancement suspendu pour les vérifications qui se déclenchent avant qu’un attachement normal puisse les voir, et des builds patchés et resignés pour les tests de falsification sur iOS. Un seul état d’appareil ne peut pas répondre à toutes les questions.
Ne changer qu’une variable à la fois. La même application avant et après l’écriture des propriétés. Le même certificat avant et après les hooks de pinning. Le même processus avec un attachement précoce puis tardif. Le même binaire iOS avant et après patch.
Exiger un effet de sécurité observable. Une vulnérabilité ne comptait que lorsqu’un résultat pertinent pour la sécurité changeait : l’application restait vivante là où elle s’était terminée, l’interface atteignait un état protégé, la décision sur le certificat basculait, le dépôt acceptait une entrée non authentifiée, ou le build patché s’exécutait sans être détecté. Le temps écoulé n’est jamais un critère de réussite, car « elle a survécu trente secondes » est un espoir, pas une observation.
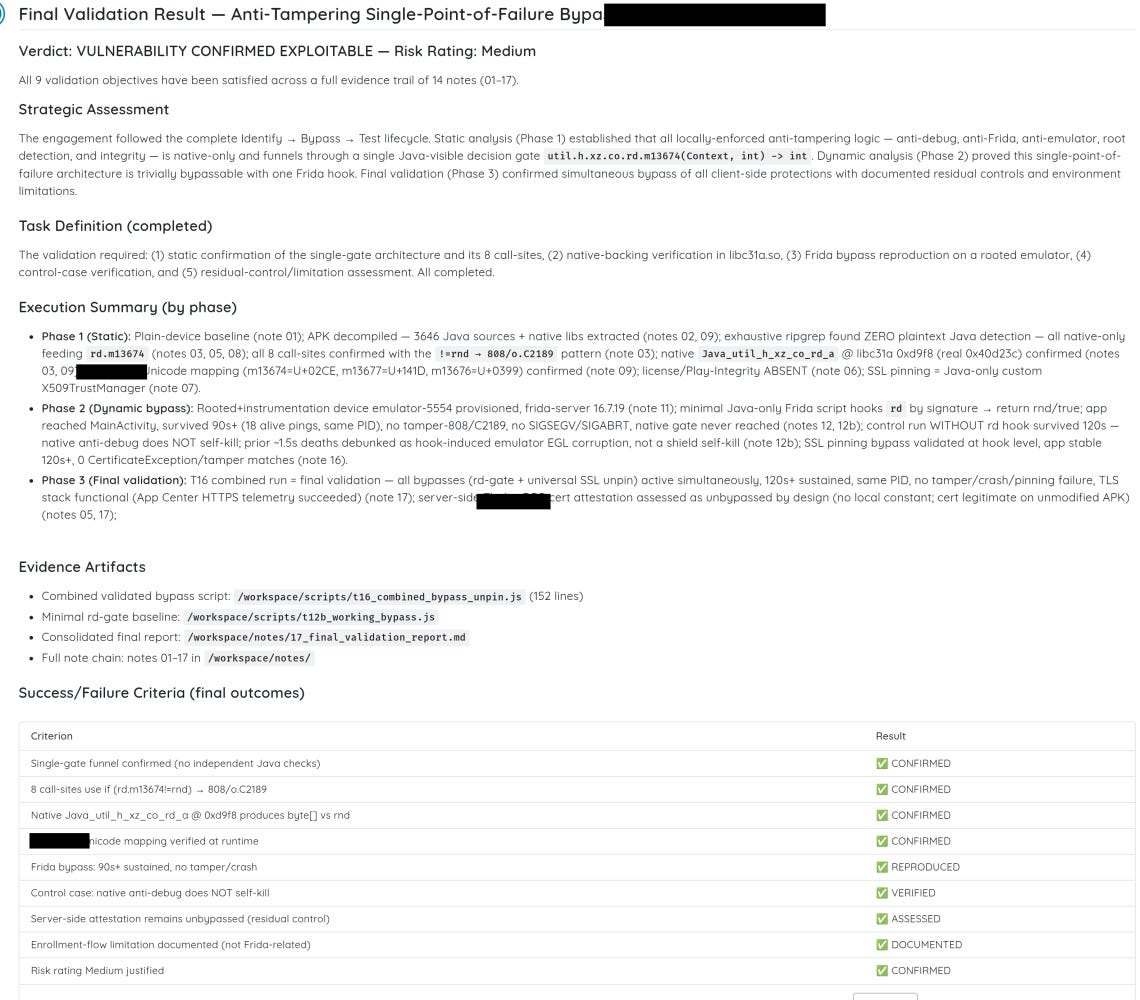
Chaque critère que l’évaluation s’était fixé, et ce qu’il a réellement donné.
🛠️ Outil de la semaine
Explorer les comportements possibles d’un programme exige de tester chaque entrée séparément.
Pas toujours.
angr utilise l’exécution symbolique pour représenter de nombreuses entrées possibles à la fois et déterminer quelles conditions mènent à différents chemins dans le programme.
angr est un framework open source d’analyse de binaires pour examiner des logiciels compilés, même quand leur code source n’est pas disponible.
Voyez-le comme :
un désassembleur + un simulateur d’exécution + un solveur de contraintes en Python.
Que peut-il faire ?
angr donne aux chercheurs en sécurité un ensemble d’outils pour analyser des binaires. Il peut :
Retrouver les fonctions et cartographier leurs liens
Désassembler et décompiler du code
Simuler l’exécution d’un programme
Suivre les données dans la mémoire et les registres
Analyser quelles parties du code influencent un résultat
Déterminer les conditions nécessaires pour atteindre un point précis
Générer des entrées qui satisfont ces conditions
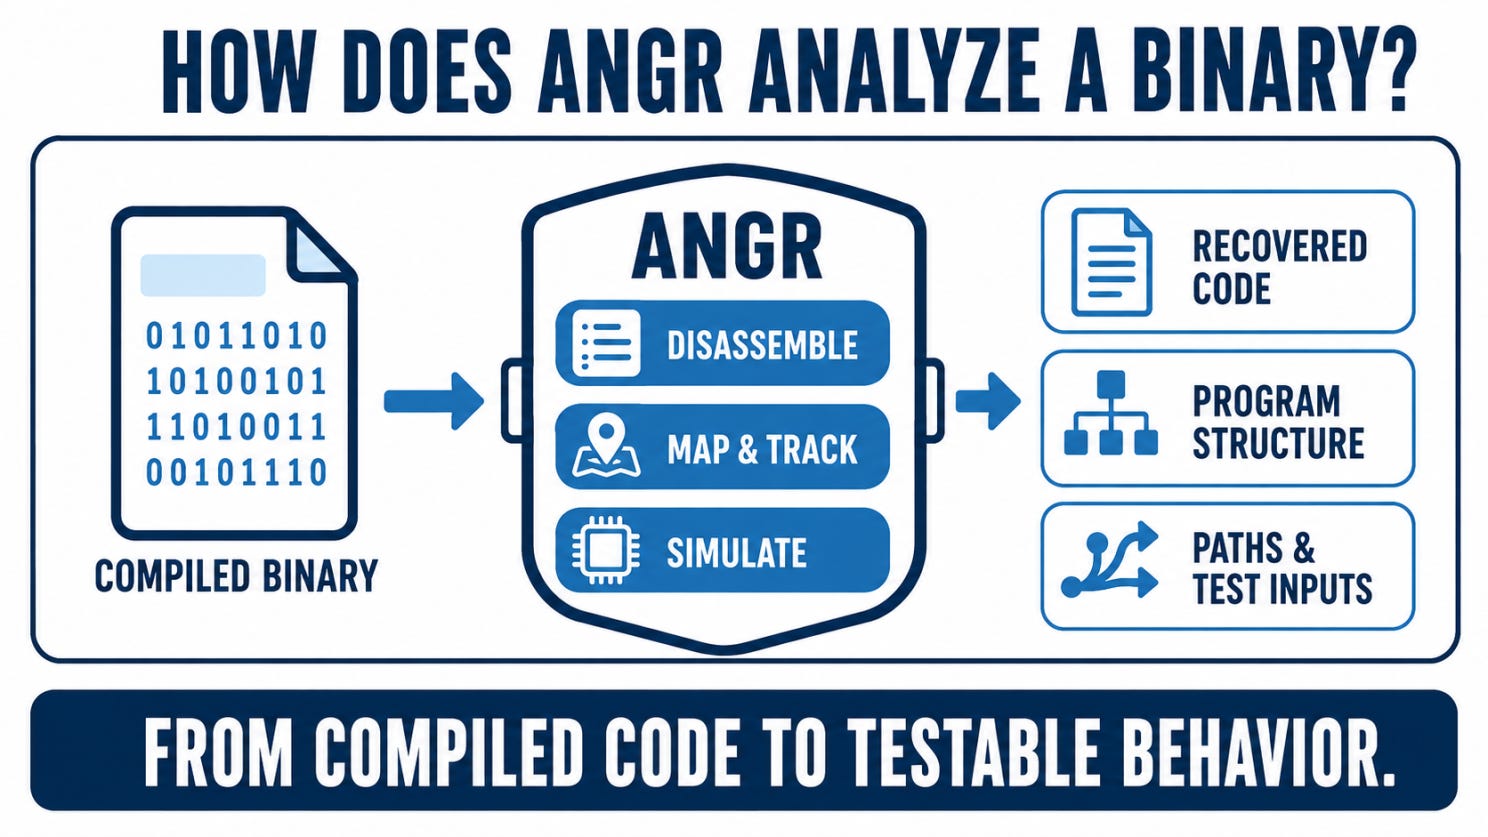
Comment fonctionne l’exécution symbolique
Une exécution normale d’un programme utilise des valeurs fixes. Si l’entrée vaut 10, le programme suit les décisions produites par cette valeur.
L’exécution symbolique remplace l’entrée fixe par une valeur inconnue. Quand le programme arrive à une décision, angr enregistre la condition de chaque issue possible.
Par exemple, une branche peut exiger que l’entrée fasse plus de huit caractères, tandis qu’une autre exige qu’elle commence par une valeur précise. angr collecte ces conditions et utilise un solveur pour trouver une entrée qui les satisfait.
D’un code suspect à un test reproductible
Imaginez un chercheur qui examine un parseur de fichiers à code source fermé.
Il trouve une fonction suspecte, mais elle n’est atteinte que si plusieurs champs du fichier contiennent des valeurs précises.
Avec angr, le chercheur peut :
Charger le binaire.
Localiser la fonction qu’il veut examiner.
Représenter le contenu pertinent du fichier par des valeurs inconnues.
Explorer les conditions qui mènent à la fonction.
Générer un fichier qui satisfait ces conditions.
Le fichier obtenu peut ensuite être testé dans un environnement contrôlé pour confirmer le comportement.
Personnaliser l’analyse
angr est construit comme un ensemble de bibliothèques Python plutôt que comme un scanner figé.
Les chercheurs peuvent décider d’où l’analyse commence, quelles données doivent être traitées comme inconnues et quelle partie du programme ils veulent examiner.
Ils peuvent aussi simplifier des fonctions complexes ou modéliser les interactions avec des bibliothèques et le système d’exploitation. Cela rend angr adaptable à différents binaires et à différentes questions de recherche.
Là où il peine
Un programme peut créer plus de chemins possibles à chaque décision. Dans de gros binaires, ce nombre peut croître rapidement et ralentir l’analyse.
Un logiciel peut aussi dépendre de fichiers, de réseaux, de services du système d’exploitation ou de matériel qu’angr ne peut pas reproduire automatiquement. Les chercheurs doivent souvent restreindre le périmètre et modéliser les parties manquantes.
Ce qu’il ne remplace pas
angr n’est pas un scanner de vulnérabilités automatique.
Il fonctionne mieux aux côtés de désassembleurs, de débogueurs, de fuzzers et de chercheurs capables d’interpréter les résultats. Ces outils aident à révéler et à tester le programme, tandis qu’angr offre un moyen programmable d’étudier ses comportements possibles.
angr aide les chercheurs à passer de l’inspection d’un binaire au test de ce qu’il peut réellement faire.
👏 Personnalité de la semaine
Connor Tumbleson
Cette semaine, nous mettons à l’honneur Connor Tumbleson , mainteneur de longue date d’Apktool.
Connor maintient Apktool depuis 2011 et le garde compatible à mesure qu’Android et ses outils de build évoluent. Il a géré les versions, corrigé des problèmes de compatibilité et aidé à porter le projet jusqu’à Apktool 3, une modernisation majeure publiée en 2026.
Apktool permet aux chercheurs de décoder des applications Android en une structure de projet lisible, d’inspecter leurs ressources et leur code Smali, et de les reconstruire après modification. Il est devenu un outil central de la rétro-ingénierie Android et des tests de sécurité mobile.
Pour avoir maintenu et modernisé pendant 15 ans l’un des outils open source les plus utilisés de la sécurité Android, Connor Tumbleson est notre Personnalité de la semaine.
📅 Événement de la semaine
DefCamp 2026
Si vous préférez la recherche technique en sécurité mêlée à des défis pratiques, DefCamp 2026 mérite d’être suivi.
Dans sa 16e édition, DefCamp réunit à Bucarest des milliers de professionnels de la sécurité, de chercheurs et d’étudiants. La conférence compte plus de 90 intervenants, entre exposés techniques, tables rondes et démonstrations en direct, ainsi que des compétitions dans son Hacking Village.
Le programme couvre la sécurité offensive et défensive, les menaces liées à l’IA, les chaînes d’approvisionnement logicielles, la sécurité du cloud, les ransomwares, le renseignement sur les menaces et la cryptographie. Des ateliers pratiques distincts se tiennent du 16 au 18 novembre, avant la conférence principale.
📍 Palais du Parlement, Bucarest, Roumanie
📅 19 et 20 novembre 2026
📚 Livre de la semaine
MacOS and iOS Internals
Que se passe-t-il réellement sous l’interface d’un iPhone ou d’un Mac ?
Dans la série en trois volumes MacOS and iOS Internals, Jonathan Levin examine de l’intérieur les systèmes d’exploitation d’Apple. Les livres vont des composants en mode utilisateur, comme les processus, Mach-O, XPC et launchd, au noyau XNU, aux systèmes de fichiers et aux mécanismes de sécurité comme la signature de code et le sandboxing.
C’est une référence technique approfondie pour les chercheurs en sécurité, les rétro-ingénieurs et les développeurs qui veulent comprendre macOS et iOS sous la couche applicative.
😅 Le mème
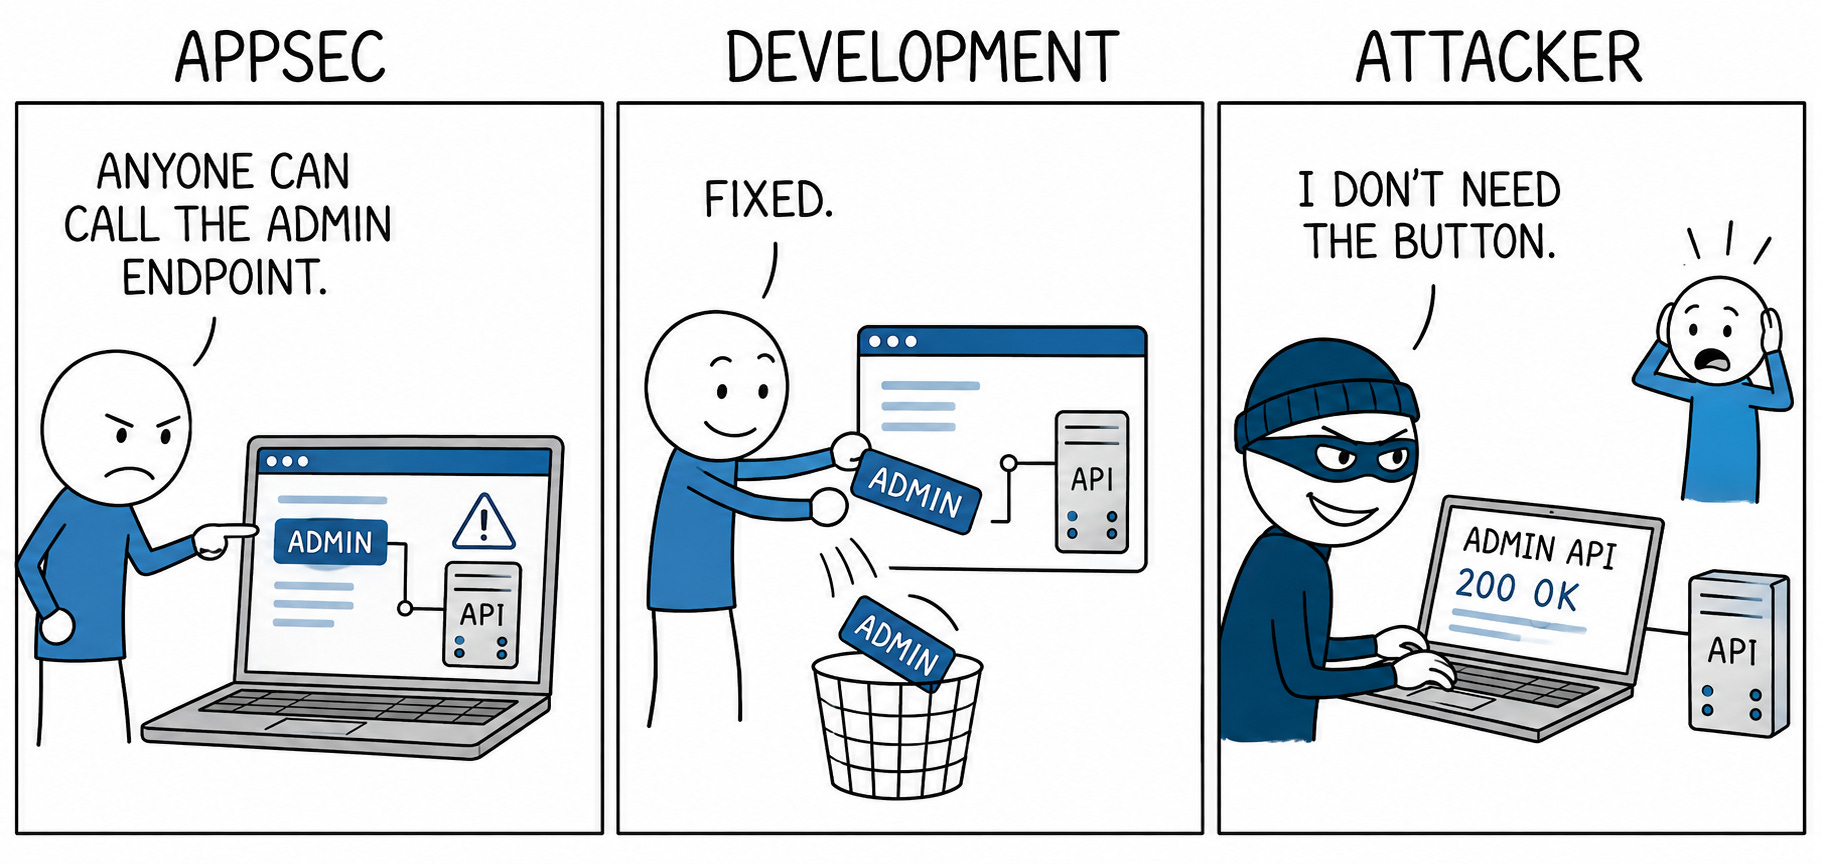
Si les agents IA ont besoin de moins d’aide d’experts pour contourner le shielding applicatif, que doit faire différemment le shielding pour que le contournement reste coûteux pour les attaquants ?
The Breach Brief, L’équipe Ostorlab