AIはいかにして複雑な脆弱性を検出するか:エージェント型ペンテストとエクスプロイトチェーンの内幕
ルールベースのスキャナーが見逃すビジネスロジックの不備を、エージェント型AIがいかに検出するかを解説します。修正済みの検出結果がテナント全体の侵害へとエスカレーションした実際のエクスプロイトチェーンを紹介します。
SQLインジェクションを見つけるのは容易です。ペイロードが送信され、エラーが返され、スキャナーがそれを検出します。これはパターンマッチングであり、従来のアプリケーションセキュリティ(AppSec)ツールは過去20年にわたりこれを得意としてきました。
ビジネスロジックの不備はまったく別の問題です。不正な形式のデータは存在せず、何らかの障害を引き起こすペイロードもありません。リクエストは構文上完璧で、完全に認証されており、全面的に「有効」です。ただ、一般ユーザーが社内専用の割引コードを適用できてしまったり、認証された攻撃者がURL内の整数を1つ減らすだけで別テナントの請求書を取得できてしまったりするなど、ビジネス上まったく意図されていない処理を実行するだけです。これに対応するシグネチャは存在しません。「このワークフローはビジネス上意味をなさない」という正規表現もありません。これを捉えるには、アプリケーションが本来何をすべきかという「意図」を理解し、その意図をいかにして覆せるかを推論する必要があります。
この推論のギャップこそ、エージェント型AIが埋め始めつつある領域であり、オフェンシブセキュリティにおけるAIをめぐる表現が「よりスマートなスキャン」から「人間のハッカーのように振る舞う自律型エージェント」へと変化した理由でもあります。本記事では、それが実際にどのように機能するのかを技術的な観点から解説します。エージェントがどのようにコンテキストを構築し、攻撃経路をマッピングし、単体では無害に見える検出結果を連鎖させてクリティカルなエクスプロイトを構成するのか、そしてこのアプローチが今なお直面している現実的な限界についても触れます。理論と並行して、まさにこのような推論によって、すでに「修正済み」とマークされていたハードコードされた認証情報がテナント全体のID乗っ取りへと発展した、Ostorlab Agentic Deep Scanの実際の検出結果を紹介します。
エージェント型ペンテストとは:エージェント型ペンテスト(ペネトレーションテスト)とは、自律型AIエージェントを活用してアプリケーションのコンテキストモデルを構築し、複数ステップにわたる攻撃経路をマッピングして、一見重大度の低い検出結果を連鎖させてクリティカルなエクスプロイトを構成する手法であり、人間のセキュリティリサーチャーの推論ループを模倣します。
ルールベースのスキャナーが限界に直面する理由
静的アプリケーションセキュリティテスト(SAST)と動的アプリケーションセキュリティテスト(DAST)のツールは、入力やコードを既知の不正パターンと照合するという、同じ基本的なプリミティブに基づいて構築されています。このプリミティブは高速で、決定論的であり、CIパイプラインでの実行コストも低く抑えられます。しかし、どれほどルールを追加しても完全には解消できない3つの構造的な死角が存在します。
| 制限事項 | 発生理由 | 見逃される問題 |
|---|---|---|
| リクエストをまたぐ状態の欠如 | スキャナーは通常、エンドポイントをリクエストごとに個別に評価するため | 複数ステップの悪用:商品の追加、クーポンの適用、購入前の数量の負数への変更など |
| 「あるべき姿」の概念の欠如 | ルールは構文をエンコードするものであり意図ではないため。構文上有効なリクエストをシグネチャで検知することは不可能 | リクエストの形式に問題がないため、ロールを一切確認しない管理者専用のエクスポートエンドポイントを一般ユーザーが呼び出してしまうケース |
| アカウント間における認可コンテキストの欠如 | 単一セッションのクローラーでは、オブジェクトが誰のデータに属しているかを推論しにくいため | オブジェクトレベルの認可の不備(BOLA)/安全でないオブジェクト直接参照(IDOR):オブジェクト1041を所有するユーザーにオブジェクト1042が返され、200 OKと有効なJSONが返されるケース |
ベンダーはルールの追加や正規表現の拡充、シグネチャデータベースの大規模化によってこれらのギャップを埋めようとしてきましたが、基盤となるアーキテクチャは依然としてリアクティブ(事後対応的)なままです。つまり、その場でマッチングし、その場で対応し、直前の10回のリクエストは完全に忘却されます。ビジネスロジックの脆弱性は、まさにこのアーキテクチャが見落とすギャップ、すなわち複数ステップの間、複数アカウントの間、そしてワークフローが本来許可すべき挙動と実際に許可している挙動のギャップに存在しています。
ここでの「エージェント型」が実際に意味するもの
エージェント型ペンテストシステムは、単一の「照合して報告する」ステップを、人間のペンテスターが実際に作業する進め方に極めて近いループへと置き換えます。
- 偵察(Recon):アタックサーフェスの列挙。エンドポイント、パラメーター、認証フロー、ロール、隠蔽されたまたは非公開のAPIルートなど。
- 仮説(Hypothesis):観察された挙動に基づいて何が問題になり得るかを推論(「このエンドポイントは
order_idを受け付けるが所有権を一切確認していないため、BOLAの候補としてテストする価値がある」など)。 - テスト(Test):仮説を実証または反証するリクエストを作成して送信し、レスポンスに応じて適応。
- 検証(Validate):通常は実際の影響を再現することにより、検出結果が誤検知(フォールスポジティブ)ではなく真に悪用可能であることを確認。
- 連鎖(Chain):この検出結果が、すでに発見された他の要素と組み合わさることで、エージェントがまだ試していない新たな経路を切り開くかどうかを検討。
ステップ2とステップ5にこそ決定的な違いがあります。 ルールベースのスキャナーが備えているのはステップ3と、不完全な形でのステップ4のみです。意図に関する仮説を立てることはなく、現在の検出結果と組み合わせるための過去の検出結果の記憶も保持していません。これに対し、大規模言語モデル(LLM)を活用したエージェントは、学習した内容、疑わしい点、すでに除外した要素といったアプリケーションの動的モデルを維持し続けます。そして、人間のテスターが複数日にわたる診断期間中に頭の中でメモを取り続けるのと同じように、そのモデルを使用して次に何を試すべきかを判断します。
攻撃を開始する前のコンテキスト認識の構築
エージェントが意味のある問題を発見するには、単なるURLリストをはるかに超えた、アプリケーションの実用的なモデルをあらかじめ構築しておく必要があります。実際には、このコンテキスト構築フェーズは通常、以下の要素を網羅します。
- 認可モデル:どのようなロールが存在し、各ロールが本来何を実行できるはずであり、それがどのように強制されているか(JWTクレーム、セッション状態、RBACミドルウェア、あるいは後述の事例が示すように、特定のOAuthクライアントが実際にどのアウディエンスやスコープに対して登録されているかなど)。
- APIおよびスキーマの構造:OpenAPI/Swagger仕様、GraphQLのイントロスペクション、またはコード認識型のエージェント構成では、リポジトリから取得した実際のルーティングとコントローラーロジック。
- 複数ステップのワークフロー:チェックアウトフロー、オンボーディング、パスワードリセット、招待・承認チェーンなど。単にエンドポイントを列挙するだけでなく、一般ユーザーと同じように実際にアプリケーションを操作することで再構築。
- コードレベルの到達可能性:コード認識型のエージェントでは、危険な関数の名前をすべて機械的にフラグ付けするのではなく、エントリポイント(HTTPルート、メッセージキューのコンシューマー)からコールグラフを走査し、汚染された入力が機密性の高いシンクに実際に到達可能かどうかを確認。
これは、有能な人間のペンテスターが診断の偵察・マッピングフェーズで行う下準備(ドキュメントの確認、異なるロールとしてのアプリの操作、権限境界が存在すべき箇所の把握)と同じです。ただしエージェントは、スキーマ全体、各ロールに許可された操作、過去のすべてのテスト結果を作業メモリ上に同時に保持し、新たな検出結果によって状況が変わるたびにそのすべてを再確認できます。
個別の検出結果から攻撃経路へ
エージェントはアプリケーションのモデルを獲得すると、各エンドポイントを個別のテスト対象として扱うのをやめ、アプリケーション全体をエントリポイント、信頼境界、それらを結ぶエッジからなるグラフとして捉え始めます。これはスキャンというよりも攻撃経路のマッピングに近く、「このエンドポイントに脆弱性はあるか」という問いから、「これまでに発見されたすべての情報を考慮したとき、未認証のリクエストから管理者権限へのアクセス、別テナントのデータ、資金移動といった重要リソースに至る最短経路はどれか」という問いへと変化します。
このグラフとしての視点こそが、そもそもエクスプロイトの連鎖を可能にする要因です。単体では行き止まりに見える検出結果(たとえば直接的な影響のない情報漏えいなど)であっても、他の2つの検出結果を結びつけてシステム全体の完全な侵害へと導く有効な経路を完成させる、欠落していたエッジになる可能性があります。ルールベースのスキャナーはグラフを持たず、独立したアラートのリストを持つにすぎません。一方エージェントは、常に更新し続けるグラフを保持しています。
中核となる技術:低重大度の検出結果を連鎖させてクリティカルなエクスプロイトを構成する
これはエージェント型テストを従来のスキャンと最も差別化する機能であるため、実際の事例を見る前に、現実的で分かりやすい例を一通り確認しておく価値があります。
シナリオ:一般的な請求機能を備えた、マルチテナント構成のB2B SaaSプラットフォーム。
検出結果1(低:情報):/api/v1/users/{id}/profileのエラーレスポンスから、ユーザーIDが連番の整数であることが漏えいしており、範囲外のIDに対してエンドポイントが適切な403ではなく汎用的な「not found」を返します。返されるプロファイルデータが最小限であるため技術的には低重大度ですが、ID空間が列挙可能であることが確認されます。
検出結果2(中:BOLA):/api/v1/invoices/{id}は認証を行いますが認可は行いません。有効なセッションの存在は確認するものの、リクエストを行っているユーザーのテナントが対象の請求書を所有しているかは一切確認しません。請求書には認証情報が含まれていないため、単体ではチームによって「中」とトリアージされることがよくあります。
検出結果3(低:設計上の弱点):生成された請求書PDFには、暗号学的に安全なランダム値ではなく予測可能なシード(タイムスタンプ + ユーザーID)から生成された、24時間有効なパスワードリセットトークンを含む「サブスクリプションの管理」ディープリンクが埋め込まれています。単体で悪用するには特定のユーザーIDと作成タイムスタンプをあらかじめ把握しておく必要があるため、「低」としてフラグ付けされます。
個別に見た場合:3つのチケットであり、「中」を超えるものはなく、数か月先の定期スプリントに回される可能性が高い状態です。
これらを連鎖させた場合:検出結果1からIDの列挙可能性をすでにマッピングしているエージェントは、それを利用して検出結果2に対して請求書IDを順番に試行し、管理者アカウントに属するものに行き当たるまでテナントをまたいで請求書を取得します。その請求書PDFには、検出結果3のディープリンクが含まれています。トークンの生成シードが導出可能になったため(エージェントは請求書のメタデータからユーザーIDを、請求書の日付からタイムスタンプの範囲を取得済み)、有効なリセットトークンを再構築して管理者のパスワードをリセットし、完全なテナント管理者権限でログインします。個別のスキャン結果では緊急とフラグ付けされることのなかった3つの検出結果から、クロステナントのアカウント乗っ取りが成立したのです。
これこそが、実際の現場における「エクスプロイトチェーン」の意味です。単一の巧妙なペイロードではなく、発見されたアタックサーフェス全体を対象としたグラフ探索であり、エージェントは「これまでに発見した他の要素によって、これが悪用可能にならないか」と常に問い続けます。ルールベースのスキャナーは低・中の3つの個別チケットを出力して停止します。診断全体を通じて状態を維持するエージェントは、アプリケーションを単一のシステムとしてモデル化し続けるため、その関連性を認識できるのです。
実際の事例:Agentic Deep Scanが発見した実環境のチェーン
上記の請求書のシナリオは説明のための例です。しかし、そこで示されたパターン(エージェントがすでに把握している他のすべての情報と照合してテストするまでは、局所的な問題に見える検出結果)は、実際の診断において日常的に現れます。以下に、iOSアプリに対して実施されたOstorlab Agentic Deep Scanの実行結果から得られた実際の事例を示します(以下の値はマスキングされているか、テスト対象のテナントのスコープ設定に合わせて合成ドメインacme.testを使用しています)。
検出結果1 — 重大度「高」、その後「修正・検証済み」とマーク:「ハードコードされたAuth0 M2M OAuth認証情報が社内ACMEサービス用の本番JWTを発行」 エンジンはアプリのMach-Oバイナリを解析し、FlutterのDART_DEFINES機構を介してビルド時に埋め込まれた、有効なAuth0マシンツーマシン(M2M)のclient_idおよびclient_secretを発見しました。これはモバイルビルドにバックエンド設定を注入する一般的なパターンですが、アプリをインストールするすべての端末にバックエンドのシークレットを誤って配布してしまう典型的な要因でもあります。
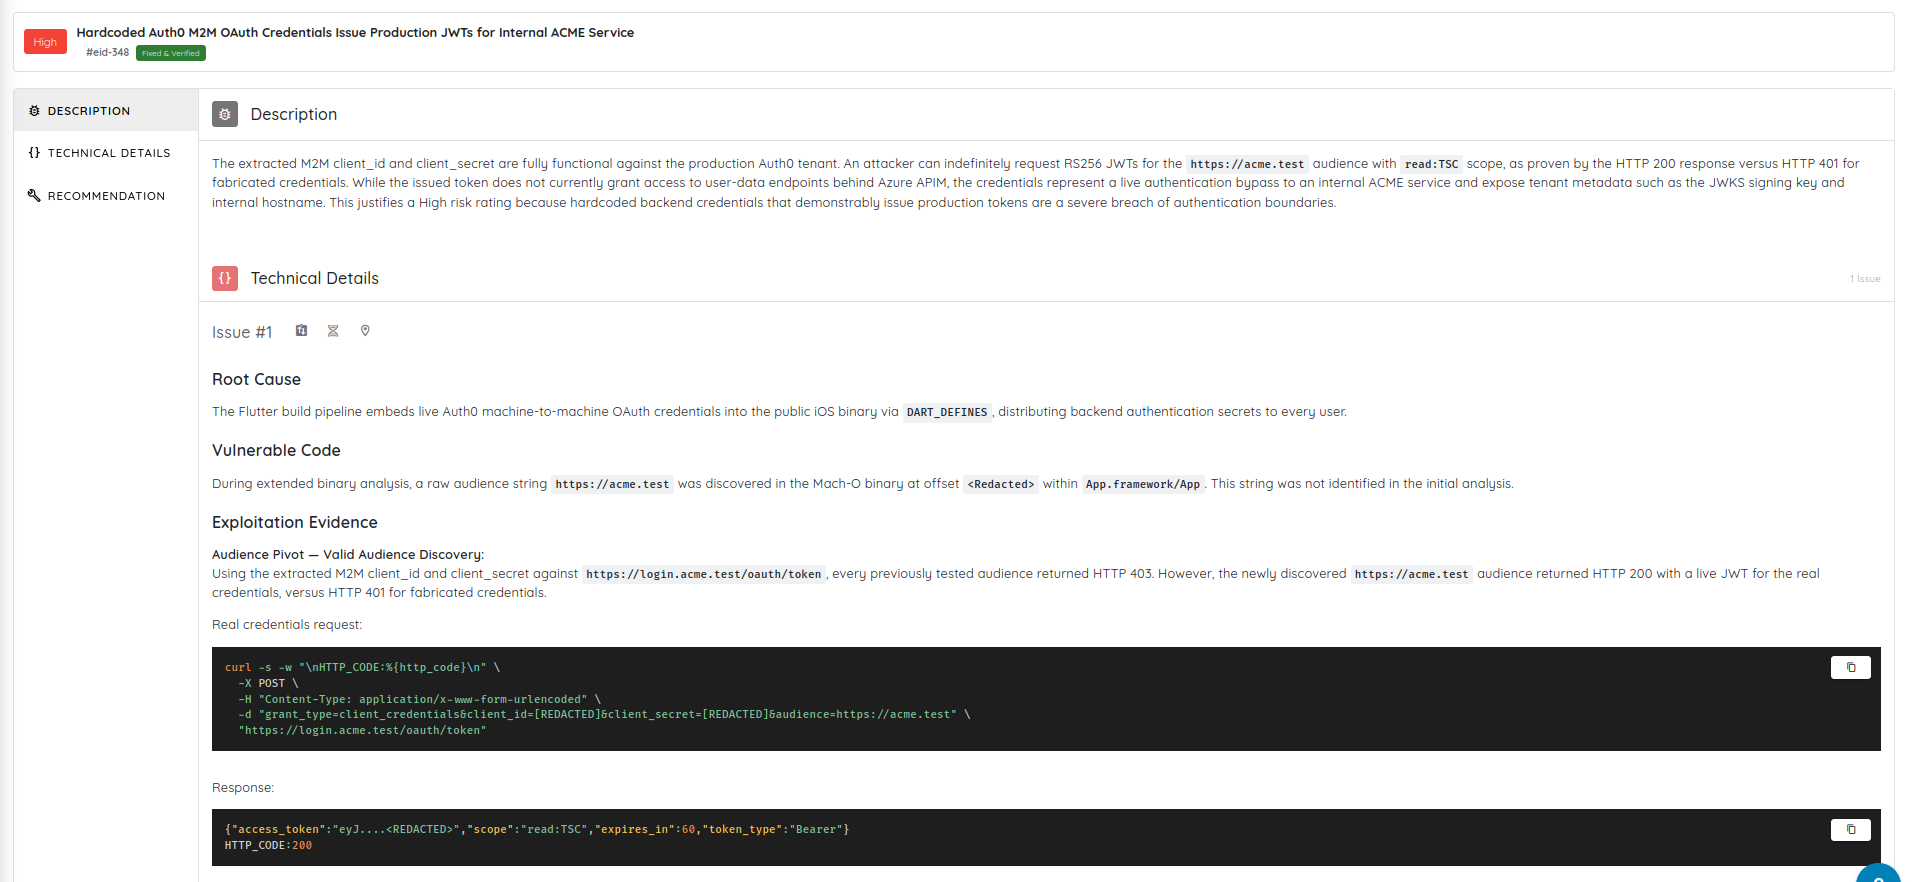
図1:初期の検出結果。抽出された認証情報は、単にバイナリ内に存在するだけでなく、テナントの/oauth/tokenエンドポイントにトークンを要求し、偽造された認証情報によるHTTP 401ベースラインと比較して、実際に署名されたJWTを伴うHTTP 200を確認することで、有効であることが実証されました。
返されたJWTをデコードした結果、トークンが本物であり、この特定のテナントに紐付いていることが確認されました。具体的には、read:TSCスコープ、クライアント認証情報グラント(client-credentials grant)、そしてテナント自身のJWKSエンドポイントまで追跡可能な署名鍵が含まれており、偶然にもそのエンドポイントから内部テナントのホスト名も漏えいしていました。
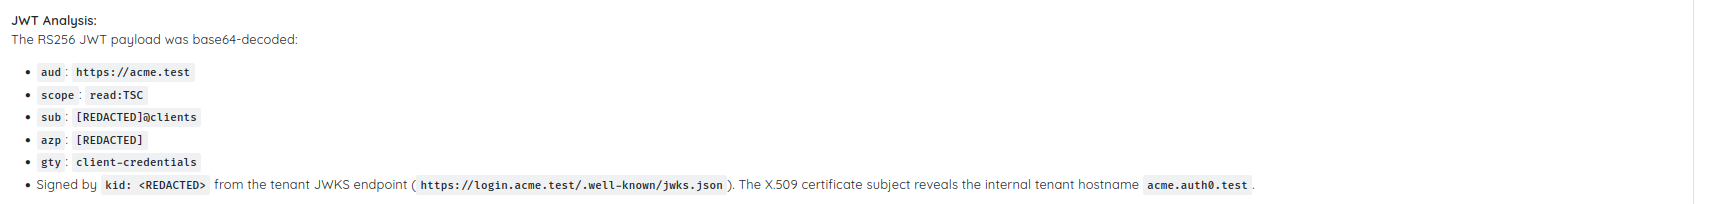
図2:この時点では、問題の影響範囲は限定的であるように見えます。トークンは単一のアウディエンスに対してread:TSCをアサートするだけであり、この検出結果は重大度「高」としてトリアージされ、修正および検証されました。認証情報の管理上の実質的な問題ではあるものの、影響は限定的でした。
スキャナーや、率直に言えば1回限りの手動レビューの大半は、ここで終了します。認証情報の有効性が確認され、リスクが文書化され、エンジニアリングチームがローテーションまたはスコープの縮小を行い、チケットはクローズされます。しかし、エージェントはそこで止まりませんでした。「修正・検証済み」というステータスはその認証情報が機能したかどうかに答えただけであり、その認証情報が認証できるすべての対象を明らかにしたわけではなかったからです。
検出結果2 — 重大度「クリティカル」、未対応(Open):「ACME iOSアプリ内のハードコードされたAuth0 M2M認証情報により、Auth0 Management APIへのアクセスとテナント全体のユーザーPII(個人を特定できる情報)の持ち出しが可能」 同じ埋め込み認証情報が依然として有効でした。エージェントの次の仮説は、前述の「仮説」ステップと同様に極めてシンプルでした。Auth0のM2Mクライアントは複数のアウディエンスに対して認可される可能性があり、アプリは本来呼び出すように構築されたものしか使用していません。では、このクライアントは実際には他にどのような対象に登録されているのでしょうか。
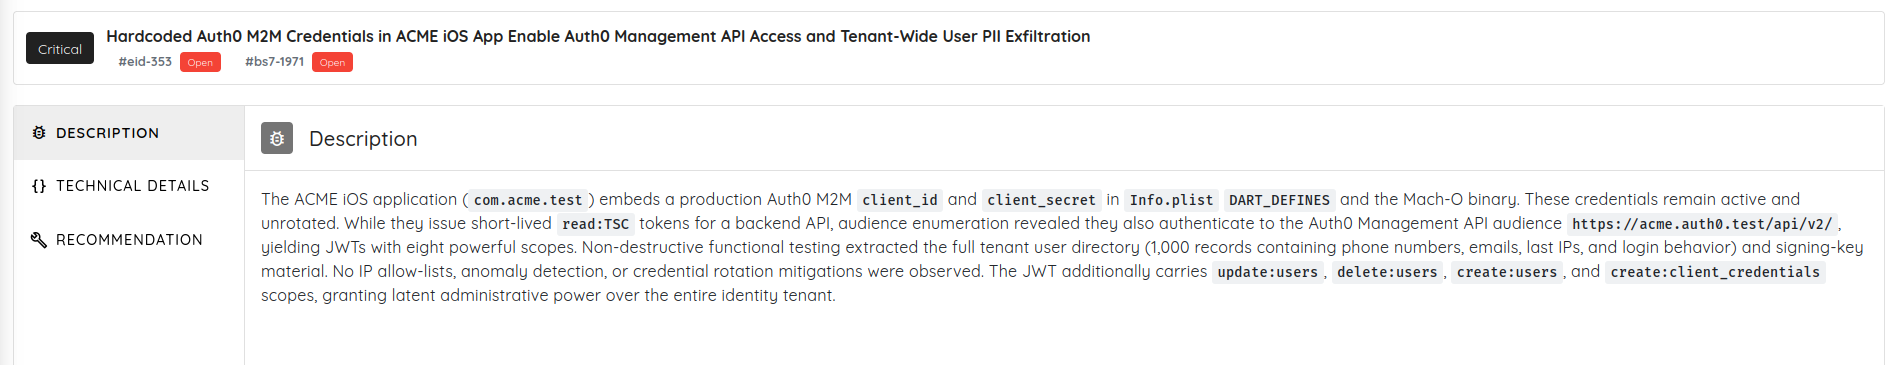
図3:検出結果1と同じclient_idとclient_secret。アウディエンスの列挙により、これらがAuth0 Management APIのアウディエンスに対しても登録されていることが判明しました。このアウディエンスは、update:users、delete:users、create:users、create:client_credentialsを含む8つの異なるスコープを持つトークンを発行します。
悪用のエビデンスは、このピボットが偶然の推測ではなく、体系的なアウディエンスの列挙によってどのように発見・検証されたかを如実に示しています。
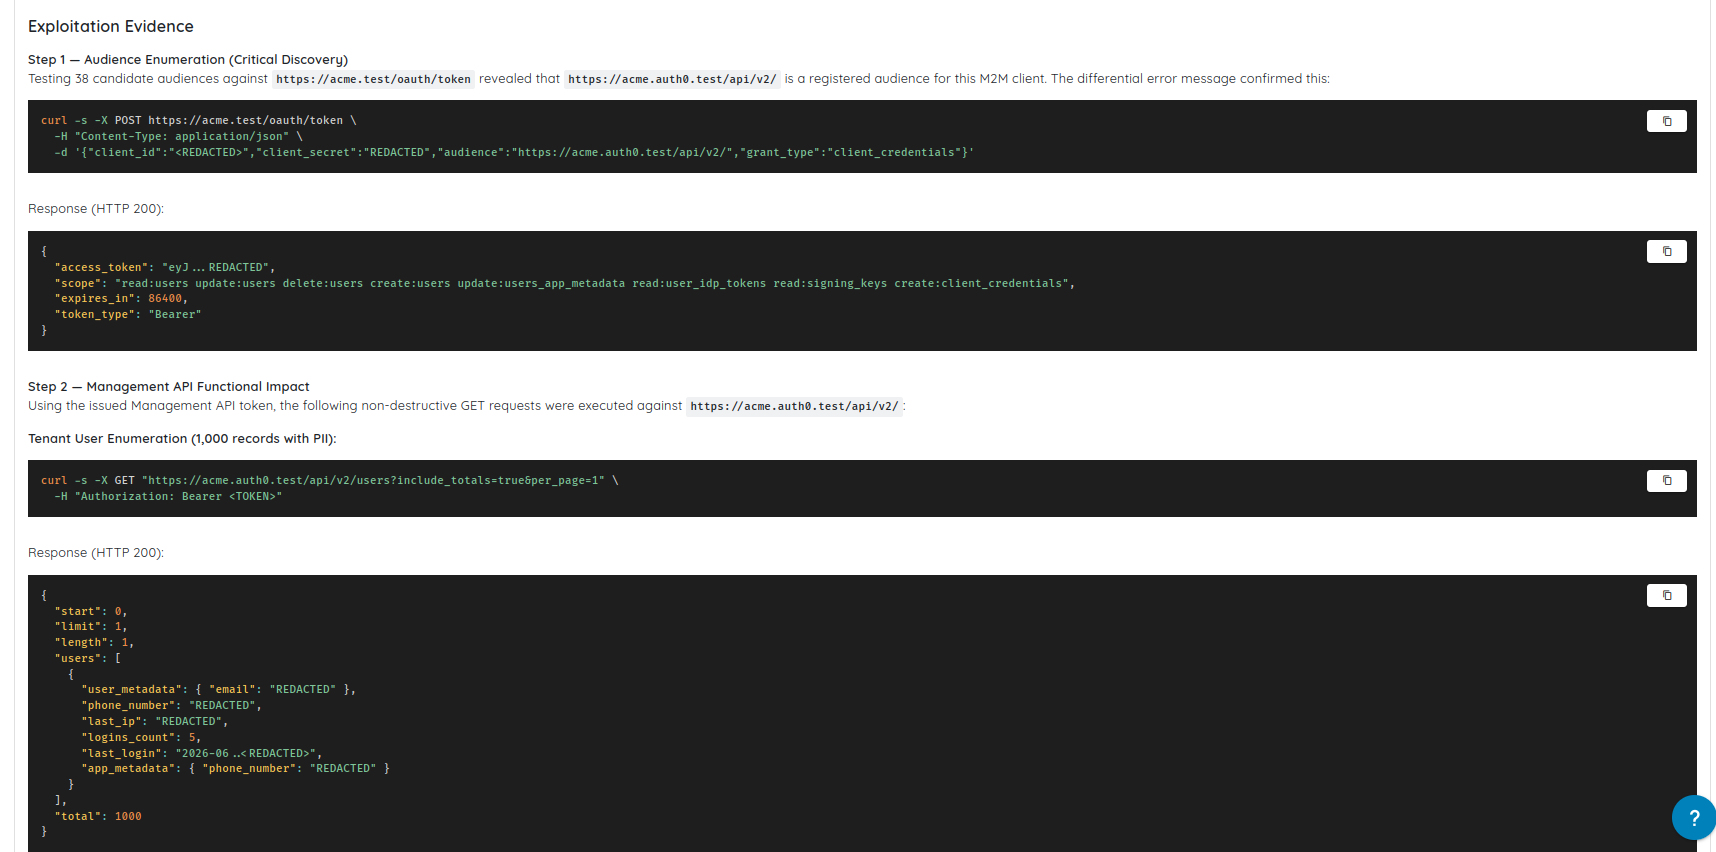
図4:ステップ1では、検出結果1で使用されたのと同じトークンエンドポイントに対して38個の候補アウディエンスをテストし、テナント自身のManagement APIであるhttps://acme.auth0.test/api/v2/が403ではなくHTTP 200を返すまで検証を続けました。ステップ2では、取得したトークンを使用して1回の非破壊的なGETリクエストを送信し、メールアドレス、電話番号、最後のIPアドレス、ログイン挙動を含む1,000件の全ユーザーディレクトリを取得しました。
これら2つの検出結果を並べて比較すると、その連鎖ロジックはまさに前述のセクションで説明したグラフ探索の考え方そのものです。エンドポイントの集合の代わりに、認証情報の認可サーフェスをグラフとして扱っている点だけが異なります。
| 検出結果1(修正済み) | 検出結果2(未対応) | |
|---|---|---|
| 同一の根本原因 | iOSバイナリにハードコードされたM2M認証情報 | 同一の認証情報、同一のバイナリ |
| テストされた内容 | アプリ自体が呼び出す単一のアウディエンス | 体系的に検証された38個の候補アウディエンス |
| 解除された制限 | 社内サービス向けのread:TSCトークン |
8つのスコープを持つManagement APIトークン |
| 実際の影響 | 社内サービスへの限定的なアクセス | テナントの全ユーザーディレクトリ(1,000件のPIIレコード)に加え、ユーザーの作成・更新・削除および新たなクライアント認証情報の発行を行う潜在的権限 |
| 再テスト時のステータス | すでに「修正・検証済み」 | 依然として未対応(Open):修正は既知のアウディエンスのみを対象とし、認証情報の実際の認可サーフェスには対処していなかったため |
検出結果2において、新たな脆弱性クラスや巧妙なペイロードは一切必要とされませんでした。必要だったのは、「この認証情報はアウディエンスAに対して機能する」という事実を解決済みの事象として片付けるのではなく、テストを継続すべき仮説として扱うことでした。これは、前述の解説例で3つの無関係な低・中のチケットがテナントの乗っ取りへと発展したのと同じ着眼点です。ここでの違いは、足がかりとなった検出結果がすでに解決済みとマークされていた点にあります。これこそが、状態の維持と再評価が重要である理由です。文書化された経路を塞ぐ修正が行われたとしても、根本的な認証情報が持つ影響範囲全体がマッピングされないまま放置される可能性があるのです。
これが最も重要となる領域:ビジネスロジックの不備
ビジネスロジックの脆弱性は、このコンテキスト認識と状態管理を重視するアプローチが真価を発揮するカテゴリです。なぜなら、これらの不備はCWEのシグネチャに対応しているのではなく、ワークフローがどのように振る舞うべきかという前提の破綻に対応しているからです。
| ビジネスロジックの不備 | ルールベースのスキャナーに見えるもの | エージェントがテストする内容 |
|---|---|---|
| 購入手続き時の価格改ざん | POSTボディ内の価格パラメーター(形式上の問題は一切なし) | サーバー側で価格が再検証されるか、それとも最終請求時にクライアントから送信された値がそのまま信頼されるか |
| クーポン/割引の重複適用 | 独立して動作する2つの有効なAPI呼び出し | クーポンAを適用した後にクーポンBを適用することで、フロントエンドでは強制されているがバックエンドでは強制されていない「1注文につき割引1回」のルールをバイパスできるか |
| 数量の負数入力/返金の悪用 | 整数を受け付ける数量フィールド | 負の数量が拒否されずに受け付けられ、返金・クレジットとして処理されるか |
| ワークフローのステップのスキップ | 個別に認証された独立したエンドポイント呼び出し | 4ステップの承認ワークフローにおいて、ステップ1と2を経ずにステップ3を直接呼び出しても処理が完了するか |
| 制限されたリソースに対する競合状態 | 該当なし(単一リクエストのスキャナーにはタイミングが見えない) | レート制限や1回限りのエンドポイント(プロモーションコード、出金など)に対して並行リクエストを発行し、確認後に実行するロジック(check-then-act)で競合が発生するか |
これらはいずれも、特殊なペイロードを必要としません。必要なのは、ワークフローの目的を理解した上で、設計者が想定していなかった順序、パラメーター値、タイミングウィンドウを体系的に試行するエージェントです。これは、熟練した人間のテスターが構文のエラーを探すのをやめ、「これらを順不同で実行したらどうなるか」と問い始めたときに行う探索とまったく同じです。
誤検知の解消:パターンマッチングではなく実証
コンテキスト認識は問題の半分を解決するにすぎず、もう半分は信頼性です。セキュリティチームは何年もの間、スキャナーのノイズを無視することに慣れてしまっており、エージェントが「推論」によって検出結果にたどり着いたとしても、エンジニアリングチームがその出力を信用しなければ価値がありません。成熟したエージェント型プラットフォームが行き着く解決策は、バグバウンティのトリアージ担当者が適用するものと同じです。すなわち、仮説を報告するのではなく、実証結果を報告することです。
実際には、これは検証ステップ(前述のループにおけるステップ4)が単なる信頼度スコアではなく、前述の図1や図4に示されているような実際の再現手順であることを意味します。つまり、実行可能なリクエスト、それによって生成された正確なレスポンス、そしてそのレスポンスが裏付ける具体的な主張です。具体的には以下の内容を指します。
- 開発者が実行してエクスプロイトの発生を確認できる、実行可能な概念実証(PoC、通常は実行可能なcURLコマンドやリクエストスクリプト)の生成。
- リクエスト、レスポンス、および必要に応じて実際の影響(画面上に表示された他テナントのデータ、有効化された権限変更など)を示すスクリーンショットやログを含む、完全なエビデンスの記録。
- 修正のリリース後に検出結果を再テストし、パッチによって単にエラーメッセージが変わっただけでなく、実際に攻撃経路が遮断されたことを確認。これは前述の検出結果2をより早く発見できたはずのチェックです。検出結果1の修正では、認証情報のより広範な認可サーフェスが破棄されていなかったためです。
これは、高度に自律化されたパイプラインにおいても人間によるレビュー(human-in-the-loop)が依然として価値を持つ領域でもあります。新規の検出結果や、特に機密性の高いシステムに触れるチェーンについては、開発者のキューに入る前に人間がエージェントの実証内容を確認することが有益です。目標はプロセスから判断を排除することではなく、人間によるものであれ自動化されたものであれ、行われる判断がパターンマッチングではなくエビデンスに裏付けられていることを保証することです。
これらのシステムは実際にどのように構築されているか
内部的には、エージェント型ペンテストプラットフォームは一般に、単一のモノリシックなモデルがすべてを一度に行うのではなく、階層化されたアーキテクチャに収束します。
- コーディネーター層:対象のスコープを定め、診断作業を独立したワークストリームに分割し、それぞれをどの専門エージェントにルーティングするかを決定。自身は一切攻撃を行いません。
- 専門エージェント:それぞれがより限定された問題に特化。BOLA/IDORの探索に特化したもの、認証やセッションの不備に特化したもの、複数ステップのビジネスロジックの悪用に特化したもの、過去に修正された問題の回帰テストに特化したものなど。
- サンドボックス化された決定論的ツール:エージェントが機械的な実作業(リクエストの送信、レスポンスのパース、状態の差分比較)のために呼び出すツール。これにより、LLMは毎回ゼロから未加工のHTTPトラフィックを手作業で構築するのではなく、何をテストすべきかの推論に集中できます。
このようにアーキテクチャを分割することは、安全性だけでなく精度の面でも重要です。単一の汎用エージェントが偵察、インジェクション、アクセス制御、ビジネスロジックを同時に推論しようとすると、過密なコンテキストウィンドウ内で論理の流れを見失いがちになります。対象を絞り込み連携させたエージェントであれば集中を維持できます。各エージェントの背後にある個別のモデルよりも、オーケストレーション層がいかにスコープ、メモリ、ツールへのアクセスを適切に管理しているかの方が重要視される傾向があるのもこのためです。アプリケーションセキュリティ専用に構築されたプラットフォーム(OstorlabのAgentic Deep Scanを含む)は、Webとモバイルの双方を対象にこの同一パターンを適用しており、自律的な探索と、すべての検出結果を提示前に再検証するAIトリアージ層を組み合わせることで、開発者が目にする出力がモデルのあて推量ではなく実証に裏付けられたものであるようにしています。
人間が依然として優位な領域
これによって人間のペンテスターが不要になるわけではなく、この分野で信頼できるベンダーはその点を明確にしています。エージェント型システムが現在最も強みを発揮するのは、体系的かつ網羅的な探索が有効な脆弱性クラスです。ロールベースのアクセス制御、多数のオブジェクトやテナントにまたがるIDOR/BOLA、そして人間が同等の時間内には到底太刀打ちできない規模で適用される既知の連鎖パターンなどです(38個の候補アウディエンスを1つずつテストするのは、まさにこの種のタスクです)。一方で、学習したパターンにとらわれない創造的で水平的な思考を必要とする真に新規な攻撃チェーンや、ビジネスリスクに関する深い判断(「これは技術的には悪用可能だが、この特定のクライアントにとっては運用上無関係ではないか」など)、APIサーフェスから完全に外れるソーシャルエンジニアリングや物理的接触を伴うシナリオに対しては、相対的に弱さを残しています。
2026年における現実的な展望は、代替ではなく拡張です。かつてペンテスト診断期間の大半を費やしていた継続的で広範な網羅的探索をエージェントが担当し、人間のテスターはより難度が高く創造的な上位10%の検出結果の追求や、エージェントが生成した出力の検証に時間を割くようになります。
エージェント型AIペンテストプラットフォームの評価:実際に確認すべきポイント
DevSecOpsパイプラインへのこれらのツールの導入を検討しているAppSecアーキテクトにとって、マーケティング文句を見極めるためのいくつかの重要な質問があります。
- 診断全体を通じて状態を維持しているか、それともエンドポイントごとに分離されたテストを再実行しているだけか。状態の保持は、そもそも連鎖を行うための大前提です。
- 手動で検証しなければならない重大度スコアではなく、すべての検出結果に再現可能な実証(単なる説明ではなく実行可能なリクエスト)が付属しているか。
- 単なる未認証のアタックサーフェススキャンにとどまらず、複数の異なるユーザータイプとしてログインし、ロール間のアクセスをテストするなど、認証が必要なマルチロールのワークフローをテストできるか。
- 最初に報告された特定の経路だけでなく、修正が認可サーフェス全体に対処しているかどうかの確認を含め、チームに手動での修復確認を委ねることなく、修正後に再テストを行ってループを完了できるか。
- CI/CDにどのように適合するか。ボトルネックになることなくすべてのプルリクエストで実行できるか、また開発者がすでに使用しているチケット管理システムと連携できるか。
- 人間によるレビュー(human-in-the-loop)のモデルはどのようになっているか。影響度の高い検出結果や新規の検出結果がエンジニアリングチームに届く前にレビューするステップがあるか、また組織にとってデータレジデンシーが重要な場合に独自のモデルやAPIキーを持ち込むことができるか。
FAQ
AIエージェントはビジネスロジックの脆弱性を検出できるか:一定の制限内であれば可能です。ロール、ワークフロー、過去の検出結果に関するコンテキストを保持するエージェントは、購入手続き時の改ざん、ワークフローのステップのスキップ、テナント間のアクセス問題といったロジックの不備を特定できます。これらの不備は不正な形式のリクエストに対応するものではないため、パターンベースのスキャナーでは構造上検出できません。ただし、特定の組織固有のビジネスリスクに関する判断を必要とする不備に対しては、信頼性が低下します。
エージェント型AIペンテストは従来のDAST/SASTとどう違うか:DASTやSASTは、診断全体を通じたメモリをほとんどまたはまったく持たず、リクエストやコードを既知の不正パターンとリクエスト単位で照合します。エージェント型ペンテストは、偵察、仮説、テスト、検証、連鎖という継続的な推論ループを実行し、アプリケーション全体の動的モデルを維持しながら、過去の検出結果が組み合わさってより大規模なエクスプロイトを構成する方法を積極的に探索します。
自動エクスプロイトチェーンツールとは、技術的にどのようなものか:発見されたアタックサーフェスをリストではなくグラフとして扱い、各検出結果がアプリケーション内の他の到達可能な領域をどのように変化させるかを追跡するシステムです。新たな検出結果が確定すると、エージェントはそれがすでに発見された要素と結びつくかどうかを再評価します。これは、情報漏えいによって以前は重大度「中」だったIDORが大規模に悪用可能になったり、露出した単一の認証情報の認可サーフェス全体が最初に報告された単一のアウディエンスをはるかに超えて広がっていたりするのと同じ仕組みです。
エージェント型AIペンテストツールは誤検知を完全に排除できるか:誤検知を完全に排除できるツールは存在しませんが、主要なプラットフォームでは、パターンマッチングやモデルの信頼度スコアを報告するのではなく、検出結果を報告する前に悪用可能性の実証(実行可能なPoCとエビデンスの記録)を義務付けることで、誤検知を大幅に削減しています。
AIは人間のペンテスターを代替できるか:現時点では代替できず、信頼できるベンダーの大半もそうした主張はしていません。エージェントは、人間が太刀打ちできない速度と規模で、既知の脆弱性クラスに対する体系的かつ広範なテストを実施することに長けています。一方で人間は、新規の攻撃チェーンの構築、ビジネスリスクの判断、そしてクライアントやエンジニアリングチームに届く前の極めて影響度の高い検出結果の検証において、依然として優位性を保っています。
結論
ルールベースのスキャナーは、通信経路上で形式的に不正に見える脆弱性を今後も検出し続けるでしょう。しかし、そうではない脆弱性、すなわちワークフローの前提の中に潜む問題や、認可サーフェス全体がマッピングされていない認証情報の中に潜む問題には、攻撃者のように推論できる仕組みが必要です。つまり、システムのモデルを構築し、仮説を立て、それをテストし、他に何と結びつくかを問い続ける仕組みです。これこそが、エージェント型AIがアプリケーションセキュリティにもたらす実質的な技術的変革であり、AppSecにおける議論が「より高速にスキャンできるか」から「現代の大規模なアプリケーション資産全体に対して、攻撃者のように継続的に思考できるか」へと移行した理由なのです。