Ruby Regexp RCEs : sept failles corrigées dans la version 4.0.10 (CVE-2026-132825)
Sept failles mémoire dans le moteur d'expressions régulières et la conversion de casse de Ruby peuvent mener à l'exécution de code. Corrigées en 4.0.10.
En bref
- Sept failles mémoire touchent le moteur d'expressions régulières et la conversion de casse de Ruby. Le projet Ruby dit avoir connaissance de preuves de concept d'exécution de code dans certains scénarios, et a publié l'avis le 2026-11-19.
- Ruby 3.3.13 et antérieur, 3.4.0 à 3.4.12 et 4.0.0 à 4.0.9 sont concernés. Les applications qui changent la casse ou compilent des motifs non fiables sont les plus exposées.
- Trois avis sont Critiques pour GitHub ; CVE-2026-132825 est notée CVSS v3.1 7,4 Élevée. Aucune exploitation en conditions réelles n'est connue, et aucune des sept n'est dans le catalogue KEV de la CISA au 2026-11-19.
- Passez à Ruby 4.0.10, 3.4.13 ou 3.3.14. Ruby 3.2 et antérieur ne recevront pas ces correctifs ; voir « Comment corriger ? » pour les commandes de mise à niveau et les mesures partielles.
Suis-je concerné ?
Vous êtes exposé lorsque toutes ces conditions sont réunies :
- Vous exécutez Ruby 3.3.13 ou antérieur, Ruby 3.4.0 à 3.4.12 ou Ruby 4.0.0 à 4.0.9.
- Votre application transmet des données influencées par un attaquant à la conversion de casse, ou construit une expression régulière à partir de données influencées par un attaquant.
- Le chemin de code concerné utilise un encodage qui déclenche la faille. Le débordement du sharp s nécessite un encodage sur un octet, comme ISO-8859-1 ou Windows-1252. Les failles du moteur de correspondance nécessitent UTF-16, UTF-32 ou Emacs-Mule.
Les failles de conversion de casse touchent aussi le code qui appelle String#upcase, String#downcase, String#capitalize, String#swapcase ou String#casecmp?. Ces méthodes sont dangereuses sur des entrées non fiables. Les failles d'expressions régulières touchent Regexp.new et les littéraux d'expression régulière construits à l'exécution. Un littéral avec un motif fixe n'est touché que si la chaîne sujet déclenche la faille du moteur de correspondance.
Ruby 3.2 et antérieur sont en fin de vie. L'avis indique qu'ils ne recevront pas ces correctifs.
| Branche | Versions concernées | Version corrigée |
|---|---|---|
| Ruby 3.3 | 3.3.0 à 3.3.13 | 3.3.14 |
| Ruby 3.4 | 3.4.0 à 3.4.12 | 3.4.13 |
| Ruby 4.0 | 4.0.0 à 4.0.9 | 4.0.10 |
| Ruby 3.2 et antérieur | Toutes les versions | Aucun correctif (fin de vie) |
Vérifiez l'interpréteur que votre application utilise réellement :
ruby -v
ruby -e 'puts RUBY_VERSION'
Pour un conteneur en cours d'exécution, vérifiez à l'intérieur du conteneur, pas dans l'image sur disque :
docker exec <container> ruby -v
Vérifiez aussi tout épinglage de version dans le répertoire de l'application :
cat .ruby-version
grep -A1 'RUBY VERSION' Gemfile.lock
Comment corriger ?
Passez à Ruby 4.0.10, 3.4.13 ou 3.3.14. Le projet Ruby a publié les trois versions le 2026-11-18 et recommande une mise à niveau immédiate.
- Avec
rbenv, installez la version corrigée et sélectionnez-la pour l'application :bash rbenv install 4.0.10 rbenv global 4.0.10 rbenv rehash - Avec RVM, installez et sélectionnez la version corrigée :
bash rvm install 4.0.10 --binary rvm use 4.0.10 --default - Avec
asdfoumise, installez la version corrigée et épinglez-la dans le projet :bash asdf install ruby 4.0.10 asdf set -u ruby 4.0.10 - Dans un conteneur, utilisez un tag d'image de base à jour et recréez le conteneur. Tirer une nouvelle image ne modifie pas un conteneur en cours d'exécution :
bash docker pull ruby:4.0.10 docker rm -f <container> docker run --name <container> ... ruby:4.0.10 - Redémarrez chaque processus Ruby après la mise à niveau. Puma, Unicorn, Sidekiq et tout worker de longue durée gardent l'ancien interpréteur en mémoire jusqu'à leur redémarrage.
- Si vous installez Ruby depuis un paquet de distribution, vérifiez si la distribution a reconstruit le paquet. Une version de paquet antérieure au 2026-11-18 ne contient pas ces correctifs.
Si vous ne pouvez pas encore mettre à niveau, réduisez l'exposition avec ces mesures partielles :
- Convertissez les chaînes non fiables en UTF-8 avant la conversion de casse. Cela évite le chemin du sharp s sur un octet, mais ne couvre ni le débordement d'entier dans
rb_str_casemapni les failles d'expressions régulières. - Ne compilez pas d'expressions régulières à partir de motifs non fiables. Utilisez un ensemble fixe de motifs et rejetez les entrées destinées à devenir un motif. Cela réduit l'exposition aux failles de compilation et de correspondance, mais ce n'est pas un correctif complet pour un service qui accepte légitimement des motifs.
- Limitez la taille des motifs et des chaînes sujets à la frontière de l'application. Cela rend le chemin du débordement de compilation plus difficile à atteindre, mais ne corrige ni le double free ni les lectures hors limites.
Aucune de ces mesures ne remplace la mise à niveau.
Quelle est la cause racine ?
Ruby implémente la conversion de casse des chaînes et son moteur d'expressions régulières en C. La conversion de casse appelle une fonction case_map propre à chaque encodage. Le moteur d'expressions régulières est Onigmo, qui analyse un motif, le compile en un programme de bytecode puis l'exécute. Les sept avis couvrent des erreurs de sécurité mémoire dans ce code. Ils incluent un débordement d'un octet dans le mappage de casse et un débordement d'entier dans la comptabilité des tampons de conversion de casse. Ils incluent aussi un double free pendant l'analyse des expressions régulières et des lectures ou écritures hors limites dans le compilateur et le moteur de correspondance.
Le débordement d'un octet se trouve dans les encodeurs sur un octet. Voici case_map dans enc/iso_8859_1.c au tag 3.4.12 :
while (*pp < end && to < to_end) {
  code = *(*pp)++;
  if (code == SHARP_s) {
    if (flags & ONIGENC_CASE_UPCASE) {
      flags |= ONIGENC_CASE_MODIFIED;
      *to++ = 'S';
      code = (flags & ONIGENC_CASE_TITLECASE) ? 's' : 'S';
    }
    else if (flags & ONIGENC_CASE_FOLD) {
      flags |= ONIGENC_CASE_MODIFIED;
      *to++ = 's';
      code = 's';
    }
  }
  /* ... */
  *to++ = code;
La condition de boucle garantit seulement qu'un octet est libre dans le tampon de sortie. Le sharp s (0xDF) se développe en deux octets, SS ou ss, et les deux branches écrivent un octet avant que le *to++ = code commun n'écrive le second. Lorsque le tampon de sortie se termine exactement au dernier caractère d'entrée, la seconde écriture dépasse le tampon d'un octet. Quatorze encodeurs avaient la même vérification : ISO-8859-1, -2, -3, -4, -9, -10, -13, -14, -15 et -16, plus Windows-1250, -1252, -1254 et -1257.
Le débordement d'entier se trouve dans rb_str_casemap dans string.c, qui dimensionne et accumule les tampons de sortie d'une conversion de casse. En 3.4.12, il stocke le total courant dans un int :
int target_length = 0;
/* ... */
size_t capa = (size_t)(source_end-source_current)*++buffer_count + CASE_MAPPING_ADDITIONAL_LENGTH;
/* ... */
target_length  += current_buffer->used = buffer_length_or_invalid;
Une chaîne source très grande fait déborder l'arithmétique d'allocation et la longueur totale. L'avis décrit le résultat comme un débordement de tampon dans le tas qui peut mener à l'exécution de code.
Le compilateur d'expressions régulières a un problème distinct de comptabilité de taille. En 3.4.12, add_opcode vérifie la taille du programme compilé avant d'écrire un opcode :
static int
add_opcode(regex_t* reg, int opcode)
{
  if (reg->used > MAX_COMPILED_PROGRAM_SIZE)
    return ONIGERR_TOO_BIG_COMPILED_PROGRAM;
  BBUF_ADD1(reg, opcode);
  return 0;
}
Les écritures en bloc ne passent pas par cette vérification. add_bytes, add_bitset et add_multi_byte_cclass écrivent directement dans le tampon du programme. add_compile_string, compile_cclass_node et compile_quantifier_node ignoraient aussi la valeur de retour de ces appels. Une longue concaténation de classes de propriétés multioctets peut donc pousser le programme au-delà de sa limite de taille. La comptabilité déborde alors avant le dernier add_opcode(OP_END). compile_length_tree additionnait séparément des longueurs dans un int, si bien qu'un grand motif pouvait rendre la somme négative et la renvoyer comme code d'erreur.
Les quatre autres failles ont des correctifs plus ciblés :
- GHSA-7x2q est un double free dans
parse_char_class. Le gestionnaire&&libèrecc->mbufmais laisse le pointeur danscc, et le chemin d'erreur le libère de nouveau. - GHSA-wpqw est une lecture hors limites dans
OP_EXACT1_ICetOP_EXACTN_IC. Le moteur de correspondance avance de la longueur du repli de casse d'un caractère sans la vérifier par rapport à l'opérande. Un repli de longueur différente lui fait exécuter les octets suivants du motif comme des instructions. - GHSA-7whj est un débordement de tampon dans
Regexp#to_s. Il compilait la source brute à l'intérieur de(?opts:...), alors queRegexp.newcompile la source prétraitée. Un commentaire(?#...)dans une classe de caractères peut donc signifier un motif différent et produire une écriture hors limites. - GHSA-pvgc est une lecture hors limites dans
string_cmp_ic. La comparaison de référence arrière insensible à la casse replie le caractère à la fin du sujet sans vérifier que le pointeur de sujet est toujours à l'intérieur du sujet.
Les sept avis, leurs notes et leurs commits de correction sont :
| Avis | Classe de faille | Note | Commit de correction principal |
|---|---|---|---|
| GHSA-34m4-m9fh-gqp5 | Débordement de tampon dans la conversion de casse | Critique | b841d6f4f1 |
| GHSA-7x2q-68qv-6p8x | Double free dans la compilation d'expression régulière | Critique | 28aad344e1 |
| GHSA-3p8q-wmhx-vm2w | Débordement de tampon dans la compilation d'expression régulière | Critique | 6c6e6c9273, 57c24699fe, 65b71a8844 |
| GHSA-87fm-7w84-j2px | Débordement d'entier dans la conversion de casse | Élevée | f2e5063748 |
| GHSA-wpqw-5qxg-m68r | Lecture hors limites dans la correspondance insensible à la casse | Élevée | e12e722695 |
| GHSA-7whj-cfh7-xgm4 | Débordement de tampon dans Regexp#to_s |
Élevée | cdd499eccd |
| GHSA-pvgc-g7gj-pv6h | Lecture hors limites dans la correspondance de référence arrière | Modérée | b469749b37 |
Comment la faille est-elle exploitée ?
- L'attaquant fournit une chaîne conçue à un appel de conversion de casse, ou un motif ou un sujet conçu au moteur d'expressions régulières. L'application doit transmettre ces données à Ruby sans remplacer l'encodage ni rejeter le motif.
- Pour le débordement du sharp s, l'attaquant choisit un encodage sur un octet concerné. Il place des octets 0xDF de sorte que le tampon de sortie se termine sur une expansion de deux octets. L'écriture suivante dépasse l'allocation d'un octet.
- Pour le débordement d'entier, l'attaquant fournit une chaîne très grande. La taille du tampon et le total courant débordent, et l'écriture de conversion de casse dépasse l'allocation.
- Pour le compilateur d'expressions régulières, l'attaquant fournit un grand motif construit à partir de classes multioctets ou de longues chaînes exactes. Le programme compilé dépasse la limite de taille, la comptabilité déborde, et une écriture ultérieure dépasse le tampon du programme.
- Un motif ou un sujet malformé pousse l'analyseur ou le moteur de correspondance dans un chemin d'erreur. Ce chemin libère deux fois le même tampon ou lit au-delà de l'opérande ou du sujet.
- Le façonnage du tas transforme la corruption en écriture contrôlée ou en fuite de pointeur. Le projet Ruby indique avoir connaissance de preuves de concept qui mènent à l'exécution de code dans certains scénarios, mais il n'a pas publié ce code.
Le déclencheur diffère selon la faille. Le débordement du sharp s nécessite l'encodage concerné et une chaîne dont la conversion de casse se développe à la frontière du tampon. Le débordement du compilateur nécessite un motif assez grand pour dépasser la limite. Les lectures du moteur de correspondance nécessitent un repli de casse qui change de longueur, ce qui est plus facile en UTF-16 et UTF-32. Une application qui ne traite que de l'UTF-8 et des motifs fixes est exposée à moins de failles sur les sept.
Comment se déroule l'attaque ?
Une chaîne ou un motif conçu atteint une routine C qui fait confiance à son propre calcul de longueur. La mémoire est corrompue et l'attaque peut se transformer en exécution de code dans le processus Ruby.
Que peut faire un attaquant ?
Une exploitation réussie exécute du code avec l'utilisateur qui fait tourner le processus Ruby. Cet utilisateur peut lire les variables d'environnement et les fichiers accessibles à l'application, modifier les données que l'application peut écrire et utiliser les identifiants de l'application pour atteindre d'autres systèmes.
Toutes les conditions doivent être réunies :
- L'application exécute une version de Ruby concernée.
- L'application transmet des données influencées par un attaquant à la conversion de casse ou à
Regexp.new. - Les données atteignent l'encodage et le chemin de code précis dont la faille choisie a besoin.
- L'attaquant peut façonner le tas assez pour transformer l'erreur mémoire en exécution de code.
L'avis de Ruby indique que les preuves de concept mènent à l'exécution de code « dans certains scénarios ». Il ne revendique pas d'exploit universel. L'enregistrement CVE du débordement de conversion de casse le note CVSS v3.1 7,4 avec un vecteur AV:L et une complexité d'attaque élevée. Considérez donc l'exploitation à distance comme dépendante de l'application. Un service qui change la casse de données de requête en ISO-8859-1 ou Windows-1252 est un chemin distant plausible, mais les sources n'en démontrent pas.
Pourquoi le correctif fonctionne-t-il ?
Le correctif de mappage de casse change la condition de boucle dans les quatorze encodeurs sur un octet. La boucle ne tourne désormais que tant qu'au moins deux octets sont libres. Voici le changement de b841d6f4f1 :
-  while (*pp < end && to < to_end) {
+  while (*pp < end && to_end - to > 1) {
     code = *(*pp)++;
La branche du sharp s peut désormais écrire ses deux octets. Le correctif ajoute aussi un test de régression qui exécute upcase, downcase(:fold), swapcase, capitalize et casecmp? sur des chaînes répétées de 0xDF dans chaque encodage concerné.
Le correctif de comptabilité de casse change target_length en long. Il rejette une source plus grande que INT_MAX - CASE_MAPPING_ADDITIONAL_LENGTH et calcule la capacité du tampon avec une vérification de débordement. Il lève ArgumentError au lieu de laisser un débordement. Il se trouve dans f2e5063748.
Le correctif du compilateur ajoute check_compiled_program_size() et l'appelle avant chaque écriture en bloc, pas seulement avant un opcode. Il propage aussi les codes de retour dans les fonctions qui les ignoraient. Voici le cœur de 6c6e6c9273 :
+static int
+check_compiled_program_size(regex_t* reg, OnigDistance add_len)
+{
+  if (reg->used > MAX_COMPILED_PROGRAM_SIZE ||
+      add_len > (OnigDistance )(MAX_COMPILED_PROGRAM_SIZE - reg->used))
+    return ONIGERR_TOO_BIG_COMPILED_PROGRAM;
+  return 0;
+}
57c24699fe passe l'arithmétique de taille de BBuf à size_t et la plafonne à ONIG_MAX_BBUF_SIZE. Les macros de tampon ne peuvent donc plus déborder non plus. 65b71a8844 ajoute la vérification de limite à compile_length_tree pour que la passe de longueur ne déborde pas avant le début de la compilation.
Les quatre correctifs plus petits sont ciblés. Le correctif du double free met cc->mbuf = NULL après la libération. Le correctif de correspondance exacte vérifie la longueur du repli par rapport à l'opérande. Le correctif de Regexp#to_s prétraite la source avant de compiler le groupe. Le correctif de référence arrière s'arrête lorsque le pointeur de sujet atteint la fin. Ensemble, ils ferment les sept chemins signalés. La même version contient aussi d'autres commits de renforcement des expressions régulières. Ils ne font pas partie des sept avis et traitent plus strictement les échappements d'octets, les commentaires, les replis Emacs-Mule et les points de code surrogate. Ces changements relèvent de la défense en profondeur.
Comment vérifier si j'ai été compromis ?
Le projet Ruby n'a publié aucun indicateur de compromission pour ces failles. Il signale des preuves de concept mais aucune exploitation en conditions réelles, et le catalogue KEV de la CISA ne liste aucune des sept au 2026-11-19. Les sources ne fournissent aucun chemin de fichier, domaine ou signature de requête fiable à rechercher.
Ces vérifications peuvent toutefois révéler un plantage ou un motif inhabituel :
# Ruby crashes recorded by the kernel
dmesg | grep -i -E 'ruby|segfault'
journalctl -k --since '30 days ago' | grep -i -E 'ruby|segfault'
# Very large regexp patterns or case-conversion inputs in application logs
grep -R -i -E 'RegexpError|too big compiled program|string size too big' /var/log/<app>/
Un plantage dans un worker Ruby est une piste, pas une preuve. Une tentative qui échoue proprement peut ne laisser aucune trace. Si vous trouvez un plantage qui correspond à l'un de ces chemins de code, conservez l'image du processus et l'entrée avant de redémarrer le service.
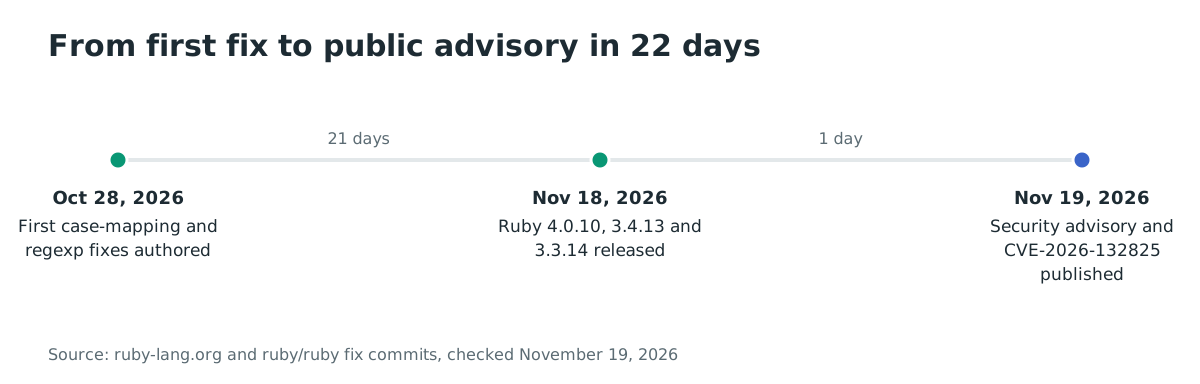
Chronologie
- 2026-10-28 : les premiers commits de correction des failles de mappage de casse et de sécurité mémoire des expressions régulières sont écrits.
- 2026-11-18 : Ruby 4.0.10, 3.4.13 et 3.3.14 sont publiés.
- 2026-11-19 00:00 UTC : l'avis de sécurité Ruby est publié.
- 2026-11-19 06:34 UTC : CVE-2026-132825 est publiée pour le débordement de conversion de casse.
- Aucune exploitation en conditions réelles n'a été signalée.
Le premier correctif du débordement de mappage de casse a été écrit le 2026-10-28, et l'avis public a suivi 22 jours plus tard.
FAQ
Mon application est-elle concernée si elle n'utilise que de l'UTF-8 ? Elle peut encore être concernée par les failles d'expressions régulières. Le débordement du sharp s nécessite un encodage sur un octet, mais le débordement du compilateur, le double free et les lectures insensibles à la casse non. Vérifiez d'abord la version, puis les chemins de code.
La faille est-elle exploitable à distance ?
Cela dépend de l'application. La CVE de conversion de casse est notée AV:L avec une complexité élevée. L'avis de Ruby indique toutefois que ses preuves de concept mènent à l'exécution de code dans certains scénarios. Un service réseau qui transmet des données d'attaquant aux méthodes concernées est le chemin distant réaliste.
Existe-t-il un exploit public ? Aucun code d'exploitation fonctionnel n'est public. Le projet Ruby indique avoir connaissance de preuves de concept qui prouvent l'exécution de code dans certains scénarios, et il ne les a pas publiées.
La mise à niveau de Ruby exige-t-elle de reconstruire mes gems natives ? Non. Les correctifs sont dans l'interpréteur Ruby et son moteur d'expressions régulières intégré. Réinstaller l'interpréteur suffit. Redémarrez ensuite l'application et les processus d'extensions natives.
Ruby 3.2 est-il corrigé ? Non. Ruby 3.2 et antérieur sont en fin de vie et ne recevront pas ces correctifs. Passez à une branche prise en charge.
La faille a-t-elle été exploitée en conditions réelles ? Aucune exploitation n'a été signalée. Aucun des sept avis n'est dans le catalogue KEV de la CISA au 2026-11-19.
Trouver les runtimes Ruby avec Ostorlab
L'analyse de composition logicielle d'Ostorlab inventorie les runtimes, les images de base et les gems que vos applications embarquent. Vous pouvez ainsi trouver les versions de Ruby et les dépendances qui ont besoin de cette mise à jour. Découvrez comment fonctionnent Ostorlab SCA et SBOM.
Références
- Avis de sécurité Ruby, « Security advisories: multiple vulnerabilities in Regexp and String case conversion » (2026-11-19). https://www.ruby-lang.org/en/news/2026/11/18/multiple-vulnerabilities-in-regexp-and-string/ (vérifié le 2026-11-19)
- Avis GitHub GHSA-34m4-m9fh-gqp5, « Heap buffer overflow in case conversion of strings ». https://github.com/ruby/ruby/security/advisories/GHSA-34m4-m9fh-gqp5 (vérifié le 2026-11-19)
- Avis GitHub GHSA-7x2q-68qv-6p8x, « Double free in regular expression compilation ». https://github.com/ruby/ruby/security/advisories/GHSA-7x2q-68qv-6p8x (vérifié le 2026-11-19)
- Avis GitHub GHSA-87fm-7w84-j2px, « Integer overflow in case conversion of strings ». https://github.com/ruby/ruby/security/advisories/GHSA-87fm-7w84-j2px (vérifié le 2026-11-19)
- Avis GitHub GHSA-wpqw-5qxg-m68r, « Out-of-bounds read in case-insensitive regular expression matching ». https://github.com/ruby/ruby/security/advisories/GHSA-wpqw-5qxg-m68r (vérifié le 2026-11-19)
- Avis GitHub GHSA-3p8q-wmhx-vm2w, « Heap buffer overflow in regular expression compilation ». https://github.com/ruby/ruby/security/advisories/GHSA-3p8q-wmhx-vm2w (vérifié le 2026-11-19)
- Avis GitHub GHSA-7whj-cfh7-xgm4, « Heap buffer overflow in Regexp#to_s ». https://github.com/ruby/ruby/security/advisories/GHSA-7whj-cfh7-xgm4 (vérifié le 2026-11-19)
- Avis GitHub GHSA-pvgc-g7gj-pv6h, « Out-of-bounds read in case-insensitive backreference matching ». https://github.com/ruby/ruby/security/advisories/GHSA-pvgc-g7gj-pv6h (vérifié le 2026-11-19)
- Enregistrement CVE CVE-2026-132825. https://www.cve.org/CVERecord?id=CVE-2026-132825 (vérifié le 2026-11-19)
- Annonce de Ruby 4.0.10. https://www.ruby-lang.org/en/news/2026/11/18/ruby-4-0-10-released/ (vérifié le 2026-11-19)
- Annonce de Ruby 3.4.13. https://www.ruby-lang.org/en/news/2026/11/18/ruby-3-4-13-released/ (vérifié le 2026-11-19)
- Annonce de Ruby 3.3.14. https://www.ruby-lang.org/en/news/2026/11/18/ruby-3-3-14-released/ (vérifié le 2026-11-19)
- Commit de correction b841d6f4f1, « Fix a heap buffer overflow in case mapping of the sharp s ». https://github.com/ruby/ruby/commit/b841d6f4f1b442ac9cc8de590b43f9e4ba6d3603 (vérifié le 2026-11-19)
- Commit de correction f2e5063748, « Check the lengths in rb_str_casemap ». https://github.com/ruby/ruby/commit/f2e5063748b9b2c9dc93733b9989f9fce03abcf2 (vérifié le 2026-11-19)
- Commit de correction 28aad344e1, « Fix a double free in the && handler of parse_char_class ». https://github.com/ruby/ruby/commit/28aad344e14f288cdb0fea452a2570e9efc1c923 (vérifié le 2026-11-19)
- Commit de correction e12e722695, « Fix an out-of-bounds read in the case-insensitive exact match ». https://github.com/ruby/ruby/commit/e12e722695e017a67078cb52c37658e886e1f710 (vérifié le 2026-11-19)
- Commit de correction 6c6e6c9273, « Bound compiled program writes against size accounting ». https://github.com/ruby/ruby/commit/6c6e6c9273cec3ba8679dbb825a7c10fa9b36bfe (vérifié le 2026-11-19)
- Commit de correction 57c24699fe, « Harden BBuf size arithmetic against 32-bit overflow ». https://github.com/ruby/ruby/commit/57c24699fe45ef74052b277ffdc2f366a21d6395 (vérifié le 2026-11-19)
- Commit de correction 65b71a8844, « Check the compiled program size while computing the length ». https://github.com/ruby/ruby/commit/65b71a8844e09f23c7177f3ba64dae055785f165 (vérifié le 2026-11-19)
- Commit de correction cdd499eccd, « Preprocess the source before Regexp#to_s checks it with Onigmo ». https://github.com/ruby/ruby/commit/cdd499eccd1a8ec60021e5f7cec02a22d4c0b790 (vérifié le 2026-11-19)
- Commit de correction b469749b37, « Check the end of the subject in string_cmp_ic ». https://github.com/ruby/ruby/commit/b469749b37d57d2cb293918a895c5bec562d7eb2 (vérifié le 2026-11-19)
- Docker Hub, image officielle
ruby, 1 595 151 215 téléchargements. https://hub.docker.com/_/ruby (vérifié le 2026-11-19) - RubyGems, gem
rails, 818 979 335 téléchargements. https://rubygems.org/gems/rails (vérifié le 2026-11-19) - Catalogue des vulnérabilités exploitées connues de la CISA. https://www.cisa.gov/sites/default/files/feeds/known_exploited_vulnerabilities.json (vérifié le 2026-11-19)