La vie d'un scan : comment fonctionne le scanner de vulnérabilités open source d'OXO
Cet article explique le fonctionnement interne d'OXO.
OXO est open source depuis un certain temps et cet article se propose de détailler son fonctionnement interne. Nous examinerons la vie d'un scan, ainsi que les agents : ce qu'ils sont et quel est leur rôle lors de l'exécution d'un scan.
Création d'un scan
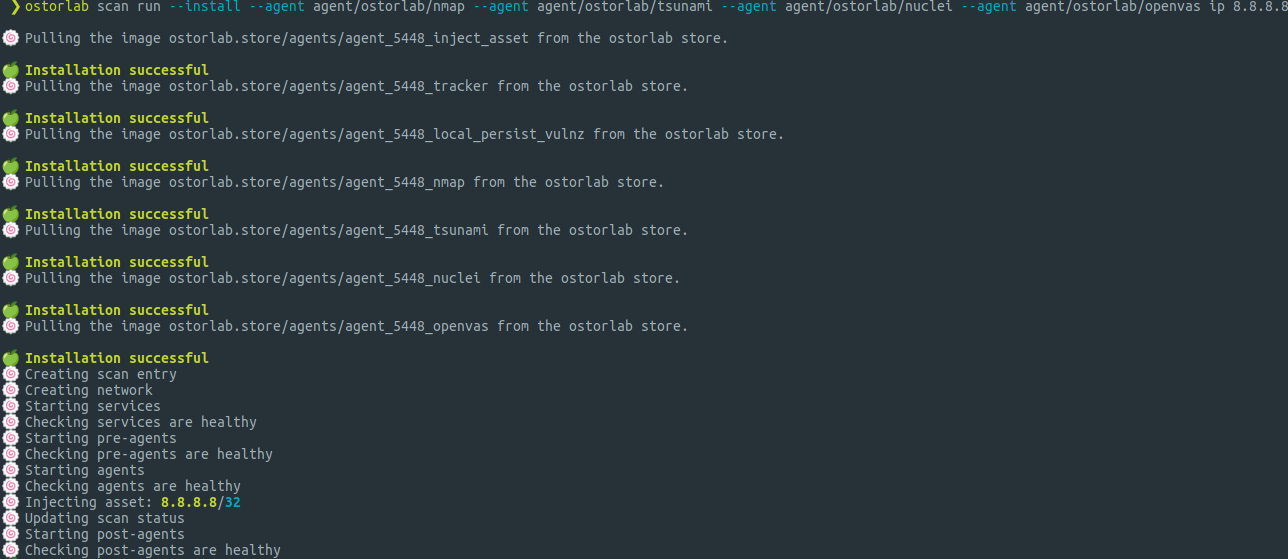
Pour les besoins de cet article, nous allons lancer un scan sur l'IP 8.8.8.8 avec les agents Nmap, Tsunami, OpenVas et Nuclei, et observer sa vie jusqu'à son achèvement. Si c'est la première fois que vous créez un scan, consultez cet article : https://oxo.ostorlab.co/tutorials. Pour lancer ce scan, vous aurez besoin de la commande suivante :
oxo scan run --install --agent agent/ostorlab/nmap --agent agent/ostorlab/tsunami --agent agent/ostorlab/nuclei --agent agent/ostorlab/openvas ip 8.8.8.8
Pour une explication détaillée de la commande de scan ci-dessus, consultez ce tutoriel.
Commençons par examiner quelques concepts importants avant de voir comment un scan est réellement exécuté de bout en bout.
Agents et groupes d'agents
OXO s'appuie sur des agents pour effectuer le scan proprement dit, et ces agents sont au cœur des capacités de détection d'oxo. Un agent possède un fichier YAML de définition d'agent. Ce fichier pointe vers le fichier docker, qui peut se trouver n'importe où dans le dépôt. Il définit un ensemble d'attributs propres à l'agent, comme le chemin du fichier docker, les arguments qu'il accepte, et ses sélecteurs d'entrée et de sortie. Les sélecteurs expriment le type de messages que l'agent attend ou qui l'intéressent. Un agent écoute les messages qui arrivent par ses sélecteurs d'entrée et peut émettre des messages par ses sélecteurs de sortie.
Les agents peuvent accomplir des tâches variées, du scan de sécurité à l'analyse de fichiers en passant par l'énumération de sous-domaines, et sont capables de communiquer avec les autres.
Le schéma d'un fichier de définition d'agent est spécifié dans le fichier agent_schema.json, qui contient une description complète du fichier de définition. Les attributs obligatoires de tout fichier de définition sont name, kind (Agent ou AgentGroup), in_selectors et out_selectors.
L'un des défis du packaging d'applications avec docker est la taille de l'image obtenue. Auparavant, il fallait deux fichiers docker, l'un pour le développement et l'autre pour la production. Pour résoudre ce problème, OXO propose le builder pattern afin d'optimiser les images des agents. Cela garantit une image plus petite et supprime la nécessité de maintenir deux fichiers docker.
Le fichier principal de l'agent, ici nmap_agent.py, est le point d'entrée.
Exemple de fichier Dockerfile pour l'Nmap Agent
FROM python:3.8-alpine as base
FROM base as builder
RUN apk add build-base
RUN mkdir /install
WORKDIR /install
COPY requirement.txt /requirement.txt
RUN pip install --prefix=/install -r /requirement.txt
FROM base
RUN apk update && apk add nmap && apk add nmap-scripts
COPY --from=builder /install /usr/local
RUN mkdir -p /app/agent
ENV PYTHONPATH=/app
COPY agent /app/agent
COPY ostorlab.yaml /app/agent/ostorlab.yaml
WORKDIR /app
CMD ["python3", "/app/agent/nmap_agent.py"]
Structure d'un agent
Tous les agents doivent hériter de la classe Agent pour accéder à diverses fonctionnalités : sérialisation automatique des messages, réception et envoi de messages, enregistrement des sélecteurs, contrôle de santé de l'agent, etc. Il est à noter qu'un agent peut être soit un processeur de messages, soit autonome. Les agents autonomes peuvent être de longue durée ou à exécution unique.
Un agent qui traite un message doit implémenter la méthode process et déclarer un ensemble de sélecteurs d'écoute. Les sélecteurs sont définis dans le fichier YAML de définition de l'agent.
Les agents autonomes n'ont aucun sélecteur à écouter et doivent implémenter leur logique dans la méthode start. Les cas d'usage incluent les injecteurs d'entrées, comme l'injecteur d'actifs ou les injecteurs de configuration. Ils incluent aussi les processus de longue durée, comme un proxy.
Les agents peuvent éventuellement définir une méthode personnalisée de contrôle de santé is_healthy pour informer l'environnement d'exécution que l'agent est opérationnel et garantir que l'actif du scan n'est pas injecté avant que l'agent ait terminé sa configuration.
Un agent qui souhaite persister des données doit hériter de AgentPersistMixin, qui implémente la logique de persistance des données. Le mixin permet un stockage distribué pour un groupe de réplicas d'agent ou pour un agent unique ayant besoin d'un stockage fiable.
Les agents peuvent également hériter, de façon facultative, de AgentReportVulnMixin, qui implémente la logique de récupération des entrées de la base de connaissances et d'émission des messages de vulnérabilité.
Pour une explication détaillée de l'implémentation d'un agent, consultez ce tutoriel.
Exemple de fichier de définition d'agent pour l'Nmap Agent. Les attributs définis dans ce fichier sont propres à chaque agent.
kind: Agent
name: nmap
version: 0.4.0
image: images/logo.png
description: |
Agent responsible for network discovery and security auditing using Nmap.
license: Apache-2.0
source: https://github.com/Ostorlab/agent_nmap
in_selectors:
 - v3.asset.ip.v4
 - v3.asset.ip.v6
 - v3.asset.domain_name
 - v3.asset.link
out_selectors:
 - v3.asset.ip.v4.port.service
 - v3.asset.ip.v6.port.service
 - v3.asset.domain_name.service-
 - v3.report.vulnerability
docker_file_path : Dockerfile
docker_build_root : .
args:
 - name: "ports"
   type: "string"
   description: "List of ports to scan."
   value: "0-65535"
 - name: "timing_template"
   type: "string"
   description: "Template of timing settings (T0, T1, ... T5)."
   value: "T4"
- kind : peut valoir
Agentpour un agent unique ouAgentGroupsi l'on souhaite prendre en charge plusieurs agents. - name : le nom de l'agent. Il doit être en minuscules et ne contenir que des caractères alphanumériques.
- version : doit respecter la convention de versionnement sémantique.
- image : le chemin de l'image ou du logo de l'agent.
- description : la description de l'agent.
- source : le dépôt source de l'agent.
- in_selectors : les sélecteurs par lesquels l'agent écoutera les messages entrants.
- out_selectors : les sélecteurs par lesquels l'agent émettra des messages en retour.
- args : les arguments que nous voulons transmettre à notre agent, ici
ports, la liste des ports à scanner. - docker_file_path : le chemin du dockerfile qui assemblera l'image docker de l'agent.
- docker_build_root : le répertoire de build docker pour le build de release automatisé.
Mixins d'agent pris en charge
-
AgentHealthcheckMixin: le mixin de contrôle de santé de l'agent garantit que les agents sont opérationnels. Il exécute un service web (par défaut sur 0.0.0.0:5000) qui doit renvoyer le statut 200 et OK en réponse. Le mixin permet d'ajouter plusieurs callbacks de contrôle de santé qui doivent tous renvoyer True. Le statut est vérifié via l'endpointhttp://0.0.0.0:5000/statuset renvoie OK si tout va bien, et NOK si l'un des contrôles échoue.Comme le contrôle peut échouer de différentes manières, par exemple si un callback de contrôle lève une exception, le service web ne les intercepte volontairement pas, afin de faciliter la détection et le débogage. Le contrôle de santé doit vérifier la présence de OK et non l'absence de NOK.
Utilisation typique :
status_agent = agent_healthcheck_mixin.AgentHealthcheckMixin()
status_agent.add_healthcheck(self._is_healthy)
status_agent.start()
-
AgentReportVulnMixin: ce mixin implémente la logique de récupération des entrées de la base de connaissances et d'émission des messages de vulnérabilité. -
AgentPersistMixin: ce mixin implémente la logique de persistance des données. Il permet un stockage distribué pour un groupe de réplicas d'agent ou pour un agent unique ayant besoin d'un stockage fiable. Un cas d'usage typique consiste à garantir qu'une valeur de message n'est traitée qu'une seule fois lorsque plusieurs autres agents produisent des doublons ou des messages similaires.
Utilisation typique :
status_agent = agent_persist_mixin.AgentPersistMixin(agent_settings)
status_agent.set_add('crawler_agent_asset_dna', dna)
is_new =  not status_agent.set_is_member()
Messages
Tous les agents communiquent par messages. Un message peut contenir des informations comme une adresse IP, un blob de fichier ou une liste de sous-domaines. Les messages sont automatiquement sérialisés en fonction du sélecteur, ce qui facilite leur transmission et leur envoi. Le format suit ces règles :
-
Les messages sont sérialisés au format protobuf. Protobuf est un format d'échange de données utilisé pour sérialiser des données structurées. Il est utilisé car c'est un format de sérialisation binaire compact qui prend en charge les types bytes sans encodage intermédiaire (coûteux).
-
Les messages suivent une hiérarchie dans laquelle les champs d'un sélecteur enfant doivent contenir tous les champs du message parent. Cela s'applique aux messages entrants comme sortants. Par exemple, si le message du sélecteur
/foo/bora la définition :
{
   color: str
   size: int
}
Le message de sélecteur /foo/bar/baz doit avoir les champs color et size, par exemple :
{
   color: str
   size: int
   weight: int
}
Les champs attendus dans un message donné, leurs types et le caractère obligatoire ou non de ces champs sont spécifiés avec protobuf. Un schéma pour un usage particulier des protocol buffers associe des types de données à des noms de champs, en utilisant des entiers pour identifier chaque champ.
Exemple de fichier protobuf pour le sélecteur de sortie v3.asset.ip.v4.port de Nmap
syntax = "proto2";

package v3.asset.ip.v4.port;

message Message {
 optional string host = 1;
 optional string mask = 2;
 optional int32 version = 3 [default = 4];
 optional uint32 port = 5;
 optional string protocol = 6;
 optional string state = 7;
}
Tous les protos sont définis dans ostorlab > agent > message > proto > v3. Chaque dossier de v3 porte le nom de son sélecteur. Par exemple, le dossier asset contient tous les protos des sélecteurs qui commencent par v3.asset*.
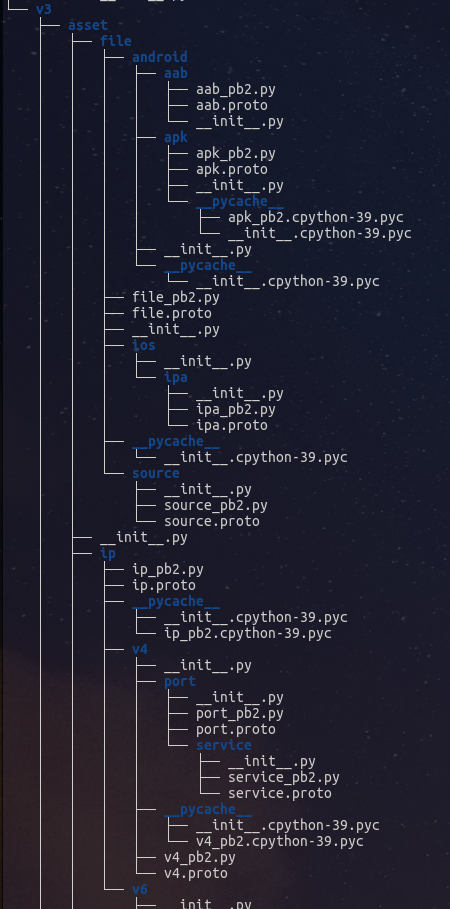
Structure de la classe de données Message
La classe de données message se charge de la sérialisation et de la désérialisation des données en fonction du sélecteur source ou destination. Cette classe de données possède deux méthodes, from_data et from_raw. Ces méthodes permettent d'éviter de manipuler directement les messages protobuf et l'API protobuf, peu conviviale.
-
from_data: génère un message à partir de données structurées et du sélecteur de destination (le sélecteur cible utilisé pour définir le format du message) et renvoie un message avec les définitions brute et de données. Le sélecteur transmis à cette méthode doit spécifier la version utilisée. -
from_raw: génère un message à partir de données brutes (des données brutes à désérialiser vers une structure de données pythonique) et du sélecteur source, et renvoie un message avec les définitions brute et de données. Le sélecteur doit spécifier la version utilisée.
Passage à l'échelle
Les agents prennent en charge l'exécution de plusieurs réplicas, de façon dynamique. Le SDK d'agent fournit les outils pour implémenter les fonctionnalités multi-instances, comme le verrouillage distribué, le stockage distribué et la répartition de charge des messages.
Les agents peuvent être mis à l'échelle dynamiquement en recherchant le nom du service docker et en exécutant la commande :
docker service scale <service_name>=<replicas_count>
Il est également possible de définir directement le nombre initial de réplicas lors de l'exécution d'un scan, dans le fichier YAML de définition du groupe d'agents.
Le runtime local
OXO prend en charge plusieurs runtimes et est livré avec un runtime local. Le runtime local s'exécute localement sur docker swarm, grâce à sa facilité d'utilisation et à sa légèreté. La prise en charge de plusieurs runtimes permet d'en ajouter d'autres, comme l'exécution des agents de scan sur Kubernetes. Le runtime démarre un service RabbitMQ standard, un service Redis standard, lance tous les agents listés dans l'AgentRunDefinition, vérifie qu'ils sont sains, puis injecte l'actif cible.
1. Création de la base de données
Avant de démarrer le service docker swarm, le runtime effectue quelques vérifications : que docker est installé, que docker fonctionne et que l'utilisateur a la permission d'exécuter docker.
Si toutes les vérifications réussissent, le runtime instancie une base de données SQLite, crée les tables nécessaires, puis crée l'instance du scan dans la base de données. La base de données servira à stocker localement les résultats du scan. Elle se trouve dans le répertoire privé .ostorlab et est stockée sous la forme d'un fichier db.sqlite.
2. Création des services
Le runtime crée un réseau docker swarm où tous les services et agents peuvent communiquer, puis lance un service RabbitMQ local qui sert de bus de messages, et un service Reddis local pour le stockage temporaire des données de scan et le verrouillage distribué. Avant d'aller plus loin, le runtime vérifie que les services RabbitMQ et Redis sont en cours d'exécution et sains. Si l'un des services n'est pas sain, une exception UnhealthyService est levée.
3. Démarrage des pre-agents
Les pre-agents sont des agents qui doivent exister avant les autres. Cela s'applique à tous les agents de persistance, qui peuvent commencer à envoyer des données dès le démarrage de l'agent.
Si les services sont sains, le runtime démarre les agents en 3 phases. En effet, certains agents doivent s'exécuter avant le démarrage de tous les agents, comme le tracker qui suit la progression du scan. Et certains agents doivent s'exécuter après le démarrage et le fonctionnement de tous les agents, comme l'agent d'injection d'actifs. L'étape suivante consiste à vérifier que les pre-agents sont sains, puis à lever une exception AgentNotHealthy s'ils ne le sont pas.
4. Démarrage des agents
Après avoir vérifié que les pre-agents sont sains, il est temps de démarrer les agents listés dans la définition du groupe d'agents. Une définition de groupe d'agents est un ensemble d'agents et de leurs configurations. Pour chaque agent de la définition du groupe d'agents, une série d'étapes se déroule. D'abord, on peut éventuellement transmettre des configurations et des montages docker supplémentaires avant de vérifier si l'agent est installé (si l'image est présente dans le conteneur docker), puis d'instancier un agent de runtime qui se charge de consolider les paramètres de l'agent et la définition par défaut de l'agent, avant de créer le service de l'agent. Si l'option --follow a été transmise lors de la création du scan, le runtime commence à diffuser les logs du service de l'agent. Si l'un des agents n'est pas sain, nous levons une exception.
5. Injection des actifs
Pour injecter l'actif, nous créons d'abord les paramètres de l'agent agent/ostorlab/inject_asset, puis nous les transmettons à la classe AgentRuntime, avec le client docker, le service MQ et le service Redis. La classe AgentRuntime se charge de consolider les paramètres de l'agent et les paramètres par défaut de l'agent. La classe renvoie un agent de runtime sur lequel nous appelons la méthode create_agent_service, qui crée un service d'agent docker avec les bonnes configurations et politiques. La progression du scan est alors définie sur IN_PROGRESS.
6. Démarrage des post-agents
Voilà ! Encore une étape avant de pouvoir être sûr que le scan a été créé avec succès. Nous devons démarrer les post-agents, c'est-à-dire les agents qui doivent exister après les autres. Cela s'applique à cet agent tracker, qui doit surveiller les autres agents et gérer le cycle de vie du scan. Nous vérifions ensuite que les post-agents sont sains et, si c'est le cas, le scan a été créé avec succès.
Toute exception levée lors des étapes expliquées ci-dessus entraîne l'arrêt du scan.
7. Traitement des messages
Lorsque la méthode run est appelée pour lancer l'exécution du scan, elle démarre le contrôle de santé et commence à écouter les nouveaux messages. Chaque agent publie dans la file et consomme depuis celle-ci, et ne traite que les messages des sélecteurs spécifiés par l'agent. De même, lorsque l'agent a fini de traiter le message, il envoie un message à tous les agents à l'écoute sur le sélecteur spécifié. Voyons comment les agents publient dans la file et consomment depuis celle-ci.
- Assurez-vous de créer un scan si ce n'est pas déjà fait, avec
oxo scan run --install --agent agent/ostorlab/nmap --agent agent/ostorlab/tsunami --agent agent/ostorlab/nuclei --agent agent/ostorlab/openvas ip 8.8.8.8
- Listez tous les conteneurs en cours d'exécution avec
docker ps
- Connectez-vous au conteneur RabbitMQ avec
docker exec -it <container_id> bash
container_id est l'ID de notre conteneur rabbitMQ.
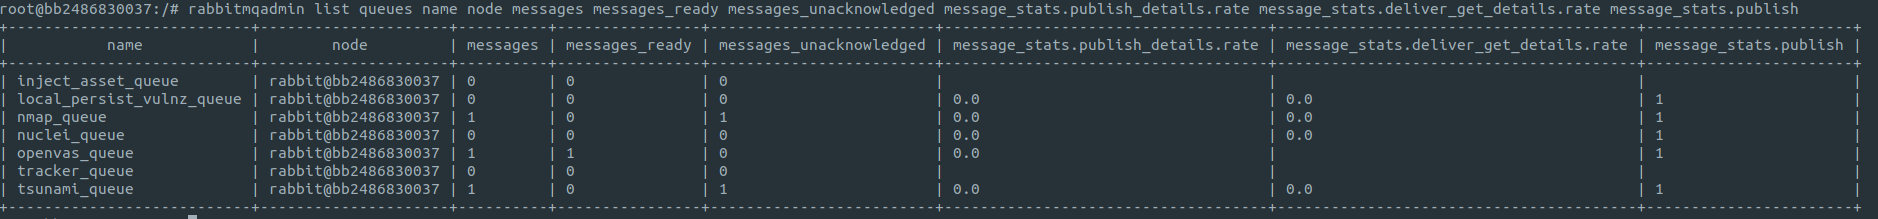
- Pour lister les files, nous utilisons la commande :
rabbitmqadmin list queues name node messages messages_ready messages_unacknowledged message_stats.publish_details.rate message_stats.deliver_get_details.rate message_stats.publish
Exemple de sortie de la commande ci-dessus
Signalement des vulnérabilités
Si l'agent souhaite signaler une vulnérabilité, il peut le faire facilement en transmettant l'entrée de base de connaissances (Knowledge Base Entry) d'Ostorlab à la méthode report_vulnerability, qui récupère les détails d'une entrée de la base de connaissances et émet un message de vulnérabilité.
La base de connaissances intégrée n'est pas obligatoire et l'API prend en charge la persistance d'entrées de vulnérabilité arbitraires.
Exemple de signalement d'une vulnérabilité par Nmap :
scan_result_technical_detail = process_scans.get_technical_details(scan_results)
       if normal_results is not None:
           technical_detail = f'{scan_result_technical_detail}\n```xml\n{normal_results}\n```'
           self.report_vulnerability(entry=kb.KB.NETWORK_PORT_SCAN,
                                     technical_detail=technical_detail,
                                   risk_rating=vuln_mixin.RiskRating.INFO)
Les vulnérabilités signalées sont accessibles avec la commande suivante :
oxo vulnz describe -s [scan-id]
Cet article était une plongée approfondie dans le fonctionnement interne d'OXO. La plateforme évoluant en permanence, les concepts présentés ici pourront évoluer pour répondre à davantage de cas d'usage et aux besoins futurs.