El ciclo de vida de un escaneo: cómo funciona el escáner de vulnerabilidades de código abierto de OXO
Este artículo explica cómo funciona OXO por dentro.
OXO lleva ya un tiempo como software de código abierto, y este artículo se propone explicar en detalle cómo funciona por dentro. Veremos el ciclo de vida de un escaneo y también los agentes: qué son y qué papel desempeñan al ejecutar un escaneo.
Creación de un escaneo
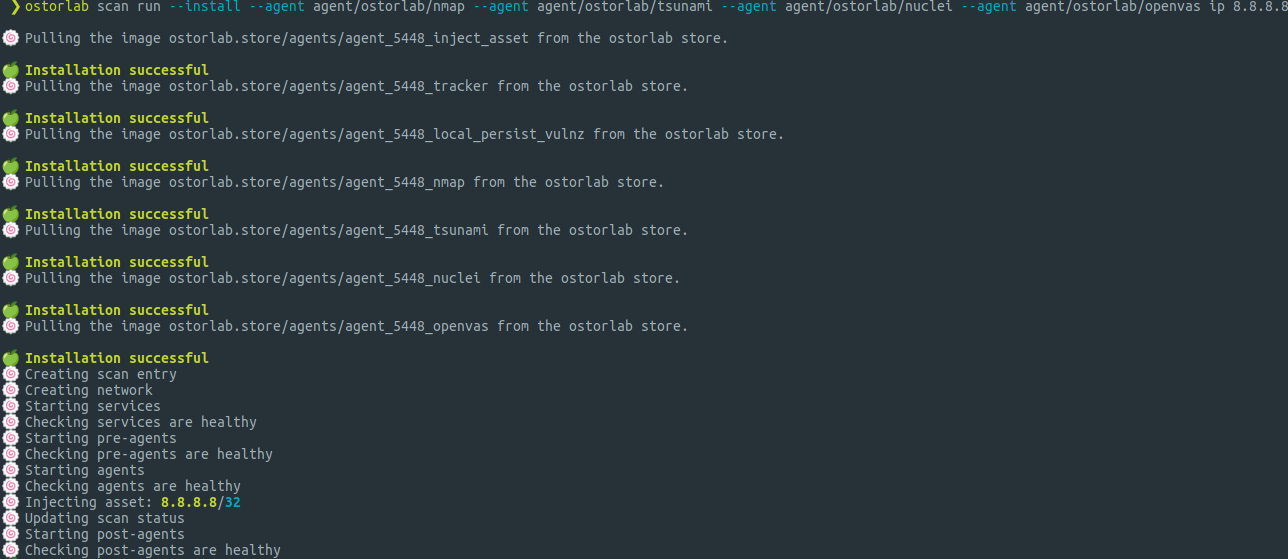
Para este artículo, vamos a ejecutar un escaneo sobre la IP 8.8.8.8 con los agentes Nmap, Tsunami, OpenVas y Nuclei, y seguiremos su ciclo de vida hasta que se complete. Si es la primera vez que crea un escaneo, consulte este artículo: https://oxo.ostorlab.co/tutorials. Para ejecutar este escaneo, necesitará el siguiente comando:
oxo scan run --install --agent agent/ostorlab/nmap --agent agent/ostorlab/tsunami --agent agent/ostorlab/nuclei --agent agent/ostorlab/openvas ip 8.8.8.8
Para ver un desglose completo del comando de escaneo anterior, consulte este tutorial.
Primero, veamos algunos conceptos importantes antes de analizar cómo se ejecuta realmente un escaneo de principio a fin.
Agentes y grupos de agentes
OXO se apoya en agentes para realizar el escaneo propiamente dicho, y esos agentes están en el núcleo de las capacidades de detección de oxo. Cada agente tiene un archivo YAML de definición del agente. Ese archivo apunta al archivo docker, que puede estar en cualquier parte del repositorio. El archivo define un conjunto de atributos específicos del agente, como la ruta al archivo docker, los argumentos que acepta y sus selectores de entrada y de salida. Los selectores expresan el tipo de mensajes que el agente espera o que le interesan. Un agente escucha los mensajes que llegan a través de sus selectores de entrada y puede emitir mensajes a través de sus selectores de salida.
Los agentes pueden realizar diversas tareas, como escaneo de seguridad, análisis de archivos y enumeración de subdominios, y pueden comunicarse con otros agentes.
El esquema de un archivo de definición de agente se especifica en el archivo agent_schema.json, que contiene una descripción completa del archivo de definición. Los atributos obligatorios de todo archivo de definición son name, kind (Agent o AgentGroup), in_selectors y out_selectors.
Uno de los retos de empaquetar aplicaciones con docker es el tamaño de la imagen resultante. Antes, se necesitaban dos archivos docker: uno para desarrollo y otro para producción. Para resolver este problema, OXO propone el patrón builder para optimizar las imágenes de los agentes. Así se consigue que la imagen resultante sea más pequeña y se elimina la necesidad de mantener dos archivos docker.
El archivo principal del agente, en este caso, es nmap_agent.py. Es el punto de entrada.
Ejemplo de archivo Dockerfile para el Nmap Agent
FROM python:3.8-alpine as base
FROM base as builder
RUN apk add build-base
RUN mkdir /install
WORKDIR /install
COPY requirement.txt /requirement.txt
RUN pip install --prefix=/install -r /requirement.txt
FROM base
RUN apk update && apk add nmap && apk add nmap-scripts
COPY --from=builder /install /usr/local
RUN mkdir -p /app/agent
ENV PYTHONPATH=/app
COPY agent /app/agent
COPY ostorlab.yaml /app/agent/ostorlab.yaml
WORKDIR /app
CMD ["python3", "/app/agent/nmap_agent.py"]
Estructura de un agente
Todos los agentes deben heredar de la clase Agent para acceder a diversas funcionalidades, como la serialización automática de mensajes, la recepción y el envío de mensajes, el registro de selectores, la comprobación de estado del agente, etc. Conviene señalar que un agente puede ser un procesador de mensajes o ser independiente. Los agentes independientes pueden ser de ejecución prolongada o de ejecución única.
Un agente que procesa un mensaje debe implementar el método process y declarar un conjunto de selectores de escucha. Los selectores se definen en el archivo YAML de definición del agente.
Los agentes independientes no tienen selectores a los que escuchar y deben implementar su lógica en el método start. Entre sus casos de uso se encuentran los inyectores de entrada, como los inyectores de activos o de configuración. También incluyen procesos de ejecución prolongada, como un proxy.
Los agentes pueden definir opcionalmente un método personalizado de comprobación de estado, is_healthy, para informar al tiempo de ejecución de que el agente está operativo y garantizar que el activo del escaneo no se inyecte antes de que el agente haya completado su configuración.
Un agente que quiera persistir datos debe heredar de AgentPersistMixin, que implementa la lógica para persistir datos. El mixin permite el almacenamiento distribuido de un grupo de réplicas de agentes o de un único agente que necesite un almacenamiento fiable.
Los agentes también pueden heredar opcionalmente de AgentReportVulnMixin, que implementa la lógica de obtener entradas de la base de conocimiento y emitir mensajes de vulnerabilidad.
Para una explicación detallada de cómo se implementa un agente, consulte este tutorial.
Ejemplo de archivo de definición de agente para el Nmap Agent. Los atributos definidos en este archivo son específicos de cada agente.
kind: Agent
name: nmap
version: 0.4.0
image: images/logo.png
description: |
Agent responsible for network discovery and security auditing using Nmap.
license: Apache-2.0
source: https://github.com/Ostorlab/agent_nmap
in_selectors:
 - v3.asset.ip.v4
 - v3.asset.ip.v6
 - v3.asset.domain_name
 - v3.asset.link
out_selectors:
 - v3.asset.ip.v4.port.service
 - v3.asset.ip.v6.port.service
 - v3.asset.domain_name.service-
 - v3.report.vulnerability
docker_file_path : Dockerfile
docker_build_root : .
args:
 - name: "ports"
   type: "string"
   description: "List of ports to scan."
   value: "0-65535"
 - name: "timing_template"
   type: "string"
   description: "Template of timing settings (T0, T1, ... T5)."
   value: "T4"
- kind: puede ser
Agentpara un único agente oAgentGroupsi queremos admitir varios agentes. - name: el nombre del agente. Debe estar en minúsculas y contener solo caracteres alfanuméricos.
- version: debe respetar la convención de versionado semántico.
- image: la ruta a la imagen o al logotipo del agente.
- description: descripción del agente.
- source: el repositorio de código fuente del agente.
- in_selectors: los selectores a través de los cuales el agente escuchará los mensajes entrantes.
- out_selectors: los selectores a través de los cuales el agente emitirá mensajes de respuesta.
- args : argumentos que queremos pasar a nuestro agente; en este caso, es
ports, la lista de puertos que se van a escanear. - docker_file_path: la ruta al archivo docker que ensamblará la imagen docker del agente.
- docker_build_root: directorio de compilación de Docker para la compilación automatizada de versiones.
Mixins de agente admitidos
-
AgentHealthcheckMixin: el mixin de comprobación de estado del agente garantiza que los agentes estén operativos. Ejecuta un servicio web (por defecto en 0.0.0.0:5000) que debe devolver el estado 200 y OK como respuesta. El mixin permite añadir varias funciones de callback de comprobación de estado, y todas deben devolver True. El estado se comprueba mediante el endpointhttp://0.0.0.0:5000/statusy devolverá OK si todo está bien y NOK en caso de que falle alguna de las comprobaciones.Dado que la comprobación puede fallar de maneras distintas, por ejemplo, si una función de callback de comprobación lanza una excepción, el servicio web no las captura de forma intencionada para facilitar su detección y depuración. La comprobación de estado debe verificar la presencia de OK y no la ausencia de NOK.
Uso típico:
status_agent = agent_healthcheck_mixin.AgentHealthcheckMixin()
status_agent.add_healthcheck(self._is_healthy)
status_agent.start()
-
AgentReportVulnMixin: este mixin implementa la lógica de obtener entradas de la base de conocimiento y emitir mensajes de vulnerabilidad. -
AgentPersistMixin: este mixin implementa la lógica para persistir datos. Permite el almacenamiento distribuido para un grupo de réplicas de agentes o para un único agente que necesite un almacenamiento fiable. Un caso de uso típico es garantizar que el valor de un mensaje se procese una sola vez cuando varios agentes producen duplicados o mensajes similares.
Uso típico:
status_agent = agent_persist_mixin.AgentPersistMixin(agent_settings)
status_agent.set_add('crawler_agent_asset_dna', dna)
is_new =  not status_agent.set_is_member()
Mensajes
Todos los agentes se comunican mediante mensajes. Un mensaje puede contener información como una dirección IP, un blob de archivo o una lista de subdominios. Los mensajes se serializan automáticamente en función del selector, lo que facilita transmitir y enviar los mensajes. El formato sigue estas reglas:
-
Los mensajes se serializan con el formato protobuf. Protobuf es un formato de intercambio de datos que sirve para serializar datos estructurados. Se utiliza protobuf porque es un formato de serialización binario y compacto que admite tipos de bytes sin necesidad de una codificación intermedia (costosa).
-
Los mensajes siguen una jerarquía en la que los campos de un selector hijo deben contener todos los campos del mensaje padre. Esto se aplica tanto a los mensajes entrantes como a los salientes. Por ejemplo, si el mensaje del selector
/foo/bortiene la definición:
{
   color: str
   size: int
}
El mensaje con el selector /foo/bar/baz debe tener los campos color y size, por ejemplo:
{
   color: str
   size: int
   weight: int
}
Los campos esperados en un mensaje concreto, sus tipos y si esos campos son obligatorios o no se especifican mediante protobuf. Un esquema para un uso concreto de los protocol buffers asocia tipos de datos con nombres de campo y utiliza enteros para identificar cada campo.
Ejemplo de archivo protobuf para el selector de salida v3.asset.ip.v4.port de Nmap
syntax = "proto2";

package v3.asset.ip.v4.port;

message Message {
 optional string host = 1;
 optional string mask = 2;
 optional int32 version = 3 [default = 4];
 optional uint32 port = 5;
 optional string protocol = 6;
 optional string state = 7;
}
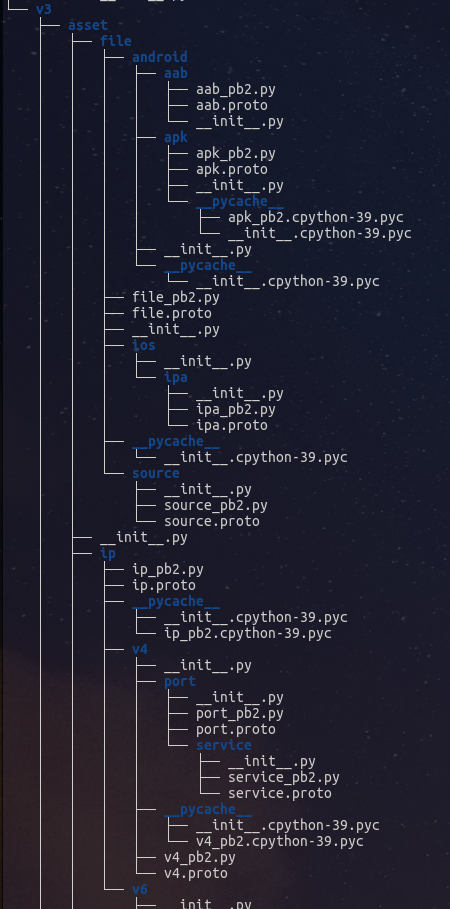
Todos los protos se definen en ostorlab > agent > message > proto > v3. Cada carpeta de v3 recibe el nombre de su selector. Por ejemplo, la carpeta asset contiene todos los protos de los selectores que empiezan por v3.asset*.
Estructura de la clase de datos Message
La clase de datos de mensaje se encarga de la serialización y deserialización de datos en función del selector de origen o de destino. Esta clase de datos tiene dos métodos, from_data y from_raw. Estos métodos ofrecen una forma cómoda de evitar manejar directamente los mensajes protobuf y la API de protobuf, no tan amigable.
-
from_data: genera un mensaje a partir de datos estructurados y de un selector de destino (el selector objetivo utilizado para definir el formato del mensaje), y devuelve un mensaje con las definiciones en bruto y de datos. El selector que se pasa a este método debe especificar la versión en uso. -
from_raw: genera un mensaje a partir de datos en bruto (datos en bruto que se deserializarán en una estructura de datos de Python) y de un selector de origen, y devuelve un mensaje con las definiciones en bruto y de datos. El selector debe especificar la versión en uso.
Escalabilidad
Los agentes admiten la ejecución de varias réplicas y su ajuste dinámico. El SDK de agentes incluye las herramientas para implementar la funcionalidad de varias instancias, como el bloqueo distribuido, el almacenamiento distribuido y el balanceo de carga de mensajes.
Los agentes pueden escalarse dinámicamente consultando el nombre del servicio docker y ejecutando el comando:
docker service scale <service_name>=<replicas_count>
También es posible establecer directamente el número inicial de réplicas al ejecutar un escaneo, en el archivo YAML de definición del grupo de agentes.
El runtime local
OXO admite varios runtimes y se distribuye con un runtime local. El runtime local se ejecuta en local sobre docker swarm, gracias a su facilidad de uso y a su ligereza. La compatibilidad con varios runtimes permite añadir otros, por ejemplo para ejecutar los agentes de escaneo sobre Kubernetes. El runtime inicia un servicio RabbitMQ estándar y un servicio Redis estándar, inicia todos los agentes enumerados en AgentRunDefinition, comprueba que estén en buen estado y, a continuación, inyecta el activo objetivo.
1. Creación de la base de datos
Antes de iniciar el servicio docker swarm, el runtime realiza algunas comprobaciones para verificar que docker está instalado, que docker funciona y que el usuario tiene permiso para ejecutar docker.
Si se superan todas las comprobaciones, el runtime crea una instancia de una base de datos SQLite, crea las tablas necesarias y, después, crea la instancia del escaneo en la base de datos. La base de datos se utilizará para almacenar localmente los resultados del escaneo. La base de datos se encuentra en el directorio privado .ostorlab y se almacena como un archivo db.sqlite.
2. Creación de los servicios
El runtime crea una red docker swarm en la que pueden comunicarse todos los servicios y agentes y, a continuación, lanza un servicio RabbitMQ local que funciona como bus de mensajes y un servicio Reddis local para el almacenamiento temporal de los datos del escaneo y el bloqueo distribuido. Antes de continuar, el runtime comprueba que los servicios RabbitMQ y Redis estén en ejecución y en buen estado. Si alguno de los servicios no está en buen estado, se lanza una excepción UnhealthyService.
3. Inicio de los preagentes
Los preagentes son agentes que deben existir antes que los demás. Esto se aplica a todos los agentes de persistencia, que pueden empezar a enviar datos desde el inicio del agente.
Suponiendo que los servicios estén en buen estado, el runtime empieza a ejecutar los agentes en 3 fases. Esto se debe a que algunos agentes deben ejecutarse antes de que arranquen todos los agentes, como el tracker, que sigue el progreso del escaneo. Y algunos agentes deben ejecutarse después de que todos los agentes hayan arrancado y estén funcionando, como el agente de inyección de activos. El siguiente paso es verificar que los preagentes estén en buen estado y, si no lo están, lanzar una excepción AgentNotHealthy.
4. Inicio de los agentes
Después de verificar que los preagentes están en buen estado, es el momento de iniciar los agentes enumerados en la definición del grupo de agentes. Una definición de grupo de agentes es un conjunto de agentes y de sus configuraciones. Para cada agente de la definición del grupo de agentes se produce una serie de pasos. En primer lugar, opcionalmente podemos pasar configuraciones y montajes adicionales de docker antes de comprobar si el agente está instalado (si la imagen está presente en el contenedor docker) y, a continuación, instanciar un agente de runtime que se encarga de consolidar la configuración del agente y la definición predeterminada del agente, y después crear el servicio del agente. Si se pasó el indicador --follow al crear el escaneo, el runtime empieza a transmitir los logs del servicio del agente. Si alguno de los agentes no está en buen estado, se lanza una excepción.
5. Inyección de los activos
Para inyectar el activo, primero creamos la configuración del agente agent/ostorlab/inject_asset y luego se la pasamos a la clase AgentRuntime, junto con el cliente docker, el servicio MQ y el servicio Redis. La clase AgentRuntime se encarga de consolidar la configuración del agente y la configuración predeterminada del agente. La clase devuelve un agente de runtime sobre el que llamamos al método create_agent_service, que crea un servicio de agente docker con las configuraciones y políticas adecuadas. A continuación, el progreso del escaneo se establece en IN_PROGRESS.
6. Inicio de los agentes posteriores
¡Bien! Solo falta un paso para tener la certeza de que el escaneo se ha creado correctamente. Tenemos que iniciar los agentes posteriores, que son agentes que deben existir después de los demás . Esto se aplica a ese agente tracker, que necesita supervisar a los demás agentes y gestionar el ciclo de vida del escaneo. Luego comprobamos que los agentes posteriores estén en buen estado y, si lo están, el escaneo se ha creado correctamente.
Cualquier excepción que se lance durante los pasos explicados anteriormente provocará que el escaneo se detenga.
7. Procesamiento de los mensajes
Cuando se llama al método run para empezar a ejecutar el escaneo, se inicia la comprobación de estado y se empieza a escuchar nuevos mensajes. Cada agente publica en la cola y consume de ella, y solo procesa los mensajes de los selectores especificados por el agente. De igual modo, cuando el agente termina de procesar el mensaje, envía un mensaje a todos los agentes que escuchan en el selector especificado. Veamos cómo publican los agentes en la cola y consumen de ella.
- Asegúrese de crear un escaneo, si aún no lo ha hecho, con
oxo scan run --install --agent agent/ostorlab/nmap --agent agent/ostorlab/tsunami --agent agent/ostorlab/nuclei --agent agent/ostorlab/openvas ip 8.8.8.8
- Muestre todos los contenedores que están en ejecución con
docker ps
- Conéctese al contenedor de RabbitMQ con
docker exec -it <container_id> bash
container_id es el ID de nuestro contenedor de rabbitMQ.
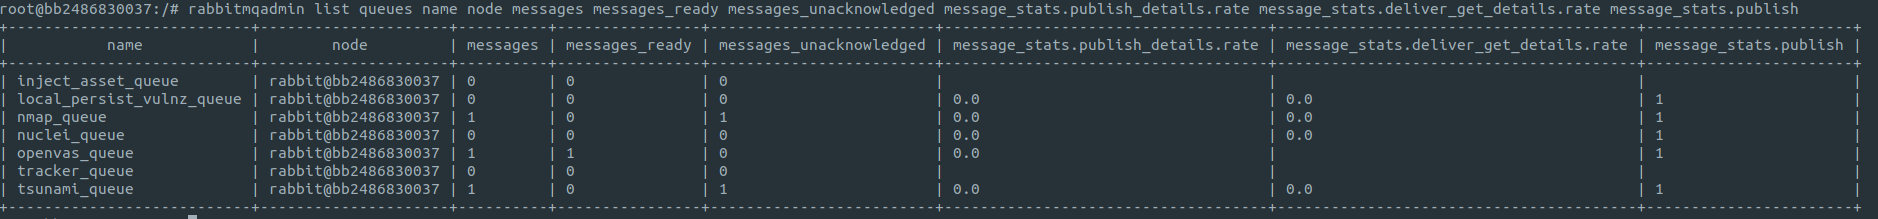
- Para mostrar las colas, utilizamos el comando:
rabbitmqadmin list queues name node messages messages_ready messages_unacknowledged message_stats.publish_details.rate message_stats.deliver_get_details.rate message_stats.publish
Ejemplo de salida del comando anterior
Notificación de vulnerabilidades
Si el agente quiere notificar una vulnerabilidad, puede hacerlo fácilmente pasando la entrada de la base de conocimiento de Ostorlab al método report_vulnerability, que obtiene los detalles de una entrada de la base de conocimiento y emite un mensaje de vulnerabilidad.
La base de conocimiento integrada no es obligatoria y la API admite persistir entradas de vulnerabilidad arbitrarias.
Ejemplo de Nmap notificando una vulnerabilidad:
scan_result_technical_detail = process_scans.get_technical_details(scan_results)
       if normal_results is not None:
           technical_detail = f'{scan_result_technical_detail}\n```xml\n{normal_results}\n```'
           self.report_vulnerability(entry=kb.KB.NETWORK_PORT_SCAN,
                                     technical_detail=technical_detail,
                                   risk_rating=vuln_mixin.RiskRating.INFO)
Las vulnerabilidades notificadas pueden consultarse con el siguiente comando:
oxo vulnz describe -s [scan-id]
Este artículo ha sido un análisis en profundidad de cómo funciona OXO entre bastidores. Como la plataforma evoluciona continuamente, los conceptos aquí tratados podrían evolucionar para cubrir más casos de uso y necesidades futuras.