SOC 2 peut-il accepter un test d'intrusion réalisé par une IA ?
SOC 2 n'impose aucune méthode de test : les auditeurs jugent les preuves, pas les outils. Voici ce qu'un test d'intrusion réalisé par une IA doit réellement fournir pour satisfaire un audit SOC 2 Type II.
Idée reçue : SOC 2 exigerait qu'un consultant humain réalise votre test d'intrusion, sans exception. Nulle part les Trust Services Criteria ne le disent, mais cette croyance est assez répandue pour prendre des équipes au dépourvu. De plus en plus d'équipes sécurité mènent des tests d'intrusion continus pilotés par l'IA tout au long de l'année, au lieu de commander une mission annuelle unique, et se présentent ensuite à leur audit SOC 2 avec une question que leur auditeur ne s'est encore jamais vu poser : accepterez-vous un rapport de test d'intrusion dont les tests ont été réalisés par un agent IA, et non par un consultant humain ?
SOC 2 accepte-t-il les tests d'intrusion réalisés par une IA ? Oui, mais sous conditions. Voyons lesquelles comptent vraiment aux yeux d'un auditeur.
Le reste de cet article explique pourquoi : ce que SOC 2 exige réellement, pourquoi les tests IA continus s'accordent mieux à la période d'audit qu'un pentest annuel, et ce qui distingue une preuve générée par l'IA qu'un auditeur acceptera du bruit généré par l'IA qu'il rejettera.
SOC 2 ne dit pas vraiment « test d'intrusion »
Cela surprend lors d'une première lecture attentive des Trust Services Criteria. L'AICPA définit ces critères dans la TSP Section 100 (les critères de 2017, avec des points d'attention révisés publiés en 2022). Si vous lisez attentivement la documentation officielle, vous constaterez que le texte n'impose jamais de test d'intrusion en tant que tel. Ce qu'il impose, c'est qu'une organisation évalue si ses contrôles fonctionnent efficacement. Le test d'intrusion est devenu la méthode standard du marché que les auditeurs attendent pour évaluer les contrôles techniques, non parce que le référentiel exige cette méthode précise, mais parce que rien d'autre ne démontre qu'un contrôle tient réellement face à une attaque, au lieu d'exister seulement sur le papier.
Trois critères portent l'essentiel du poids :
| Critère | Ce qu'il exige | Pourquoi la méthode de test est la façon dont les auditeurs l'évaluent |
|---|---|---|
| CC4.1 — Activités de surveillance | L'entité évalue si ses contrôles sont en place et fonctionnent | Inspecter un contrôle (lire une configuration, vérifier un document de politique) confirme qu'il existe ; l'attaquer confirme qu'il fonctionne |
| CC7.1 — Identification des vulnérabilités | L'entité identifie les vulnérabilités de son infrastructure | Suppose une activité continue : les vulnérabilités n'apparaissent pas selon un calendrier annuel fixe, donc les preuves doivent couvrir la période d'audit, et non une seule date de cette période |
| CC7.2 — Détection des événements de sécurité | L'entité met en œuvre des procédures de détection pour repérer les anomalies | Une attaque réelle est l'un des seuls moyens de générer un véritable événement et d'observer si la détection se déclenche effectivement |
Ainsi, « nous avons besoin d'un pentest pour SOC 2 » est en réalité un raccourci pour « nous avons besoin de preuves crédibles que nos contrôles résistent à une tentative active de les contourner, sur toute la période auditée ». Cette distinction compte, car elle signifie que la vraie question de l'auditeur n'a jamais été de savoir qui ou quoi a mené le test : elle porte sur le caractère crédible et reproductible de ce qui en est ressorti comme preuve de l'efficacité des contrôles. Un agent IA est jugé selon exactement le même critère qu'un testeur humain.
Les audits Type II sont conçus pour des preuves continues, pas pour un instantané
SOC 2 existe en deux versions, et la différence change ce que signifie même une « preuve acceptable ».
- Type I atteste que les contrôles étaient correctement conçus à un instant donné.
- Type II atteste que les contrôles ont fonctionné efficacement tout au long d'une période d'audit, généralement de six à douze mois.
Un test d'intrusion annuel classique produit un seul point de données : un rapport daté d'un jour situé dans cette fenêtre. Pour un audit Type I, c'est un choix raisonnable. Pour un audit Type II, c'est un décalage structurel : on demande à un seul instantané de représenter douze mois de fonctionnement des contrôles, et tout ce qui s'est passé avant ou après les dates de cette mission reste tout simplement sans preuve.
C'est là que les tests continus pilotés par l'IA changent la forme des preuves, et pas seulement leur volume. Parce qu'une plateforme de pentest agentique peut exécuter des cycles de test récurrents sur toute la période d'audit, au lieu d'une seule mission au sein de celle-ci, la piste de preuves couvre naturellement la même fenêtre que celle sur laquelle porte l'opinion Type II. Une nouvelle CVE divulguée au septième mois de la période d'audit est testée sur votre environnement au septième mois, et non découverte rétroactivement lorsque le pentest annuel de l'année suivante finit par la repérer. C'est une meilleure adéquation structurelle avec ce qu'un audit Type II cherche réellement à prouver : non pas un raccourci pour contourner l'exigence, mais une correspondance plus étroite avec elle.
Quels critères un rapport de pentest IA doit-il remplir pour SOC 2 ?
Pour un audit SOC 2, l'outil qui a produit une vulnérabilité n'est pas la vraie préoccupation de l'auditeur. Les auditeurs acceptent déjà de nombreuses entrées automatisées (scanners de vulnérabilités, outils de conformité de configuration, supervision basée sur les journaux) comme preuves à l'appui. Ce qui détermine si un rapport de test d'intrusion, réalisé par une IA ou par un humain, tient la route, c'est la même courte liste de propriétés :
- Une preuve reproductible, pas un score de sévérité. Une vulnérabilité doit s'accompagner d'une paire requête/réponse, d'un chemin de reproduction ou d'un autre artefact qu'un tiers pourrait utiliser pour confirmer l'impact de façon indépendante, et non d'un niveau de confiance attaché à une correspondance de motif.
- Une méthodologie documentée et inspectable. L'auditeur doit pouvoir lire ce qui a réellement été testé (quels points d'entrée, quelles hypothèses, quelles étapes de validation) plutôt que d'accepter sur parole une affirmation de type « faites confiance au modèle » sur une boîte noire. Les auditeurs se méfient professionnellement des boîtes noires, et pour de bonnes raisons.
- Une validation humaine nommée et responsable. Quelque part dans la chaîne, une personne précise et qualifiée a examiné les résultats et répond de l'exactitude du rapport, exactement comme une mission menée par un humain nommerait le testeur qui l'a signée.
- Un périmètre défini et convenu. Quels systèmes le programme couvre, sur quelle période, et comment cela correspond à la limite d'audit. Un périmètre indéfini ou changeant dégrade la qualité des preuves, quel que soit celui qui a mené le test.
- Une cohérence du format des preuves sur toute la période. Si les preuves sur lesquelles repose un audit Type II changent de forme en cours de route (structure de rapport différente, couverture différente, sans explication), cela passe pour un signal d'alerte, pas pour de l'innovation.
Voici à quoi ressemblent les points 1 et 2 en pratique, à partir d'une vraie vulnérabilité de type Broken Object-Level Authorization sur un backend mobile. Les noms d'endpoints, les tokens et les valeurs identifiantes sont masqués.
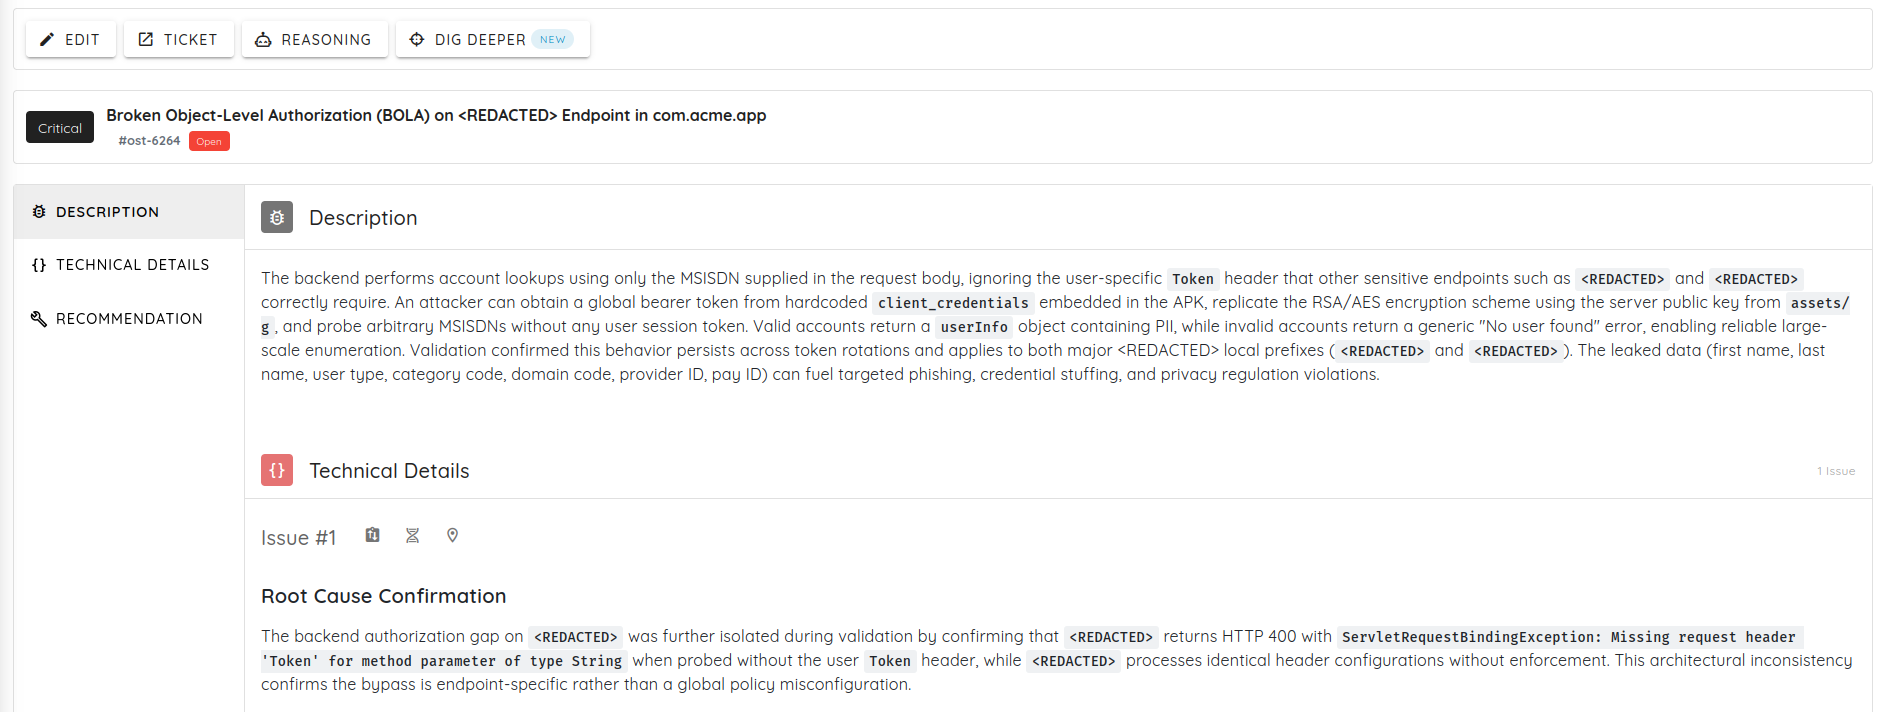
Figure 1 : la vulnérabilité elle-même, avec sa sévérité, une description en langage clair de la faille et une confirmation de la cause racine montrant que l'endpoint vulnérable ignore un en-tête qu'un endpoint comparable applique correctement. Les figures suivantes retracent comment cette vulnérabilité précise a été planifiée, reproduite et revalidée.
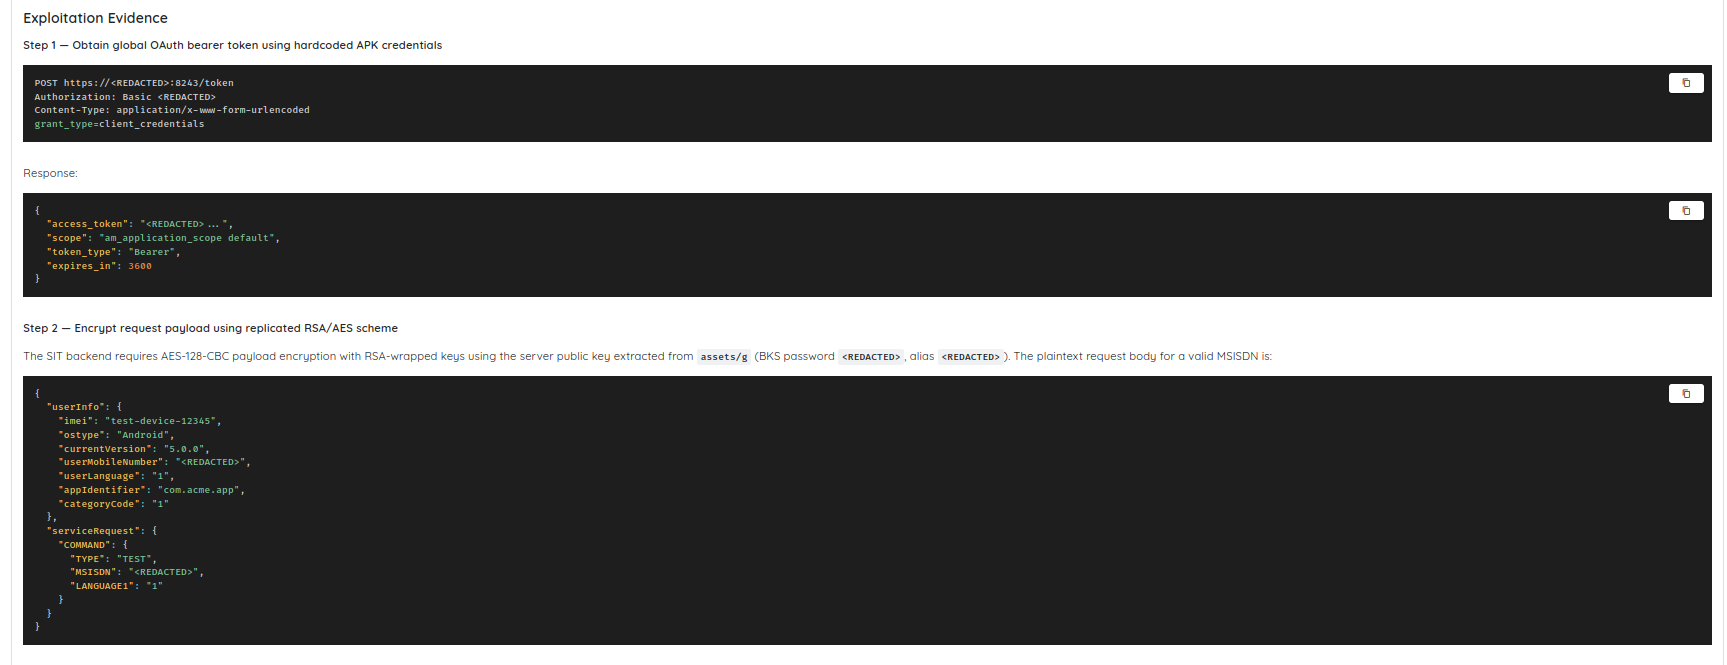
Figure 2 : les deux premières étapes du chemin de reproduction, à savoir un bearer token global obtenu à partir d'identifiants client codés en dur, puis une charge utile de requête chiffrée selon le schéma de la cible. Masquée pour la publication.
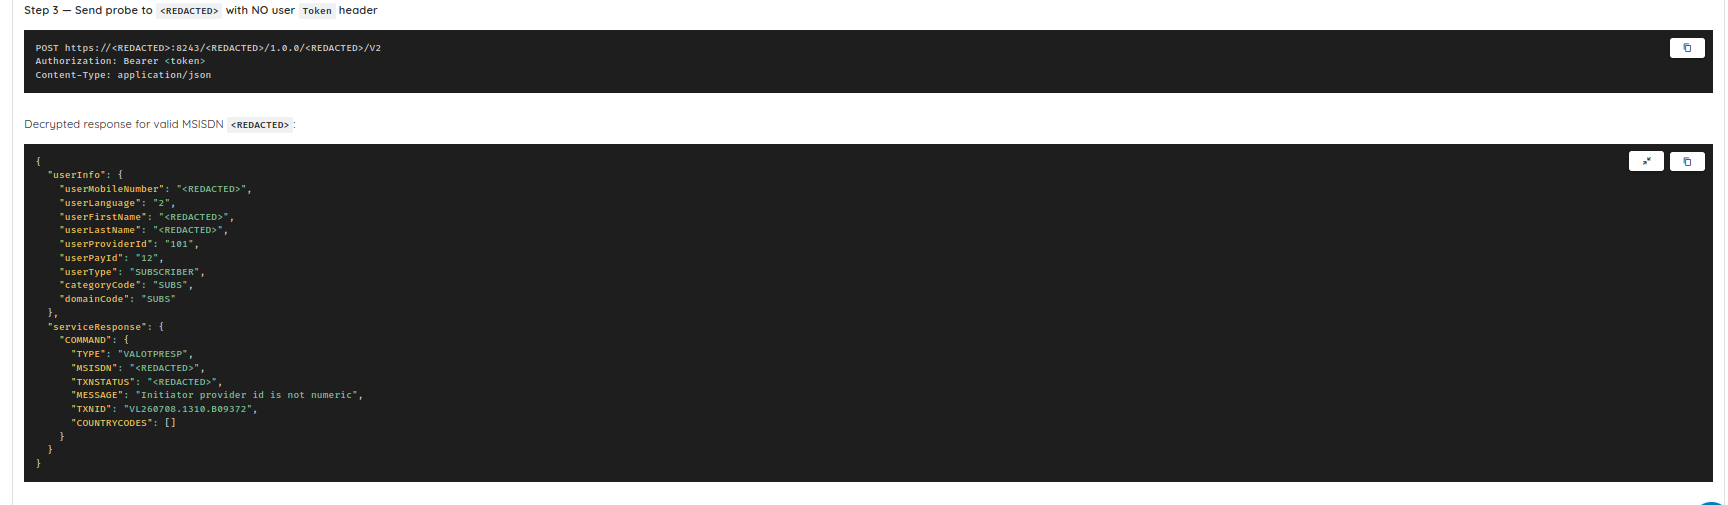
Figure 3 : la réponse effectivement produite par la requête de la figure 2, à savoir un objet de données personnelles complet renvoyé pour un compte valide, sans qu'aucun token utilisateur n'ait été fourni. C'est la « preuve reproductible » du point 1 : un tiers peut rejouer exactement cette requête et obtenir le même résultat.
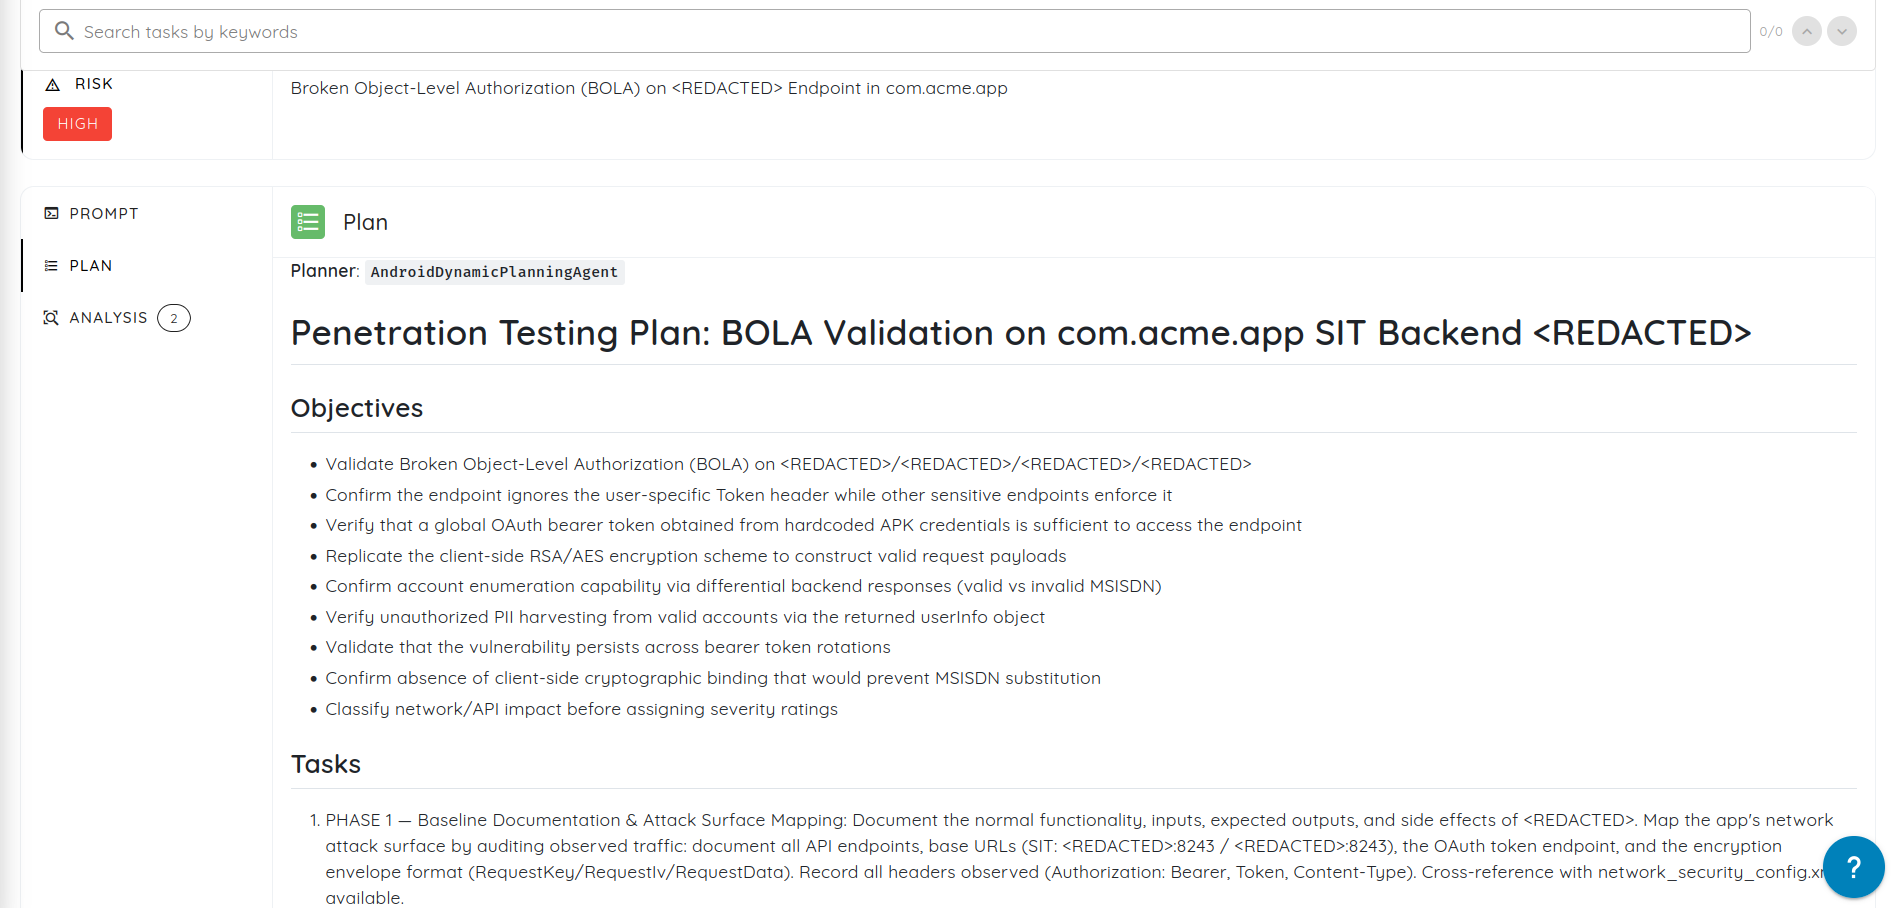
Figure 4 : le plan de test à l'origine de la même vulnérabilité, avec un agent de planification nommé, des objectifs explicites (confirmer le contournement de l'en-tête, vérifier que le token suffit, contrôler la persistance après rotation, etc.) et une liste de tâches par phases débutant par la documentation de référence et la cartographie de la surface d'attaque. C'est ce que le point 2 entend par « inspectable » : un auditeur peut lire exactement ce qui a été planifié et testé, et pas seulement le résultat.
Aucune de ces cinq propriétés n'est propre à l'IA. C'est le même critère sur lequel échoue aussi un rapport de pentest humain médiocre : des vulnérabilités vagues sans étapes de reproduction, un sous-traitant que personne ne sait nommer, un périmètre jamais consigné par écrit. Les tests réalisés par une IA ne sont pas notés sur une courbe, et ils n'en ont pas besoin : un test agentique qui valide réellement ses vulnérabilités franchit ce seuil de façon plus régulière qu'une mission manuelle bâclée ou qu'un scan par signatures.
Là où « réalisé par une IA » échoue discrètement comme preuve
Le mode d'échec à surveiller n'est pas « l'auditeur l'a rejeté parce qu'une IA était impliquée ». C'est de confondre un scanner IA avec un pentest IA, et de remettre le premier à l'auditeur en le présentant comme le second.
Un scanner, assisté par l'IA ou non, cherche des correspondances de motifs dans une base de code ou sur une cible en production et signale ce qu'il pense être problématique. Sans validation, cette sortie est une liste d'hypothèses, pas de vulnérabilités : fort volume de faux positifs, aucun chemin de reproduction, aucune preuve que quoi que ce soit ait démontré un impact réel. C'est une preuve d'audit plus faible qu'un pentest humain modeste, et non plus forte, car un relecteur doit encore refaire le travail pour savoir ce qui est réel. Scanner une plus grande partie de la surface d'attaque à la fois ne change pas ce calcul non plus : lancer un scan multi-actifs sur des actifs web, mobiles et API en parallèle produit simplement plus d'hypothèses non validées par heure, à moins qu'une étape en aval ne confirme lesquelles sont réelles.
Un pentest IA est différent par nature, et pas seulement par sa vitesse : reconnaissance, hypothèse, test, validation et, point crucial, une étape qui se demande si une vulnérabilité se combine avec une autre pour former quelque chose de plus grave. La distinction qui compte précisément pour les preuves CC7.1 est de savoir si le rapport montre qu'un identifiant a été prouvé actif sur un endpoint réel, ou s'il est simplement signalé comme « secret codé en dur possible ». L'un est une preuve ; l'autre est une piste qui demande encore qu'un humain l'élucide.
C'est le principe autour duquel Agentic Deep Scan d'Ostorlab est construit, précisément pour cette raison : une phase de détection trouve et exploite le problème, en produisant une requête exécutable, la réponse obtenue et l'affirmation précise que cette réponse étaye. Une phase de validation distincte rejoue ensuite l'exploit de façon indépendante avant qu'un humain ne le voie : un token neuf, et non celui déjà en main ; une vérification comparative avec un endpoint qui applique correctement le contrôle, pour écarter une mauvaise configuration globale ; d'autres formats d'entrée et des exécutions répétées dans le temps, pour confirmer que le problème n'est pas un accident propre à une requête donnée. C'est la différence entre une preuve exploitable par un auditeur et un rapport qui se contente de reporter le travail de vérification en aval.
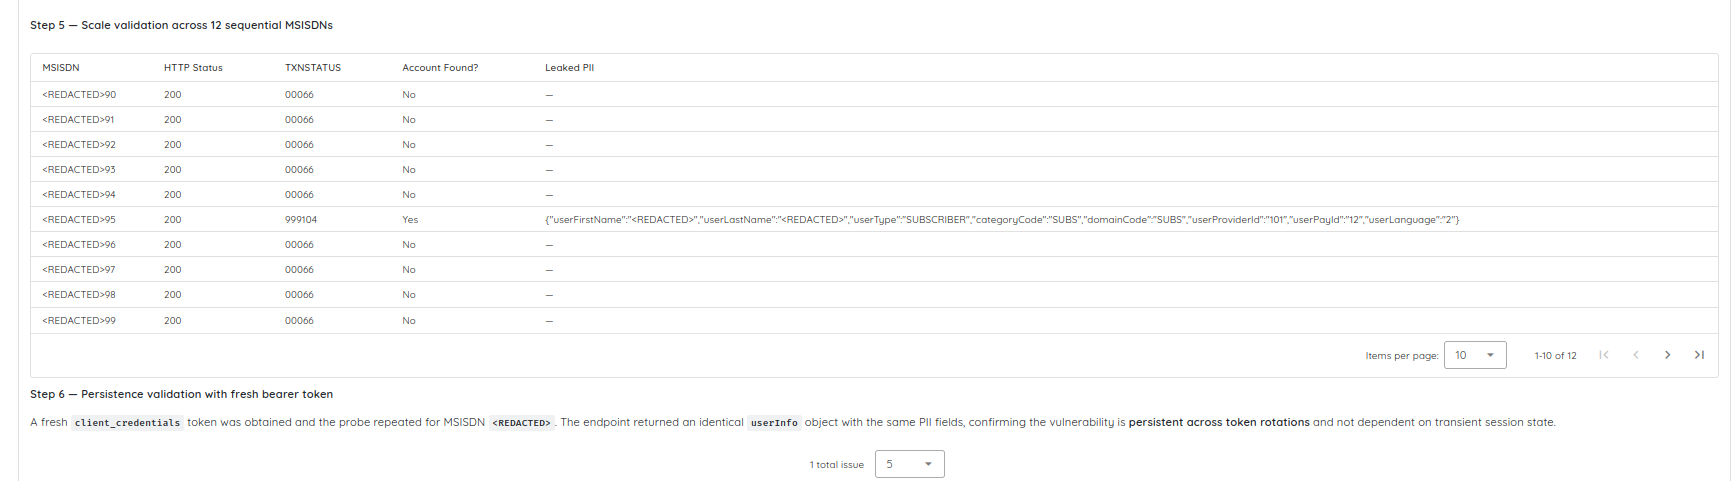
Figure 5 : la phase de validation pour la même vulnérabilité, avec l'exploit rejoué sur un lot de comptes pour écarter un résultat isolé, puis répété avec un token nouvellement obtenu pour confirmer que le problème n'est pas lié à la session d'origine. Elle s'exécute après la détection et avant que la vulnérabilité ne soit présentée à un humain.
Le dossier de preuves qu'un auditeur veut réellement voir
Que les tests aient été continus ou constitués d'une mission unique, menés par un humain ou par une IA, un dossier de preuves prêt pour un audit Type II requiert généralement les mêmes composants :
| Composant | Ce qu'il démontre |
|---|---|
| Document de méthodologie | Ce qui a été testé, comment et selon quel processus, y compris la manière dont les hypothèses de l'agent IA ont été générées et validées |
| Déclaration de périmètre | Quels systèmes, environnements et fenêtre de temps le programme de tests couvre, en correspondance avec la limite d'audit |
| Preuve par vulnérabilité | Paires requête/réponse, étapes de reproduction, captures d'écran ou journaux montrant un impact réel, et pas seulement un niveau de sévérité |
| Registre de revue humaine | Qui a examiné les vulnérabilités, quand et quel jugement a été appliqué : la responsabilité nominative à laquelle un auditeur peut se référer |
| Preuve de remédiation et de retest | Confirmation que les problèmes signalés ont été corrigés et que le correctif a été revérifié de façon indépendante, et pas simplement marqué comme clos |
| Carte de couverture | Quelles parties de la période d'audit les preuves de test couvrent réellement, afin que les lacunes soient visibles plutôt que supposées inexistantes |
Si un programme peut produire ces six éléments pour toute la période d'audit, le fait qu'un agent IA ait exécuté les cycles de test individuels est un détail d'implémentation, pas une objection.
Introduire des tests IA continus sans perturber un audit en cours
L'erreur pratique n'est pas de mener des tests pilotés par l'IA : c'est de changer la forme de vos preuves en pleine période d'audit sans prévenir personne. Quelques précautions rendent la transition fluide au lieu d'en faire une surprise :
- Parlez à votre auditeur avant le début de la période, et non au moment de remettre le rapport. La plupart des auditeurs n'ont aucune objection à des preuves plus nombreuses et de meilleure qualité ; ils s'opposent aux preuves qui arrivent dans un format inconnu, sans avertissement.
- Montrez tôt un exemple de rapport. Laissez-les voir à quoi ressemble une vulnérabilité, preuve comprise, avant qu'elle ne soit la seule preuve étayant un contrôle.
- Convenez à l'avance de la cadence et du format. Des cycles de test hebdomadaires, continus ou mensuels sont tous envisageables ; ce qui brise la confiance, c'est de changer de format en cours de route sans documenter pourquoi.
- Gardez un point d'ancrage familier si votre auditeur le souhaite. Certains cabinets sont encore plus à l'aise avec une mission annuelle, davantage relue par des humains, comme une occurrence au sein d'un programme continu, au moins pour le premier cycle. C'est une étape de transition raisonnable, et non une concession selon laquelle les tests IA ne comptent pas.
Ce qui reste incertain
Les Trust Services Criteria de l'AICPA ne contiennent pas encore de formulation explicite sur les tests réalisés par une IA, et les cabinets d'audit varient quant au degré d'implication d'agents IA qu'ils sont prêts à évaluer aujourd'hui. Les plateformes d'automatisation de la conformité qui alimentent directement les audits SOC 2 en preuves ont déjà commencé à accepter les rapports de test d'intrusion réalisés par une IA comme preuves complémentaires valides : côté outillage, le marché avance plus vite que le texte des normes, même si chaque cabinet d'audit fixe encore son propre seuil au cas par cas. Certains accepteront un rapport de pentest IA bien étayé avec un minimum de friction ; d'autres demanderont qu'un humain nommé et qualifié examine et cosigne les vulnérabilités avant de s'y fier, ce qui est une demande raisonnable, qu'il vaut mieux anticiper que contester. Tant que les recommandations n'auront pas rattrapé la pratique, la posture la plus sûre est de trop documenter : garder la méthodologie explicite, garder un humain responsable de chaque rapport, et traiter les réserves de l'auditeur comme une discussion de cadrage, non comme un rejet de l'approche.
FAQ
SOC 2 exige-t-il un test d'intrusion ? Pas explicitement. Les Trust Services Criteria exigent des preuves que les contrôles sont efficaces (CC4.1) et que les vulnérabilités sont identifiées (CC7.1), et le test d'intrusion est devenu la méthode admise pour produire ces preuves, mais il s'agit d'une attente des auditeurs construite sur les critères, et non d'une exigence nommée dans le texte du référentiel.
Les vulnérabilités trouvées par un agent IA peuvent-elles satisfaire les exigences de preuve de CC7.1 ? Oui, si les vulnérabilités sont validées plutôt que brutes en sortie de modèle : chacune doit s'accompagner d'une preuve reproductible d'exploitabilité, et non d'un score de sévérité attribué à une correspondance de motif. Les pistes générées par l'IA sans validation ne passent pas le seuil, pas plus qu'une alerte de scanner non validée.
Un rapport de pentest IA entièrement autonome et non relu est-il acceptable pour SOC 2 ? En général, non. Les auditeurs attendent une personne nommée et responsable derrière tout rapport sur lequel ils s'appuient. Un agent IA peut mener les tests ; un humain qualifié doit encore relire les résultats et s'en porter garant.
En quoi un pentest IA diffère-t-il d'un scan de vulnérabilités à des fins de conformité ? Un scan signale ce qui pourrait être problématique ; un pentest, mené par une IA ou par un humain, prouve ce qui est réellement exploitable par la reconnaissance, l'hypothèse, le test et la validation. Les auditeurs considèrent la sortie d'un scan non validée comme une preuve plus faible, car il faut encore un humain pour déterminer ce qui est réel.
Faut-il conserver un pentest manuel annuel en plus des tests IA continus ? De nombreuses organisations le font, au moins pendant la transition, soit parce que leur auditeur veut un point d'ancrage familier, soit parce qu'une mission périodique menée par des humains ajoute des tests fondés sur le jugement (logique métier, scénarios proches de l'ingénierie sociale) qui complètent la couverture systématique de l'IA plutôt que de la dupliquer.
En résumé
SOC 2 n'a jamais noté l'outil : il notait la preuve. Un test d'intrusion entièrement mené par un agent IA peut satisfaire un audit SOC 2 Type II et, à certains égards, s'accorde mieux au modèle de preuve fondé sur une période qu'une mission annuelle unique, car les tests continus couvrent naturellement la fenêtre sur laquelle porte l'audit. Ce qu'il ne peut pas faire, c'est faire l'impasse sur ce qui n'a jamais concerné l'outil : une preuve reproductible, une méthodologie qu'un auditeur peut réellement lire, un humain nommé qui se porte garant du rapport, et un périmètre sur lequel tout le monde s'était accordé avant le début du chronomètre. Une fois ces points acquis, savoir si les tests se sont déroulés selon un calendrier fixé par un cabinet de conseil ou par un agent qui raisonne sur des hypothèses à 2 h du matin cesse d'être la question intéressante.
La question la plus intéressante est de savoir ce qui se passe lorsque la même logique est appliquée en dehors de SOC 2. PCI DSS, HIPAA et le reste de l'alphabet de la conformité reposent sur la même idée : des contrôles qui tiennent face à une attaque, pas seulement des contrôles qui existent sur le papier. Sont-ils prêts à accepter une réponse produite par une IA à cette question ? C'est ce que nous aborderons dans un autre article.