SOC 2はAIが実施したペネトレーションテストを受け入れるか
SOC 2は必須のテスト手法を指定していないため、監査人が評価するのはツールではなくエビデンスです。AIが実施したペネトレーションテストがSOC 2 Type II監査を満たすために実際に必要なものを解説します。
よくある誤解:SOC 2では、ペネトレーションテストを人間のコンサルタントが実施することが例外なく求められている。トラストサービス規準のどこにもそのような記述はありませんが、この思い込みは広く浸透しており、多くのチームが不意を突かれています。年に一度の契約を発注する代わりに、AI主導の継続的なペンテストを年間を通じて実施するセキュリティチームが増えています。そうしたチームはSOC 2監査の場で、監査人がこれまで問われたことのない質問を投げかけることになります。人間のコンサルタントではなく、AIエージェントがテストを実施したペネトレーションテストレポートを受け入れてもらえるのか、という質問です。
SOC 2はAIが実施したペネトレーションテストを受け入れるのか。答えはイエスですが、条件があります。監査人にとって実際に重要な条件がどれなのかを見ていきましょう。
本記事の残りでは、それがなぜ正しいのかを順に説明します。SOC 2が実際に求めていること、なぜ継続的なAIテストが年1回のペンテストよりも監査期間に適合するのか、そして監査人が受け入れるAI生成のエビデンスと、却下されるAI生成のノイズとを分けるものは何かを取り上げます。
SOC 2は実は「ペネトレーションテスト」とは言っていない
初めてトラストサービス規準をよく読んだ人は、このことに驚きます。米国公認会計士協会(AICPA)は、TSP Section 100(2017年の規準と、2022年に公表された改訂版の着眼点)でトラストサービス規準を定めています。公式ドキュメントを注意深く読むと、本文が名指しでペネトレーションテストを義務付けている箇所は一つもないことがわかります。義務付けられているのは、組織が自らの制御が有効に運用されているかどうかを評価することです。そして、技術的な制御についてその評価を行う方法として監査人が期待する市場標準となったのがペネトレーションテストです。これはフレームワークがその特定の手法を要求しているからではなく、制御が単に書類上存在するだけでなく、攻撃を受けても実際に持ちこたえることを示せる手段が他にないからです。
主な比重を担っているのは次の3つの規準です。
| 規準 | 求められること | テスト手法が監査人の評価方法となる理由 |
|---|---|---|
| CC4.1:モニタリング活動 | 事業体は、自らの制御が存在し機能しているかどうかを評価する | 制御を確認する(設定を読む、ポリシー文書をチェックする)ことでその存在は確認でき、攻撃することでそれが機能することを確認できる |
| CC7.1:脆弱性の特定 | 事業体は、自らのインフラにおける脆弱性を特定する | 継続的な活動を意味する。脆弱性は決まった年次スケジュールで現れるわけではないため、エビデンスは期間中の一時点ではなく監査期間全体をカバーする必要がある |
| CC7.2:セキュリティイベントの検知 | 事業体は、異常を特定するための検知手順を実装する | 実際の攻撃は、本物のイベントを発生させ、検知が実際に作動するかを観察できる数少ない方法の一つである |
つまり「SOC 2のためにペンテストが必要だ」というのは、実際には「監査対象期間を通じて、制御を破ろうとする能動的な試みに対して制御が持ちこたえるという、信頼できるエビデンスが必要だ」ということの略記なのです。この区別は重要です。監査人の本当の問いは、誰が、あるいは何がテストを実行したか ではなかったことを意味するからです。問われているのは、そこから得られたものが制御の有効性を示す信頼できる再現可能なエビデンスかどうかです。AIエージェントは、人間のテスターとまったく同じ基準で評価されます。
Type II監査は一時点のスナップショットではなく継続的なエビデンスのために設計されている
SOC 2には2つの種類があり、その違いによって「受け入れ可能なエビデンス」の意味そのものが変わります。
- Type I は、ある一時点において制御が適切に設計されていたことを証明します。
- Type II は、監査期間(通常は6〜12か月)を通じて制御が有効に運用されていたことを証明します。
従来の年1回のペネトレーションテストが生み出すデータポイントは一つだけです。その期間内のある日付のレポートです。Type I監査であれば、これは妥当な適合です。しかしType II監査では構造的な不一致となります。一つのスナップショットに12か月分の制御の運用を代表させることになり、その契約期間の前後に起きたことには、まったくエビデンスがないからです。
ここで、AI主導の継続的なテストは、エビデンスの量だけでなく、その形を変えます。エージェント型のペンテストプラットフォームは、監査期間内で一度だけ契約を行うのではなく、期間全体にわたって定期的なテストサイクルを実行できるため、エビデンスの記録はType IIの意見が証明する期間と同じ期間に自然とまたがります。監査期間の7か月目に公開された新しいCVEは、7か月目に自社の環境に対してテストされます。翌年の年次ペンテストがたまたまそれを捉えたときに遡って発見されるのではありません。これは、Type II監査が実際に証明しようとしていることに構造的によりよく適合します。要件を回避する近道ではなく、要件により近く合致するものです。
SOC 2においてAIペンテストレポートが満たすべき基準とは
SOC 2監査において、検出結果を生み出したツールは監査人の本当の関心事ではありません。監査人はすでに多くの自動化されたインプット(脆弱性スキャナー、設定コンプライアンスツール、ログベースのモニタリング)を裏付けとなるエビデンスとして受け入れています。ペネトレーションテストレポートが、AIによるものであれ人間によるものであれ、通用するかどうかを決めるのは、同じ短い特性のリストです。
- 重大度スコアではなく再現可能な実証。 検出結果には、リクエスト/レスポンスのペア、再現経路、または第三者が影響を独自に確認するために使用できるその他の成果物が必要です。パターンマッチに付けられた信頼度の評価では不十分です。
- 文書化され、確認可能な手法。 監査人は、ブラックボックス的な「モデルを信頼してほしい」という主張を鵜呑みにするのではなく、実際に何がテストされたのか(どのエントリーポイント、どの仮説、どの検証ステップか)を読めなければなりません。監査人がブラックボックスに対して職業的な懐疑心を持つのには、もっともな理由があります。
- 名前を明記した、責任ある人間による承認。 チェーンのどこかで、特定の資格ある人物が結果をレビューし、レポートの正確性に責任を負っている必要があります。人間が実施する契約で、レポートに署名したテスターの名前が明記されるのとまったく同じです。
- 定義され合意されたスコープ。 プログラムがどのシステムを、どの期間にわたってカバーし、それが監査の境界とどう対応するのか。スコープが未定義であったり変動したりすると、誰がテストを実行したかにかかわらず、エビデンスの品質が損なわれます。
- 期間を通じたエビデンス形式の一貫性。 Type II監査が依拠するエビデンスの形が途中で変わる場合(レポート構造が異なる、カバレッジが異なる、説明がない)、それはイノベーションではなく危険信号と受け取られます。
モバイルバックエンドにおける実際のオブジェクトレベルの認可の不備(BOLA)の検出結果をもとに、項目1と2が実際にどのようなものかを示します。エンドポイント名、トークン、識別可能な値は伏せてあります。
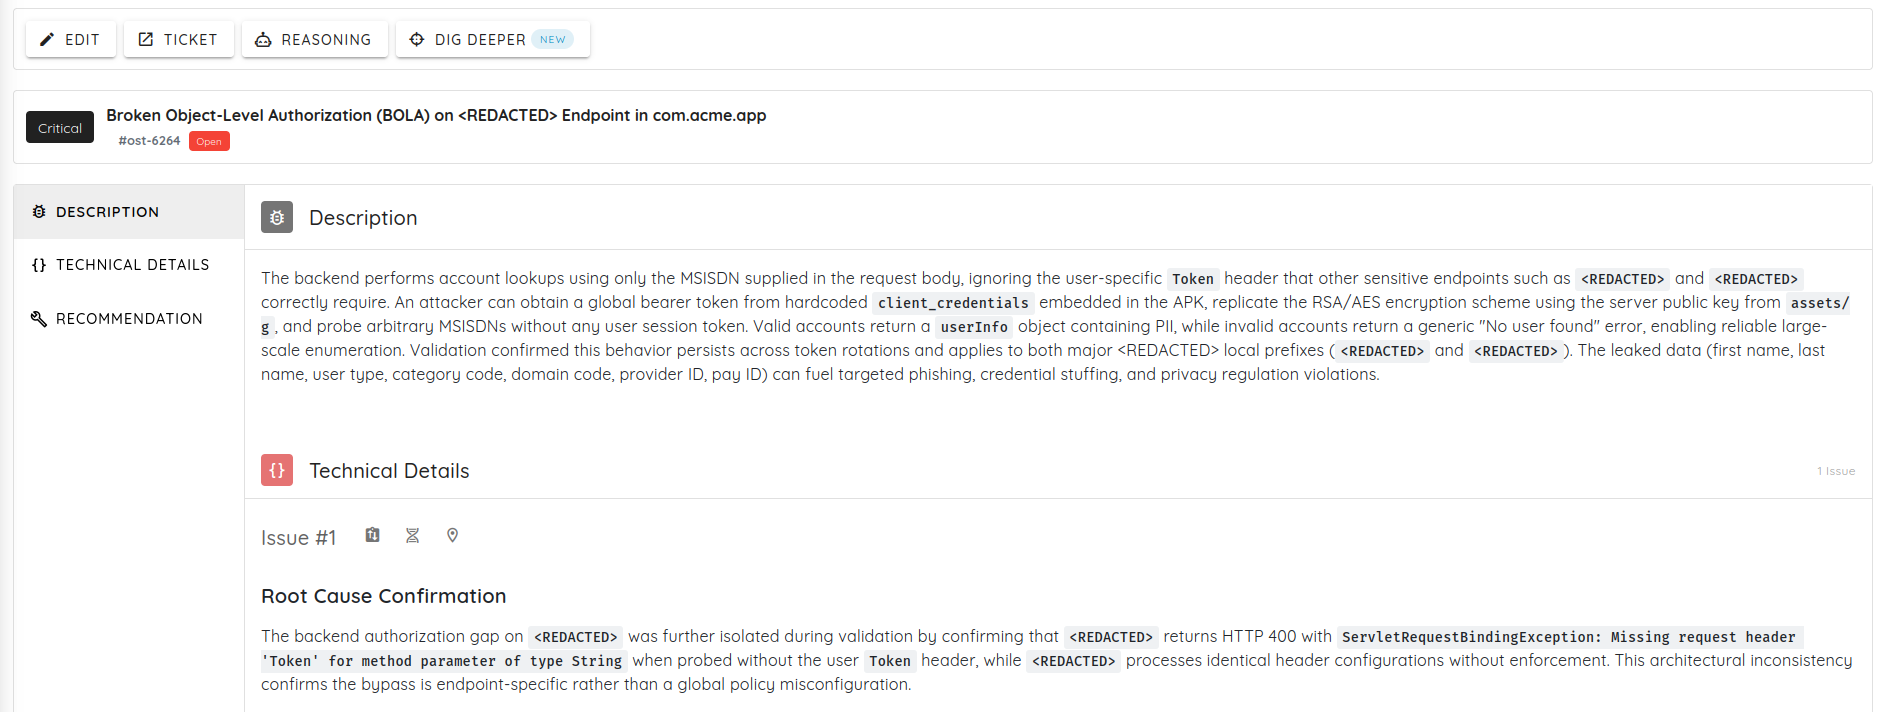
図1:検出結果そのもの。重大度、欠陥の平易な説明、そして脆弱なエンドポイントが、同等のエンドポイントでは正しく適用されているヘッダーを無視していることを示す根本原因の確認です。以下の図では、この特定の検出結果がどのように計画され、再現され、再検証されたのかをたどります。
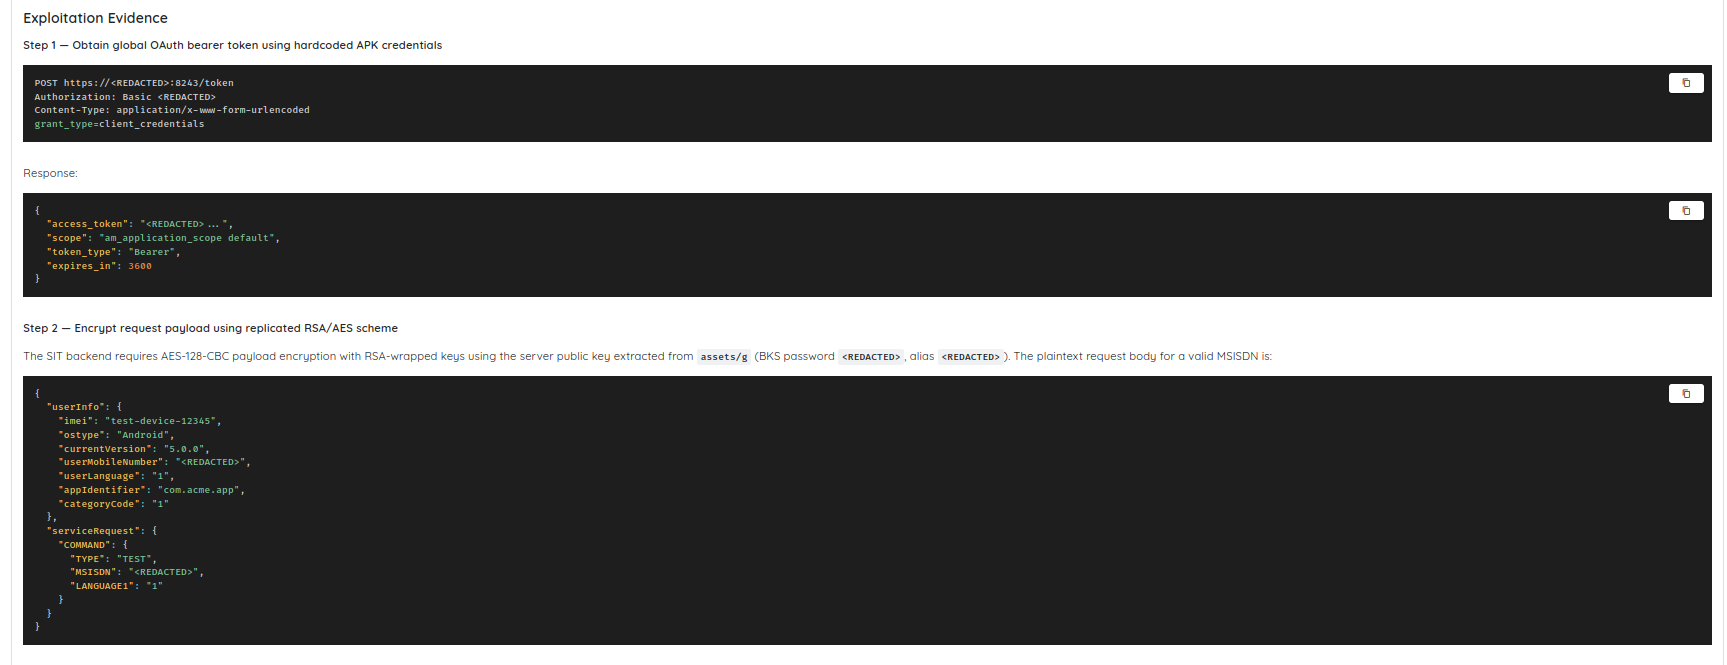
図2:再現経路の最初の2ステップ。ハードコードされたクライアントの認証情報からグローバルなBearerトークンを取得し、次に対象の方式に合わせて暗号化したリクエストペイロードを作成します。公開のため一部を伏せています。
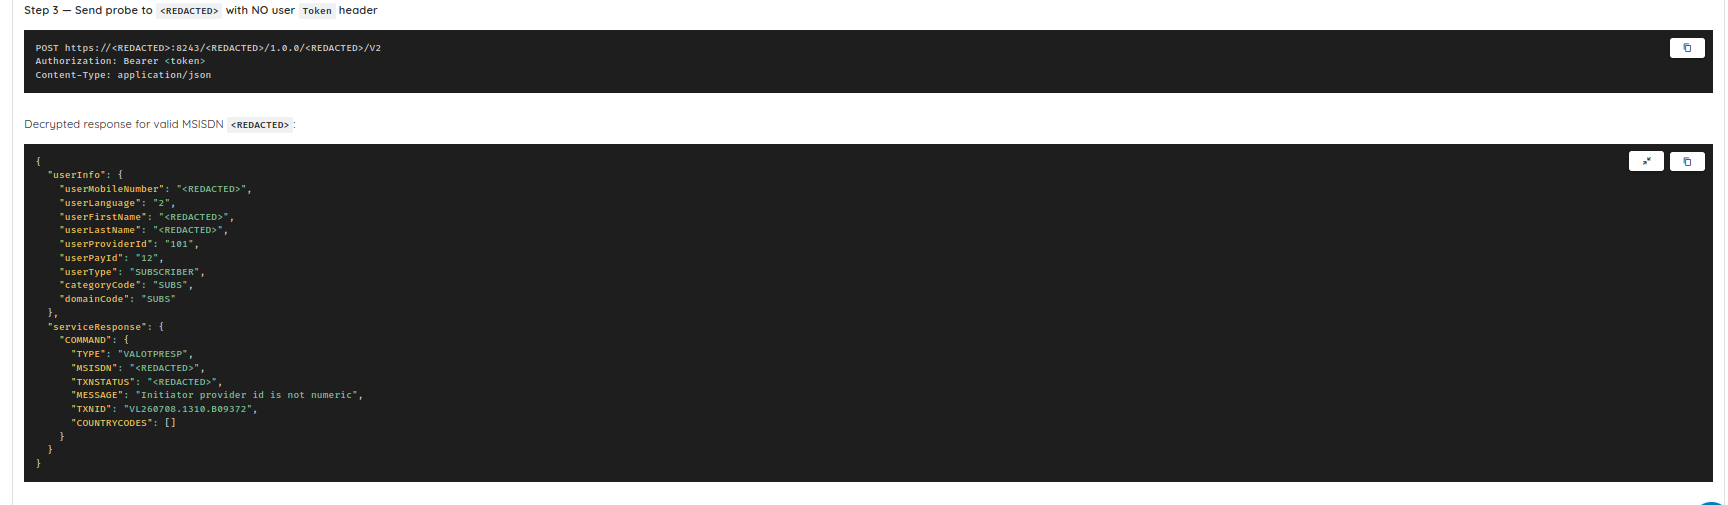
図3:図2のリクエストが実際に生み出したレスポンス。ユーザートークンを一切提供していないにもかかわらず、有効なアカウントについて個人を特定できる情報(PII)のオブジェクト全体が返されています。これが項目1でいう「再現可能な実証」です。第三者がまったく同じリクエストを再実行すれば、同じ結果を得られます。
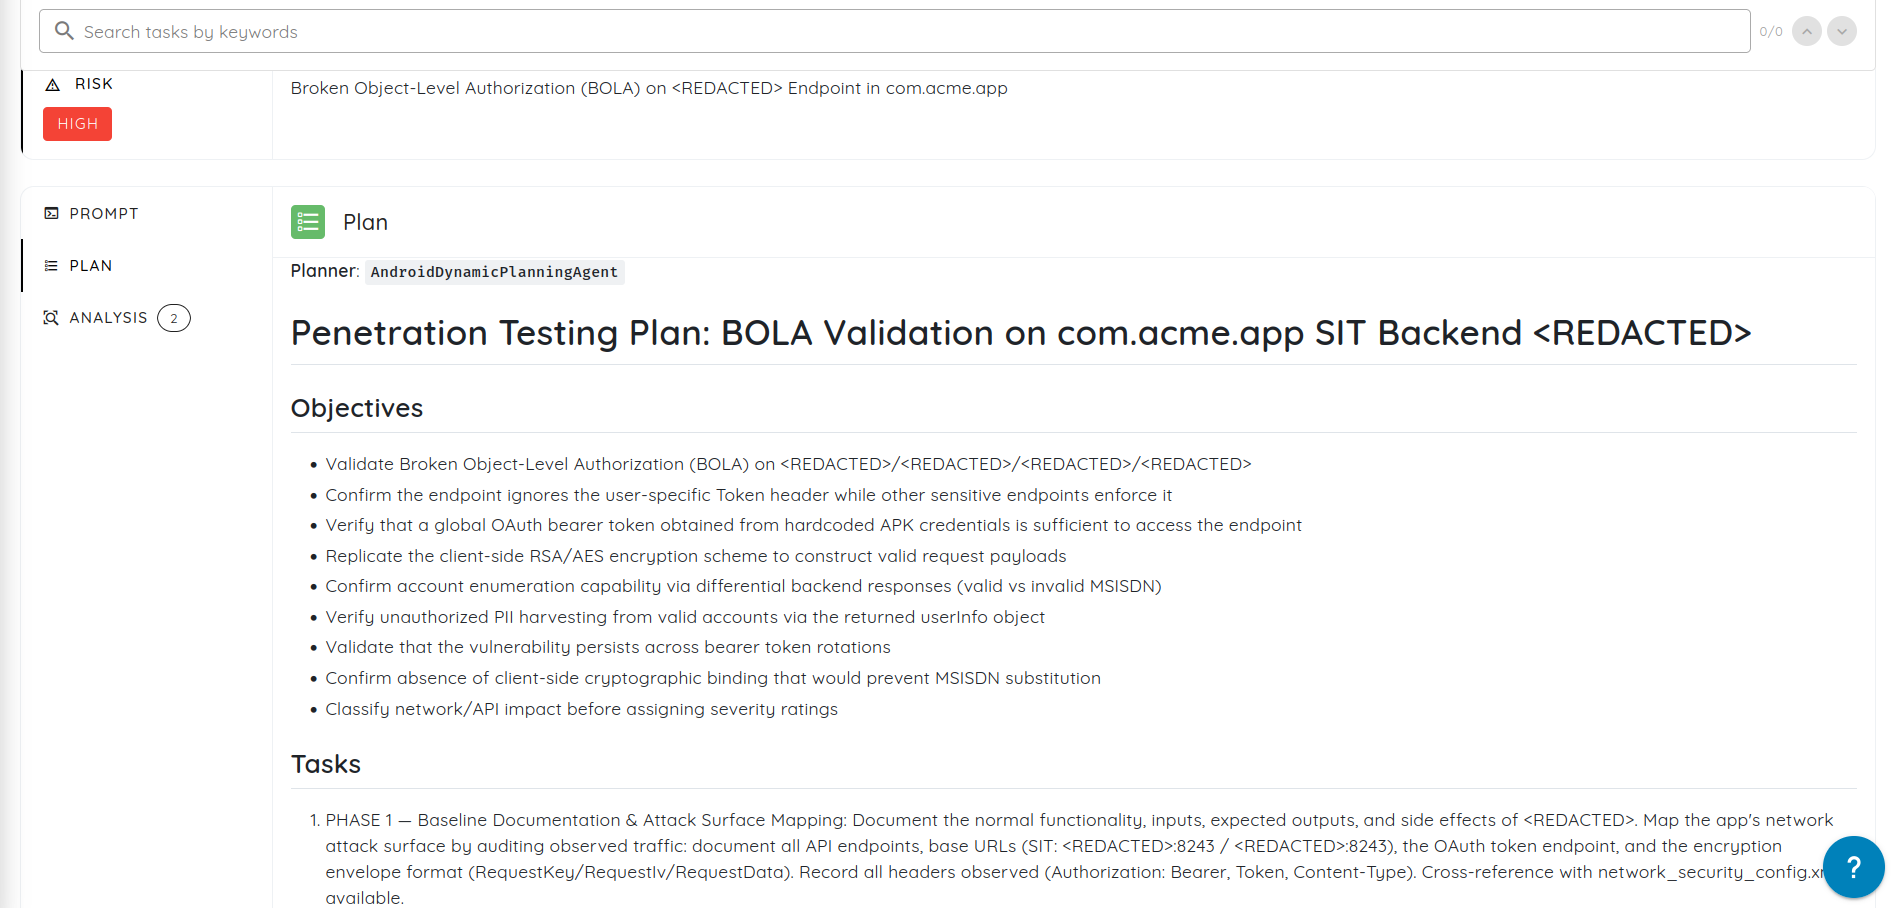
図4:同じ検出結果の背後にあるテスト計画。名前付きの計画エージェント、明示的な目的(ヘッダーのバイパスの確認、トークンで十分であることの検証、ローテーションをまたいだ持続性の確認など)、そしてベースラインの文書化とアタックサーフェスのマッピングから始まる段階的なタスクリストです。これが項目2でいう「確認可能」の意味です。監査人は結果だけでなく、何が計画され何がテストされたのかを正確に読み取ることができます。
これら5つの特性はいずれもAIに固有のものではありません。平凡な人間のペンテストレポートも満たせない、同じ基準です。再現手順のない曖昧な検出結果、誰も名前を挙げられない下請け業者、一度も書き留められなかったスコープなどがその例です。AIが実施したテストが甘く採点されることはありませんし、その必要もありません。検出結果を実際に検証するエージェント型テストは、急ごしらえの手動の契約やシグネチャベースのスキャンよりも安定してこの基準をクリアします。
「AIが実施した」がエビデンスとしてひそかに失敗する場面
注意すべき失敗のパターンは、「AIが関与していたので監査人に却下された」ということではありません。AIの スキャナー をAIの ペンテスト と取り違え、前者を後者と称して監査人に渡してしまうことです。
スキャナーは、AI支援型であるかどうかにかかわらず、コードベースや稼働中の対象に対してパターンマッチを行い、問題がありそうだと判断したものを報告します。検証されないままでは、その出力は検出結果ではなく仮説のリストです。誤検知(フォールスポジティブ)が多く、再現経路もなく、実際の影響を示したエビデンスもありません。これは控えめな人間のペンテストよりも弱い監査エビデンスであり、強いものではありません。何が本物かを知るために、レビュー担当者が作業をやり直さなければならないからです。一度に広いアタックサーフェスをスキャンしても、この計算は変わりません。Web、モバイル、APIのアセットに対してマルチアセットスキャンを並行して実行しても、下流で実際にどれが本物かを確認する仕組みがなければ、1時間あたりに生み出される未検証の仮説が増えるだけです。
AIの ペンテスト は、速度だけでなく本質的に異なります。偵察、仮説、テスト、検証、そして決定的に重要な、ある検出結果が別の検出結果と組み合わさってより深刻なものになるかどうかを問うステップがあります。特にCC7.1のエビデンスにとって重要な区別は、レポートが、認証情報が実際のエンドポイントに対して有効であることを実証したと示しているのか、それとも単に「ハードコードされたシークレットの可能性」としてフラグを立てただけなのかです。前者は実証であり、後者はまだ人間が追跡する必要のある手がかりです。
OstorlabのAgentic Deep Scanは、まさにこの理由から同じ原則に基づいて構築されています。検出フェーズで問題を発見して悪用し、実行可能なリクエスト、それが生み出したレスポンス、そしてそのレスポンスが裏付ける具体的な主張を生成します。その後、人間が目にする前に、別の検証フェーズがエクスプロイトを独立して再実行します。手元にあるトークンではなく新しいトークンを使い、グローバルな設定ミスの可能性を排除するために制御を正しく適用しているエンドポイントと比較し、特定のリクエストによる偶然でないことを確認するために、別の入力形式や時間をおいた繰り返し実行を行います。これが、監査人が行動の根拠にできるエビデンスと、検証作業を下流に先送りするだけのレポートとの違いです。
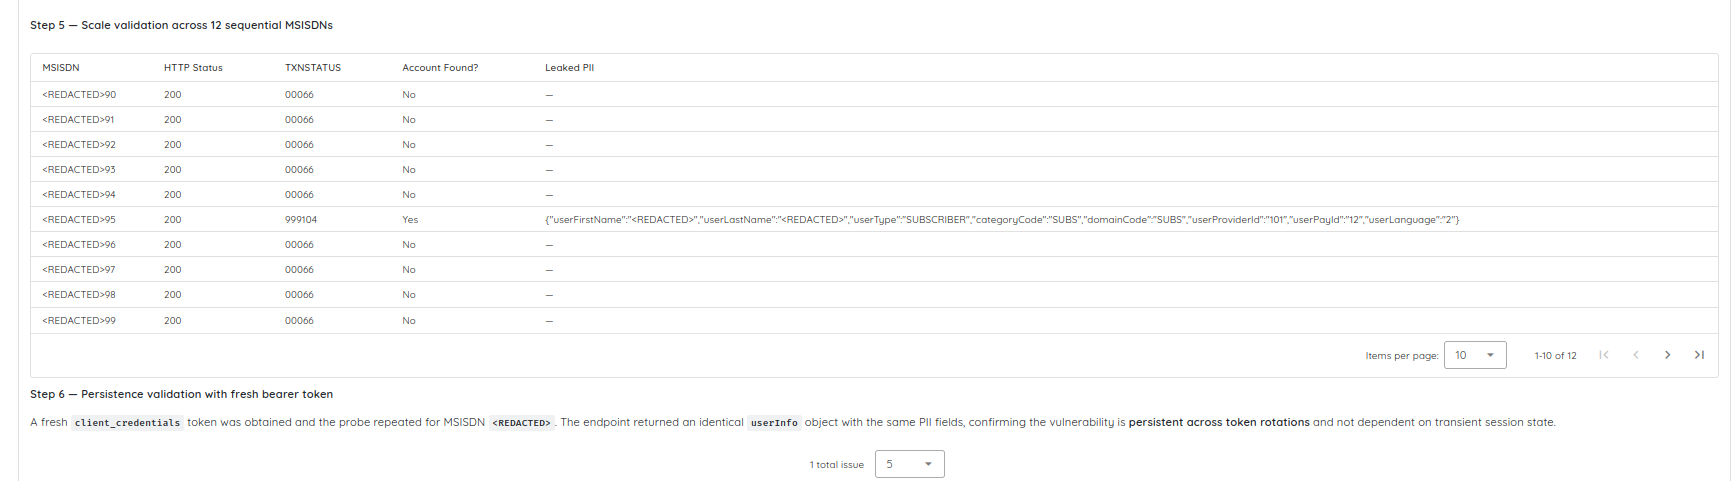
図5:同じ検出結果の検証フェーズ。一度限りの結果である可能性を排除するために複数のアカウントでエクスプロイトを再実行し、さらに新たに取得したトークンで繰り返して、問題が元のセッションに依存していないことを確認します。これは検出の後、検出結果が人間に提示される前に実行されます。
監査人が実際に見たいエビデンスパッケージ
テストが継続的なものであれ単発の契約であれ、人間によるものであれAIによるものであれ、Type IIに対応したエビデンスパッケージには一般に同じ構成要素が必要です。
| 構成要素 | 示すもの |
|---|---|
| 手法の文書 | 何を、どのように、どのようなプロセスでテストしたか(AIエージェントの仮説がどのように生成・検証されたかを含む) |
| スコープの記述 | テストプログラムがカバーするシステム、環境、期間と、それらの監査の境界への対応 |
| 検出結果ごとの実証 | 実際の影響を示すリクエスト/レスポンスのペア、再現手順、スクリーンショット、ログ(重大度ラベルだけではない) |
| 人間によるレビューの記録 | 誰が、いつ検出結果をレビューし、どのような判断を下したか。監査人が参照できる、名前を明記した責任の所在 |
| 修復と再テストのエビデンス | 報告された問題が修正され、その修正が単にクローズ扱いされただけでなく独立して再検証されたことの確認 |
| カバレッジマップ | テストのエビデンスが監査期間のどの部分に実際にまたがっているか。ギャップが見過ごされず、可視化されるようにする |
プログラムが監査期間全体についてこれら6つすべてを提示できるなら、個々のテストサイクルをAIエージェントが実行したという事実は実装上の詳細にすぎず、異議の対象にはなりません。
進行中の監査を混乱させずに継続的なAIテストを導入する
実務上の誤りは、AI主導のテストを実施することではありません。監査期間の途中で、誰にも伝えずにエビデンスの形を変えてしまうことです。移行を不意打ちではなく円滑なものにするためのポイントがいくつかあります。
- 期間が始まる前に監査人と話をする。レポートの提出期限が来てからでは遅すぎます。ほとんどの監査人は、より多くのより良いエビデンスに異議を唱えることはありません。異議を唱えるのは、予告なしに見慣れない形式で現れるエビデンスです。
- 早い段階でサンプルレポートを見せる。制御を裏付ける唯一のエビデンスになる前に、検出結果が実証を含めてどのようなものかを確認してもらいます。
- 頻度と形式を事前に合意する。週次、継続的、月次のテストサイクルはいずれも実行可能です。信頼を損なうのは、理由を文書化せずに途中で形式を切り替えることです。
- 監査人が望むなら、なじみのある基準点を残す。少なくとも最初のサイクルでは、継続的なプログラムの中の一つとして、年1回の、より人間によるレビューの比重が大きい契約のほうが安心だという監査法人もまだあります。これは妥当な移行ステップであり、AIテストが認められないことを認める譲歩ではありません。
まだ定まっていない点
AICPAのトラストサービス規準には、AIが実施するテストについての明示的な文言はまだなく、AIエージェントの関与をどの程度まで評価できるかについての姿勢は、現時点では監査法人によって異なります。SOC 2監査にエビデンスを直接提供するコンプライアンス自動化プラットフォームは、すでにAIが実施したペネトレーションテストレポートを有効な裏付けエビデンスとして受け入れ始めています。個々の監査法人が依然としてケースごとに独自の基準を設けているとしても、市場のツール側は規格の文言よりも先に進んでいます。十分なエビデンスを備えたAIペンテストレポートをほとんど摩擦なく受け入れる監査法人もあれば、依拠する前に名前を明記した資格ある人間が検出結果をレビューし連署することを求める監査法人もあります。これは妥当な要求であり、抵抗するよりも計画に組み込むべきものです。ガイダンスが実務に追いつくまでは、過剰なくらいに文書化するのがより安全な姿勢です。手法を明示し、すべてのレポートに責任を負う人間を置き、監査人からの反発をアプローチの否定ではなくスコープについての話し合いとして扱いましょう。
よくある質問
SOC 2はペネトレーションテストを要求しているか。明示的には要求していません。トラストサービス規準は、制御が有効であること(CC4.1)と脆弱性が特定されていること(CC7.1)のエビデンスを求めており、ペネトレーションテストはそのエビデンスを生み出すための受け入れられた方法になっています。ただしこれは、規準に基づく監査人の期待であって、フレームワークの本文で名指しされた要件ではありません。
AIエージェントの検出結果はCC7.1のエビデンス要件を満たせるか。検出結果がモデルの生の出力ではなく検証済みのものであれば、満たせます。それぞれの検出結果には、パターンマッチに割り当てられた重大度スコアではなく、悪用可能性の再現可能な実証が必要です。検証されていないAI生成の手がかりは、検証されていないスキャナーのアラートと同様に基準を満たしません。
完全に自律的で、レビューされていないAIペンテストレポートはSOC 2で受け入れられるか。一般的には受け入れられません。監査人は、依拠するあらゆるレポートの背後に、名前を明記した責任ある人物がいることを期待します。テストはAIエージェントが実行できますが、資格ある人間が結果をレビューし、その内容に責任を持つ必要があります。
コンプライアンスの観点で、AIペンテストは脆弱性スキャンとどう違うか。スキャンは問題がありそうなものを報告し、ペンテストは、AIによるものであれ人間によるものであれ、偵察、仮説、テスト、検証を通じて実際に悪用可能なものを実証します。監査人は検証されていないスキャン出力を弱いエビデンスとして扱います。何が本物かを判断するために、依然として人間が必要だからです。
継続的なAIテストと並行して、年1回の手動ペンテストを続けるべきか。少なくとも移行期間中は、多くの組織がそうしています。監査人がなじみのある基準点を求めているか、あるいは定期的な人間主導の契約が判断に基づくテスト(ビジネスロジック、ソーシャルエンジニアリングに近いシナリオ)を追加し、体系的なAIのカバレッジと重複するのではなく補完するためです。
結論
SOC 2が評価していたのは、最初からツールではなくエビデンスでした。完全にAIエージェントによって実施されたペネトレーションテストはSOC 2 Type II監査を満たすことができ、継続的なテストは監査が証明する期間に自然とまたがるため、いくつかの点では年1回の単発の契約よりも期間ベースのエビデンスモデルによく適合します。ただし、そもそもツールとは関係のなかった部分を省くことはできません。再現可能な実証、監査人が実際に読める手法、レポートに責任を持つ名前を明記した人間、そして開始前に全員が合意したスコープです。これらを正しく整えれば、テストがコンサルティング会社の決めたスケジュールで実行されたのか、午前2時に仮説を検討するエージェントによって実行されたのかは、もはや興味深い問いではなくなります。
より興味深いのは、同じ論理がSOC 2以外に適用されたときに何が起きるかという問いです。PCI DSS、HIPAA、その他さまざまなコンプライアンス規格も、同じ考え方に依拠しています。書類上存在するだけの制御ではなく、攻撃を受けても持ちこたえる制御です。それらの規格がこの問いに対するAIによる答えを受け入れる準備ができているかどうかについては、別の記事で取り上げます。