Cómo eludir el blindaje de aplicaciones móviles: donde termina la detección y falla la aplicación efectiva
La detección y la aplicación efectiva de medidas son propiedades de seguridad distintas. En cinco aplicaciones bancarias en producción protegidas por cuatro productos comerciales de blindaje, la detección era sofisticada y la aplicación efectiva, frágil.
El blindaje de aplicaciones móviles es una protección compilada dentro de la propia aplicación. Se comercializa como RASP, protección contra manipulaciones, antihooking, detección de root, detección de jailbreak o protección en tiempo de ejecución, y la promesa es siempre la misma: si la aplicación se encuentra en un teléfono con root, dentro de un emulador, bajo Frida, conectada a un depurador o reempaquetada, debe darse cuenta y responder.
Esa promesa tiene dos mitades, y cada una falla de forma independiente.
La detección consiste en decidir que algo va mal. La aplicación efectiva consiste en hacer algo al respecto.
Un producto puede detectar el root a la perfección y, aun así, no proteger nada, si la aplicación ignora la respuesta, hace pasar todas las respuestas por una única rama débil o confía en un dato que controla el atacante.
Evaluamos cinco aplicaciones bancarias en producción, en Android e iOS, que utilizaban cuatro productos comerciales de blindaje distintos. La detección fue sistemáticamente buena. La aplicación efectiva fue, sistemáticamente, el punto donde todo se rompía.
El primer síntoma: un cierre inesperado diseñado para no revelar nada
El escaneo instaló la primera aplicación en un dispositivo de prueba y la lanzó. Cinco segundos después, el proceso había desaparecido. Sin cuadro de diálogo, sin error, sin nada en los registros.
El informe del fallo:
signal 11 (SIGSEGV), fault addr 0x0
x0=0xdef040f0  x1=0x738416ae  x4=0x2319d258  x5=0xbd7d47fb
x6..x30=0      sp=0      pc=0
tid: Thread-7x
La señal 11 es SIGSEGV, un fallo de segmentación: el proceso accedió a la memoria de una forma que el kernel rechazó. Esa parte es corriente. El volcado de registros no lo es.
En ARM64, pc es el contador de programa, la dirección de la instrucción que se está ejecutando. sp es el puntero de pila, que ancla la pila de llamadas. x0 a x30 son los registros de propósito general, que contienen argumentos, valores de retorno y variables locales. En un fallo genuino, esos valores se conservan, y por eso mismo un informe de fallo resulta útil: el contador de programa señala la instrucción que falló y el puntero de pila permite a un depurador recorrer hacia atrás las llamadas.
Aquí todos ellos valen cero. No hay instrucción defectuosa que examinar ni pila que desenrollar. El único marco del backtrace dice #00 pc 0x0 <unknown>.
Algo borró deliberadamente el archivo de registros antes de dejar morir el proceso. El hilo que figura en el informe, Thread-7x, es un hilo de trabajo genérico sin relación con la decisión. Y 0xdef040f0 no es un puntero plausible en esta plataforma; se comporta como una marca dejada por el código de protección.
Es un patrón habitual en las aplicaciones reforzadas. En lugar de anunciar el veredicto, la aplicación destruye la evidencia forense al salir, de modo que el analista no averigua ni qué comprobación se activó ni dónde reside.
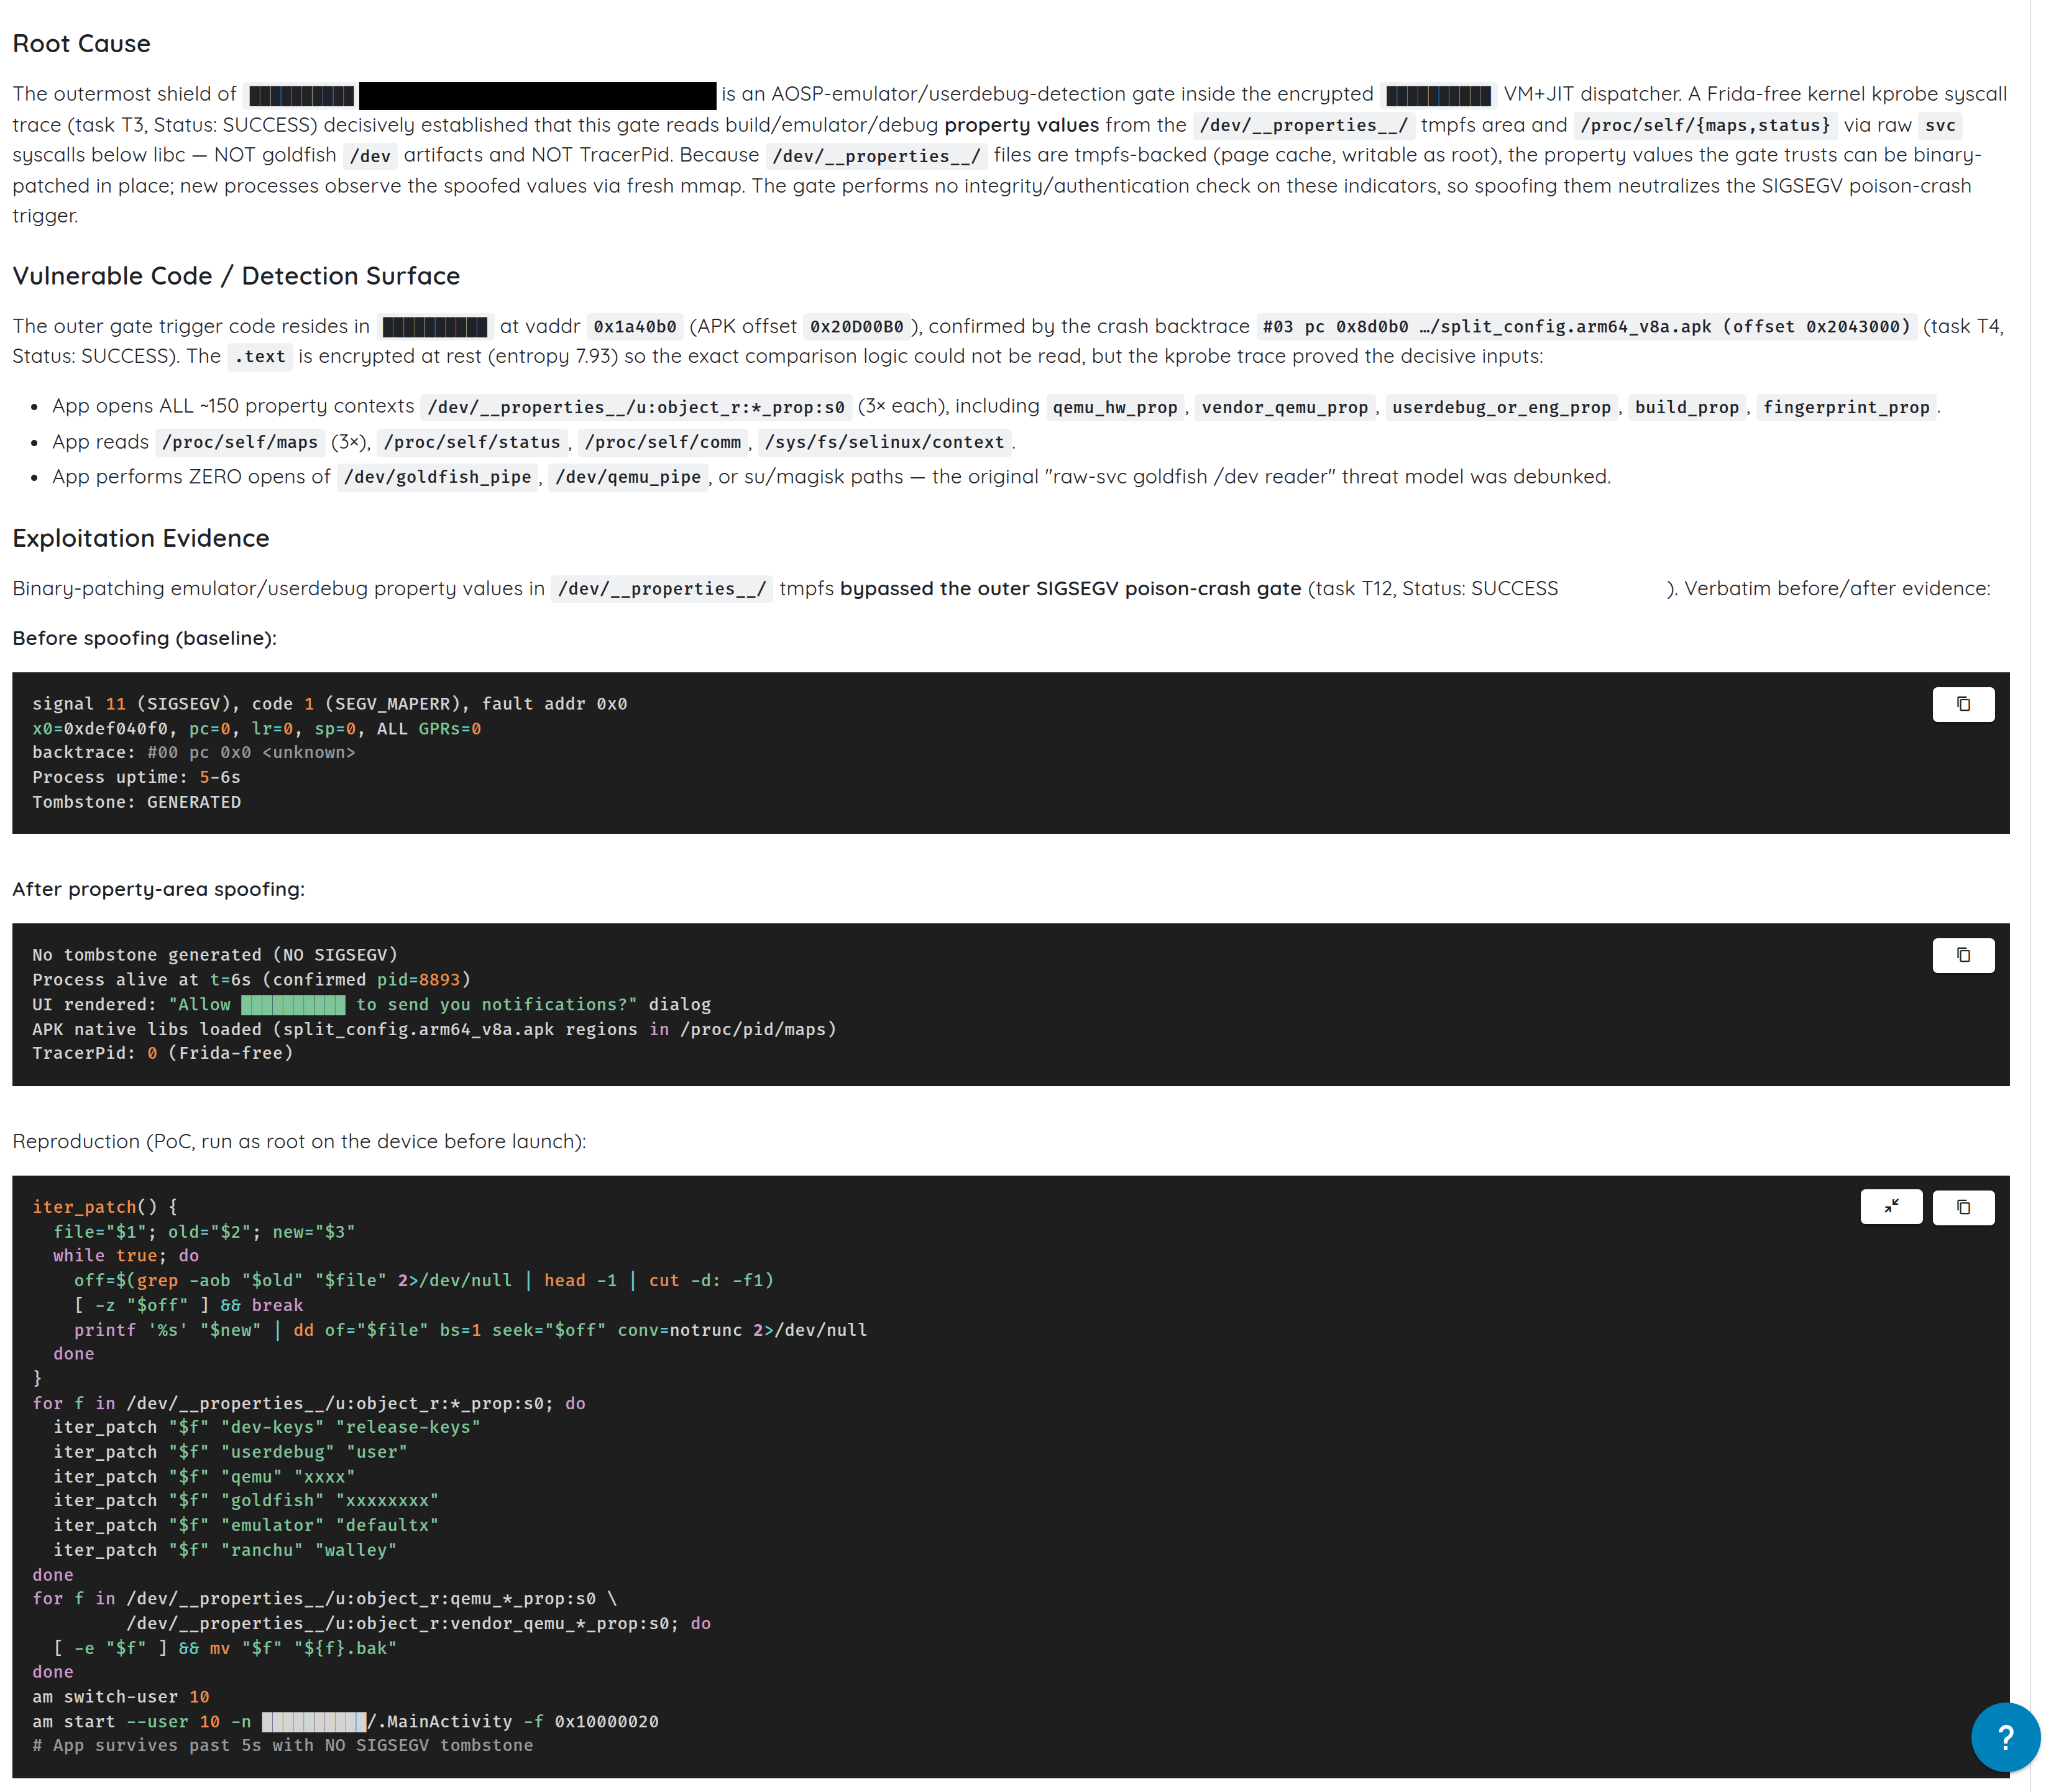
Todos los registros de propósito general valen cero y el backtrace es un único marco desconocido.
Qué vigilan realmente estos productos
La primera tarea es un inventario: ¿qué comprueba esto?
El análisis estático encontró unas treinta funciones detectoras nativas, todas registradas en una única clase Java al cargar la biblioteca.
Ese detalle importa más de lo que parece. Las aplicaciones Android acceden al código nativo en C o C++ mediante JNI, la Java Native Interface. Una biblioteca nativa puede exponer una función a Java de dos maneras. Puede exportar un símbolo con un nombre decorado como Java_com_example_Foo_bar, visible para cualquiera que ejecute nm sobre la biblioteca. O puede llamar a RegisterNatives durante JNI_OnLoad y enlazar los métodos dinámicamente en tiempo de ejecución.
Esta biblioteca usa la segunda vía, por lo que ninguno de los nombres de los detectores aparece como símbolo exportado. Hay que leer la tabla de registro o observar el proceso en ejecución para encontrarlos:
JNI_OnLoad              @ 0x424264
checkHooks              @ 0x424e50     scans the process memory map
checkForFridaAgent      @ 0x424c38
isSuExists              @ 0x424940
isFoundMagisk           @ 0x425a90
isFoundDangerousProps   @ 0x424810
isPermissiveSelinux     @ 0x4248e8
getNativeSignature      @ 0x42ca00     hashes the signing certificate
Hay cuatro categorías representadas, y cada una responde a una pregunta distinta.
La detección de root busca indicios de que el dispositivo concede privilegios elevados: binarios su en disco, artefactos de Magisk, rutas del sistema con permiso de escritura, SELinux permisivo, paquetes de gestores de root. El root importa porque permite a un atacante leer el almacenamiento privado de la aplicación, adjuntarse al proceso y modificar su tiempo de ejecución.
La detección de hooking busca frameworks que reescriben el comportamiento de las funciones en tiempo de ejecución: Frida, Xposed, LSPosed, Zygisk, Substrate, SandHook, Taichi, VirtualXposed. Un hook puede cambiar el valor de retorno de una función sin tocar el APK en disco, que es precisamente como se derrotan las comprobaciones de seguridad del lado del cliente.
checkHooks lee /proc/self/maps. En Linux y Android, ese archivo enumera cada región de memoria mapeada en el proceso actual, con sus permisos y el archivo que la respalda. Si aparece allí una biblioteca ajena o una región ejecutable anónima, la aplicación puede deducir que está siendo instrumentada.
La verificación de firma es getNativeSignature, que calcula el hash del certificado de firma de la aplicación en tiempo de ejecución. Android exige que todo APK esté firmado. Un atacante que modifica y reempaqueta una aplicación debe volver a firmarla, normalmente con otra clave, de modo que comparar el certificado en ejecución con un hash esperado detecta el reempaquetado ingenuo.
La detección de propiedades peligrosas lee las propiedades del sistema de Android, que son pares clave-valor que el sistema operativo utiliza para publicar la configuración de la compilación y del dispositivo: ro.build.tags, ro.debuggable, ro.secure, ro.hardware, ro.product.model. Las imágenes de emulador y las compilaciones de ingeniería dejan ahí valores reconocibles.
Bajo este producto de pago se apilan otros tres controles de proveedores no relacionados: una segunda comprobación de root procedente de una biblioteca gratuita de código abierto, una tercera dentro del propio código Dart compilado de la aplicación, y telemetría de un cuarto. El manifiesto llega a declarar entradas <queries> para que el gestor de paquetes responda a consultas sobre los paquetes de su, Magisk y KingRoot.
Cuatro controles independientes en una sola aplicación, cuatro opiniones independientes sobre el mismo dispositivo. Eso importa al final.
No se trata de una implementación superficial. La debilidad no es la falta de detección. Es aquello en lo que la aplicación confía y lo que hace con la respuesta.
Por qué leer la comprobación no funciona
Entre el analista y esta lógica hay tres capas, y las tres cumplen su función.
El nivel Java es un señuelo. La aplicación incluye 4,129 blobs cifrados donde deberían estar los cuerpos de los métodos, que se descifran y ejecutan solo en el arranque. Las clases que importan, incluida la actividad principal, no están en el archivo en forma legible. Un descompilador muestra la estructura y algunos puntos de llamada, no el comportamiento.
La biblioteca nativa está empaquetada. Cifrada en reposo, con un único símbolo exportado y con el contenido real existiendo solo en memoria tras el arranque. Una biblioteca tiene un nombre de archivo aleatorio y un nombre de exportación aleatorio:
libGHDSDFIUPOIFDLS8DSFN23LK.so
    export: _3Wbwdz5QepMbJNn8CiW3HwFivKZsZoNvu
Así que el escaneo volcó la biblioteca descifrada desde el proceso en ejecución y volvió a examinarla. Las comprobaciones seguían sin aparecer.
Las comprobaciones se generan en tiempo de ejecución. El código descifrado emite 69 llamadas al sistema. En ARM64, una llamada al sistema es una instrucción svc, con el número de llamada en el registro x8, por lo que un desensamblador normalmente puede leer qué función del kernel se solicita. En 64 de estos puntos, el número es una constante. En los otros cinco, la aplicación lo calcula durante la ejecución, lo que hace que esos cinco sean invisibles para el análisis estático.
Uno de los cinco se resuelve en mmap solicitando una sola página con PROT_READ | PROT_WRITE | PROT_EXEC. Lo hace aproximadamente cada 85 milisegundos. Escribe código en la página, lo ejecuta y la descarta.
La memoria que es a la vez escribible y ejecutable es inusual por diseño. Los sistemas modernos mantienen ambos permisos separados, porque la memoria en la que se puede escribir y luego ejecutar es lo que hace posible la inyección de código. Aun así, los empaquetadores y protectores la utilizan para exactamente esto: emitir comprobaciones que nunca existen como código estable en una dirección estable.
Las cadenas se construyen, no se almacenan. Al buscar qemu, goldfish o emulator en la biblioteca completamente descifrada, no se obtiene ninguna coincidencia. La aplicación ensambla esas cadenas carácter a carácter en la pila, de modo que nunca existen como texto contiguo en el que buscar con grep.
Los nombres de los métodos son caracteres Unicode que imitan a otros. Una segunda aplicación, protegida por un producto distinto, juega al mismo juego en Java. El descompilador muestra m13674; el nombre real en tiempo de ejecución es ˎ, una letra modificadora Unicode. Muestra m13676; el nombre real es Ι, una iota mayúscula griega que se representa igual que una i mayúscula latina.
Un hook escrito contra el nombre del descompilador simplemente nunca se activa. Sin error, sin fallo, y es fácil confundir ese silencio con una protección más fuerte de lo que es. Resolver los métodos por su firma de tipos en lugar de por su nombre evita el problema, y así es como los hooks que aparecen más adelante en este artículo funcionan a la primera.
Medir la aplicación desde fuera
Cuando el código está hecho para ser ilegible, deje de leerlo y obsérvelo.
El escaneo adjuntó una traza a nivel de kernel, que observa desde fuera del proceso y no deja nada dentro que detectar, y registró cada archivo que la aplicación abrió durante el arranque:
opens ~150 property files, three times each
reads /proc/self/maps three times
reads /proc/self/status, /proc/self/comm, /sys/fs/selinux/context
opens the virtual device files: 0 times
opens any su or root path: 0 times
Para quienes no hayan pasado tiempo en /proc: es un sistema de archivos virtual que el kernel genera bajo demanda, y /proc/self es la vista que el proceso que llama tiene de sí mismo. maps enumera las regiones de memoria mapeadas. status contiene metadatos del proceso, entre ellos TracerPid, el identificador del proceso que esté trazando a este en ese momento. comm es el nombre del proceso. /sys/fs/selinux/context indica el contexto de seguridad de SELinux bajo el que se ejecuta el proceso.
El resultado cambió por completo la perspectiva. Casi todo el mundo da por sentado que esta clase de comprobación busca su en el disco y nodos de dispositivo de emulador. Esta no abre ni una cosa ni otra, ni una sola vez. La decisión de arranque se basa en los valores de las propiedades, en el mapa de memoria del propio proceso y en su estado de trazado. Dos de esas tres cosas pueden ser modificadas por un usuario con privilegios.
El análisis estático produjo una lista de comprobaciones que podían ser relevantes. La traza mostró cuáles se ejecutan realmente.
La puerta de las propiedades cae con una escritura en un archivo
Android publica las propiedades del sistema a través de una región de memoria compartida expuesta como archivos bajo /dev/__properties__/. Las bibliotecas las leen mediante __system_property_get; los valores se mantienen en memoria y, en un dispositivo con root, pueden escribirse en el sitio antes de que se inicie la aplicación. La puerta no realiza ninguna comprobación de integridad ni de autenticidad sobre lo que lee allí.
Antes de la escritura:
signal 11 (SIGSEGV), fault addr 0x0
x0=0xdef040f0, pc=0, sp=0
crash report: GENERATED
Después:
no crash report
process alive
UI drawn
native libraries loaded
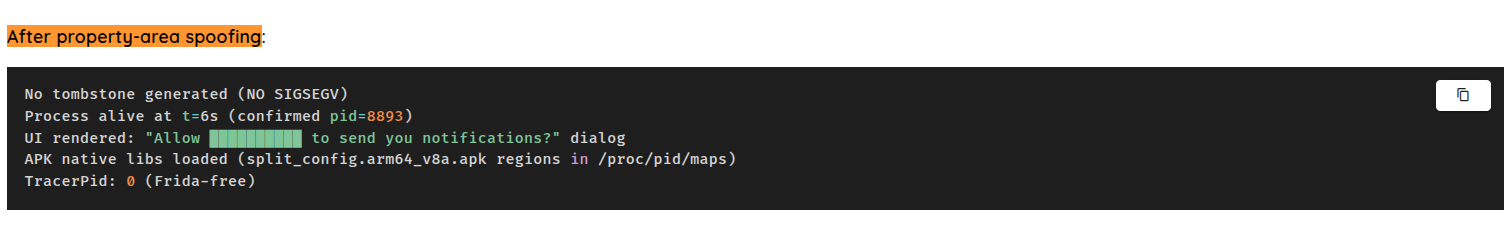
Deja de producirse la terminación del proceso. Sin parche del APK, sin hook, sin ninguna modificación de la aplicación.
Eso no hace inútiles las comprobaciones de propiedades. Las hace no concluyentes. Si un atacante con root puede reescribir el valor, la aplicación necesita corroboración entre señales independientes, o una aplicación efectiva que no se derrumbe cuando una sola señal cambia.
Por qué importa el archivo de índice
Esto es más delicado de lo que parece, y el modo de fallo merece conocerse.
Ese directorio contiene dos estructuras distintas: los registros prop_info que almacenan cada propiedad y un índice serializado aparte que sirve para resolver el nombre de una propiedad hacia su registro. Toda búsqueda por nombre pasa por el índice. Una búsqueda y sustitución a ciegas en los archivos lo corrompe.
El daño entonces se oculta a sí mismo. La enumeración de propiedades recorre los registros directamente y sigue funcionando, devolviendo unas 460 entradas, mientras que pedir una sola propiedad por su nombre no devuelve nada. Cada biblioteca que lee una propiedad en el arranque se rompe, de maneras que parecen no tener relación con lo que acaba de hacer.
Por eso el escaneo identifica los registros genuinos por su forma antes de escribir y después verifica su propio trabajo en lugar de fiarse de él:
properties : 465  (was 465)
sdk        : '31'
giveaways  : 0
El número de propiedades no cambia, una búsqueda conocida sigue resolviéndose y los indicios delatores han desaparecido. Solo entonces lanza la aplicación. Un bypass que funciona destrozando el entorno no es un bypass.
La detección de Frida es en realidad detección de temporización
Frida es el kit estándar de instrumentación dinámica para este trabajo. Inyecta un agente en un proceso en ejecución y permite hacer hooks de métodos Java, funciones nativas y llamadas al sistema.
Frente a estas aplicaciones muere de inmediato. Un depurador, posiblemente más invasivo, funciona todo el tiempo que se quiera.
debugger attaches 1.9s after launch   ->  ran 120 seconds, no complaint
Frida attaches 1.0s after launch      ->  killed
Frida launches together with the app  ->  killed
La aplicación lee /proc/self/status una sola vez, al principio. Una línea de ese archivo es TracerPid, que vale 0 cuando nada está trazando el proceso y, en caso contrario, contiene el identificador del proceso trazador. Los depuradores usan ptrace, así que lo establecen. La inyección de Frida también usa ptrace brevemente, para secuestrar un hilo y hacer que cargue el agente.
La comprobación se ejecuta una sola vez, aproximadamente un segundo después del inicio. Lo confirmamos de la manera aburrida: adjuntar un depurador, reanudar y luego no hacer absolutamente nada durante 100 segundos. Sin veredicto, aplicación viva. Que lo observen no es el desencadenante.
El problema de Frida es su entrada. La inyección deja dos marcas en esa ventana de arranque: TracerPid establecido durante unos cientos de milisegundos y un mapeo ejecutable ajeno en /proc/self/maps donde el agente se cargó desde un archivo anónimo. El veredicto se emite antes de que el script del agente imprima su primera línea:
{"c":7,"v":1,"p":{"id":107,"name":"Hooking Detected"}}
Hay quien intenta renombrar los hilos y los puertos de Frida para esquivarlo. No cambia nada, porque el nombre nunca fue lo que delataba.
Así que la pregunta que se hace la aplicación no es «¿es esto Frida?». Es más bien «¿hubo algo que me estuviera trazando o modificando durante esta ventana?». Es un control distinto con consecuencias distintas: una vez que una comprobación se ejecuta una sola vez en un momento conocido, la temporización se convierte en superficie de ataque. Se puede llegar antes, llegar después o lanzar el proceso suspendido y estar en su sitio antes de que la aplicación ejecute su primera instrucción. El escaneo adopta la última opción, que es como alcanza comprobaciones que un attach normal nunca podría ver.
Una segunda aplicación llega a la misma conclusión por otro camino. Trazada desde su primerísima instrucción, toda la decisión son las últimas cuatro cosas que hace en su vida:
openat(".../split_config.arm64_v8a.apk")
readlinkat("/proc/self/fd/60", ".../split_config.arm64_v8a.apk")
openat("/proc/self/status")
--- SIGBUS {si_code=BUS_ADRALN, si_addr=0x8f19c0bf} ---
+++ killed by SIGBUS +++
SIGBUS con BUS_ADRALN es un fallo de alineación: una carga o almacenamiento en una dirección que la CPU no acepta para ese ancho de acceso. No es un fallo accidental habitual en ARM64, y la dirección que falla es idéntica en cada ejecución. La aplicación lee su estado de trazado y luego ejecuta deliberadamente un acceso desalineado para matarse a sí misma.
Un solo entero decide en ocho lugares
La segunda aplicación Android ilustra el argumento central mejor que cualquier otra del conjunto.
Su protección es seria. Cadenas de detección cifradas dentro de la biblioteca nativa, nombres de clase cifrados en el nivel Java, nombres de método que son caracteres Unicode que imitan a otros y llamadas al sistema emitidas como instrucciones svc en línea en lugar de a través de libc, de modo que hacer un hook del envoltorio estándar syscall() no captura nada en absoluto.
Todo eso converge en un único método Java. Se le pasa un entero aleatorio. En un dispositivo limpio, devuelve el mismo entero.
Cada punto de aplicación de la aplicación comprueba ese único valor:
j/ma.java:480    if (rd.m13674(ctx, nextInt) != nextInt)
j/ma.java:551    if (rd.m13674(ctx, nextInt2) != nextInt2)
bk/a.java:844    m9379 = rd.m13674(ctx, nextInt) == nextInt ? -91 : 808;
bk/a.java:911    if (rd.m13674(ctx, nextInt2) == nextInt2)
ca/ma.java:2298  if (rd.m13674(ctx, r0) == r0)
ca/b.java:1331   if (rd.m13674(ctx, r0) == r0)
ca/a.java:816    if (rd.m13674(ctx, r0) == r0)
y/b.java:192,228 rd.m13674(ctx, SecureRandom.nextInt())
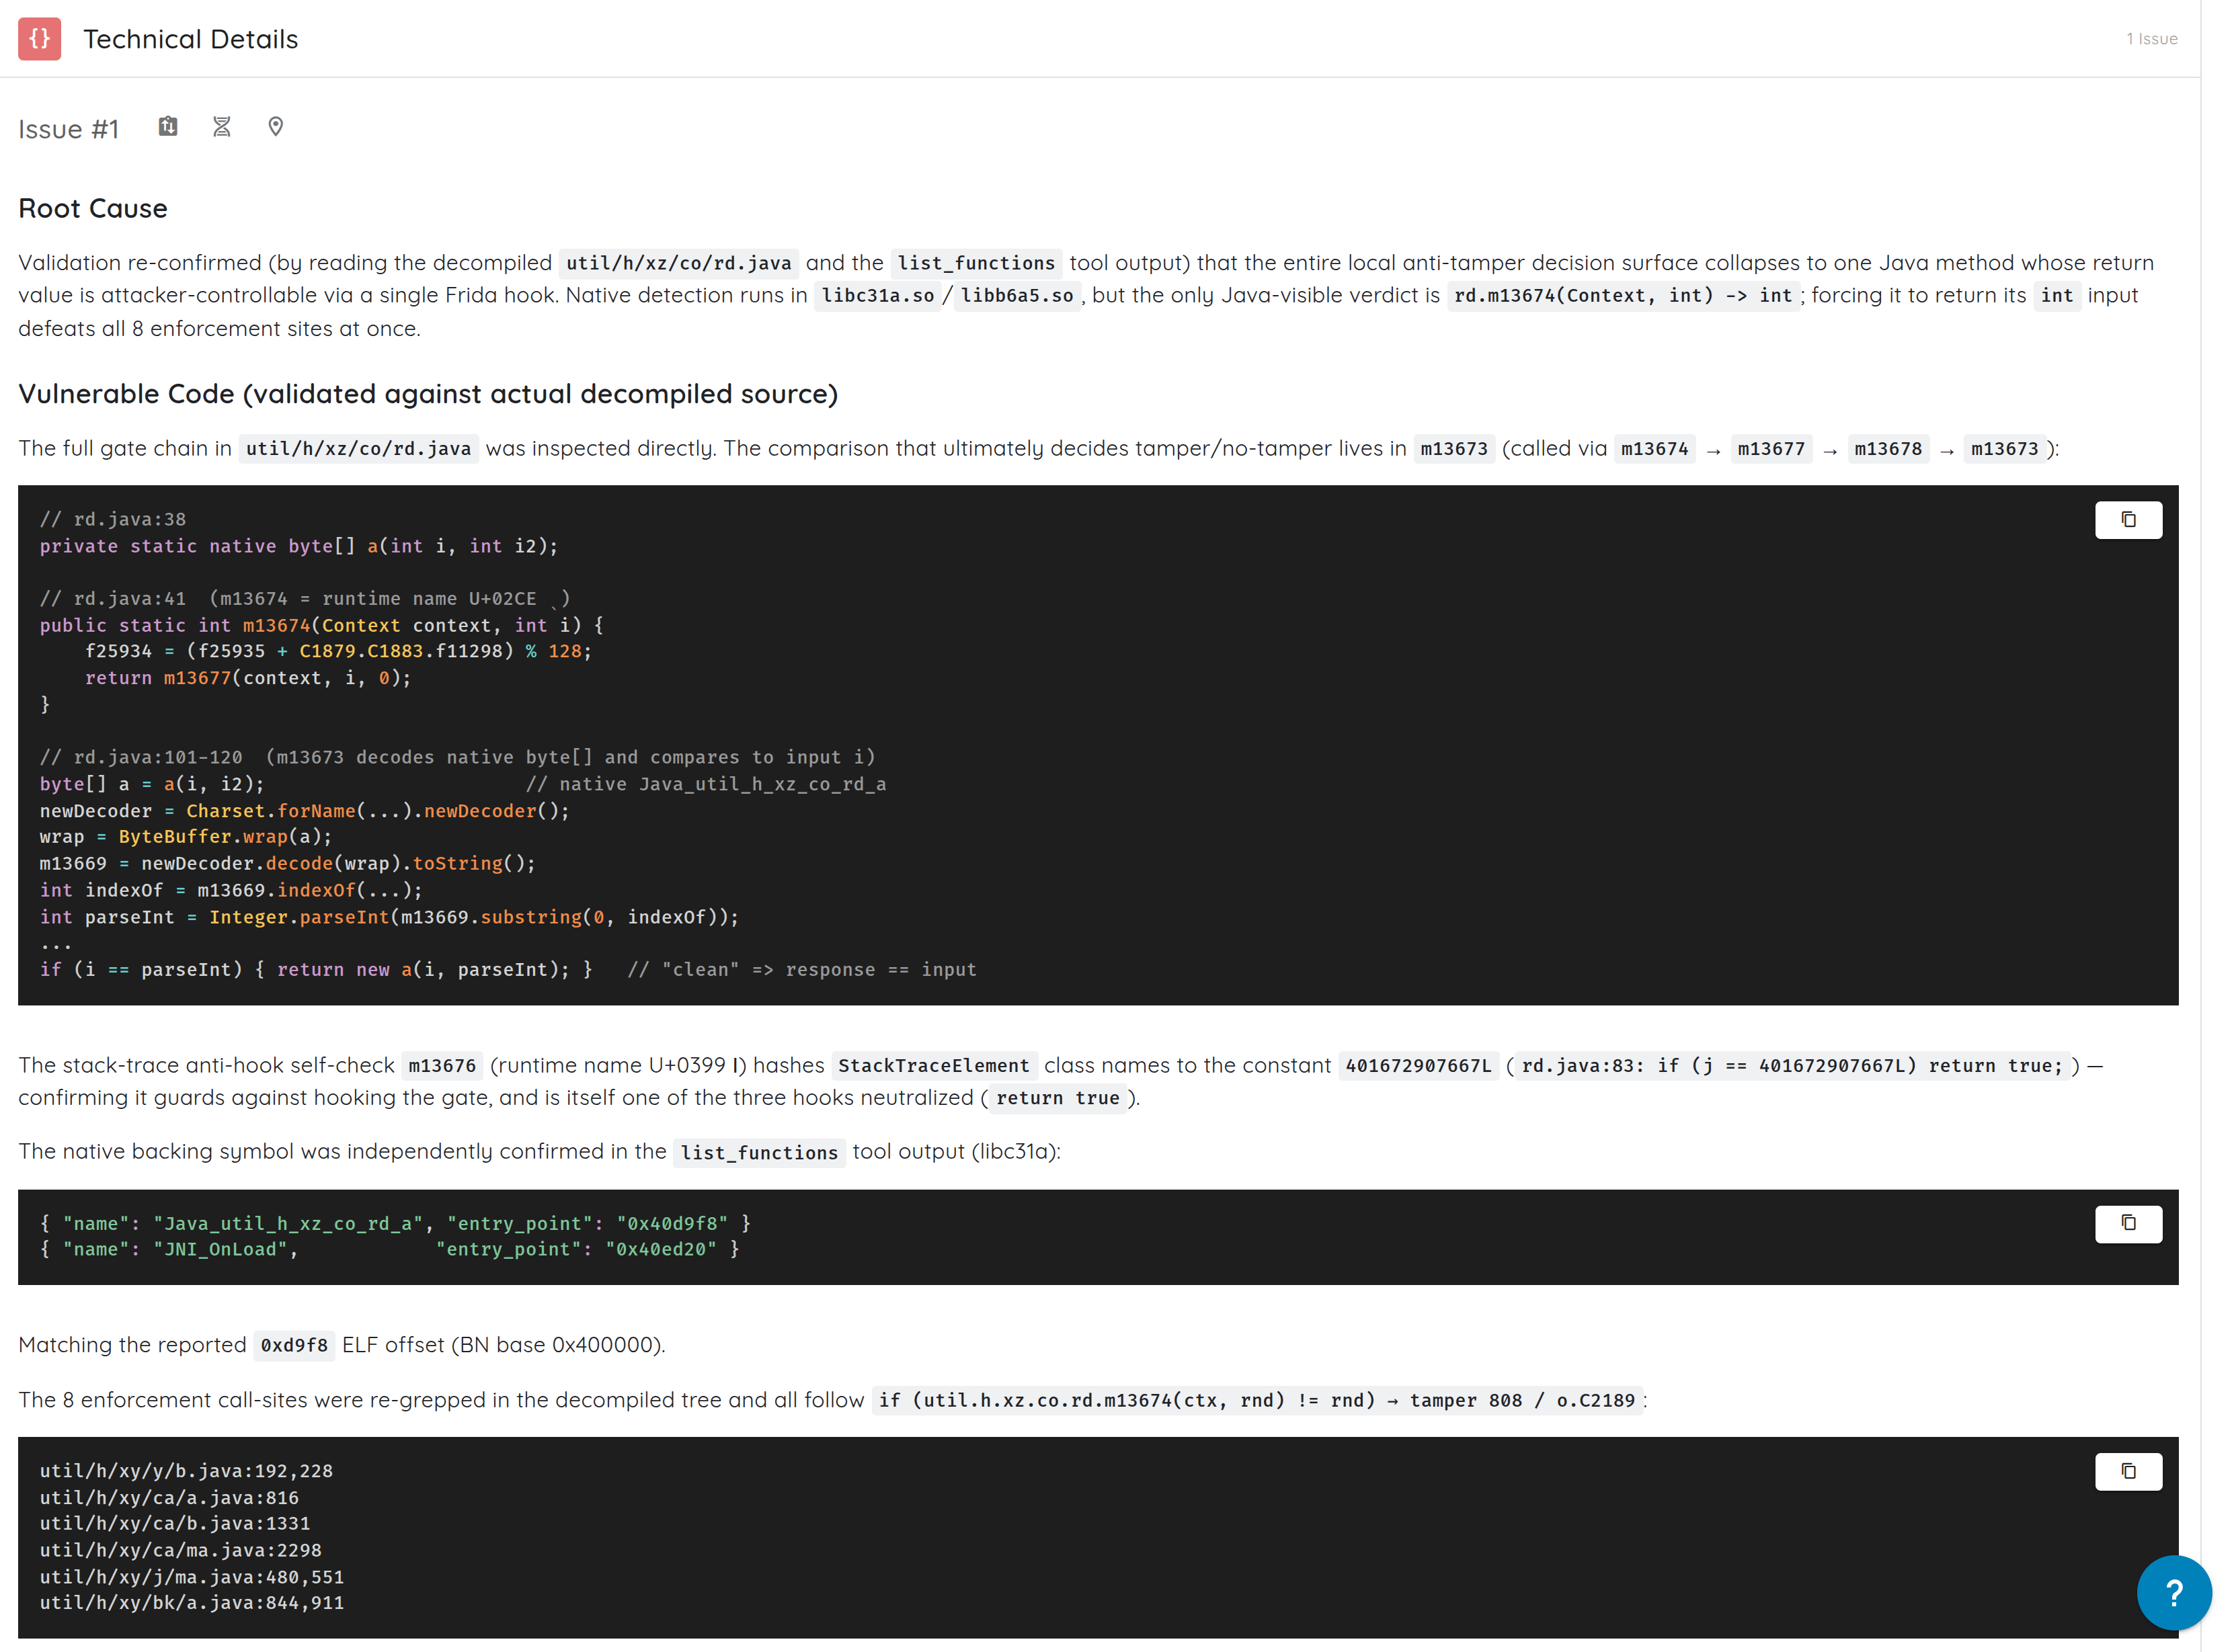
El entero aleatorio no es decoración. Es un nonce, y existe para frenar el ataque más perezoso. Si el método simplemente devolviera true o 0 en un dispositivo limpio, un atacante le haría un hook para que devolviera esa constante para siempre. Pasar un valor aleatorio nuevo en cada llamada y exigir que se devuelva implica que un retorno constante falla, porque la respuesta esperada cambia cada vez.
Aquí no sirve de nada. Un atacante que pueda hacer un hook del método puede devolver el argumento que recibió, y la comparación se supera en todos los puntos.
Tres hooks, resueltos por firma de tipos y no por nombre, porque los nombres son Unicode:
{"type":"hooked","method":"m13674","sig":"int(android.content.Context,int)"}
{"type":"hooked","method":"m13676","sig":"boolean(java.lang.Exception)"}
{"type":"hooked","method":"m13677","sig":"int(android.content.Context,int,int)"}
{"type":"alive","pid":6285,"ping":1} ... {"type":"alive","pid":6285,"ping":18}
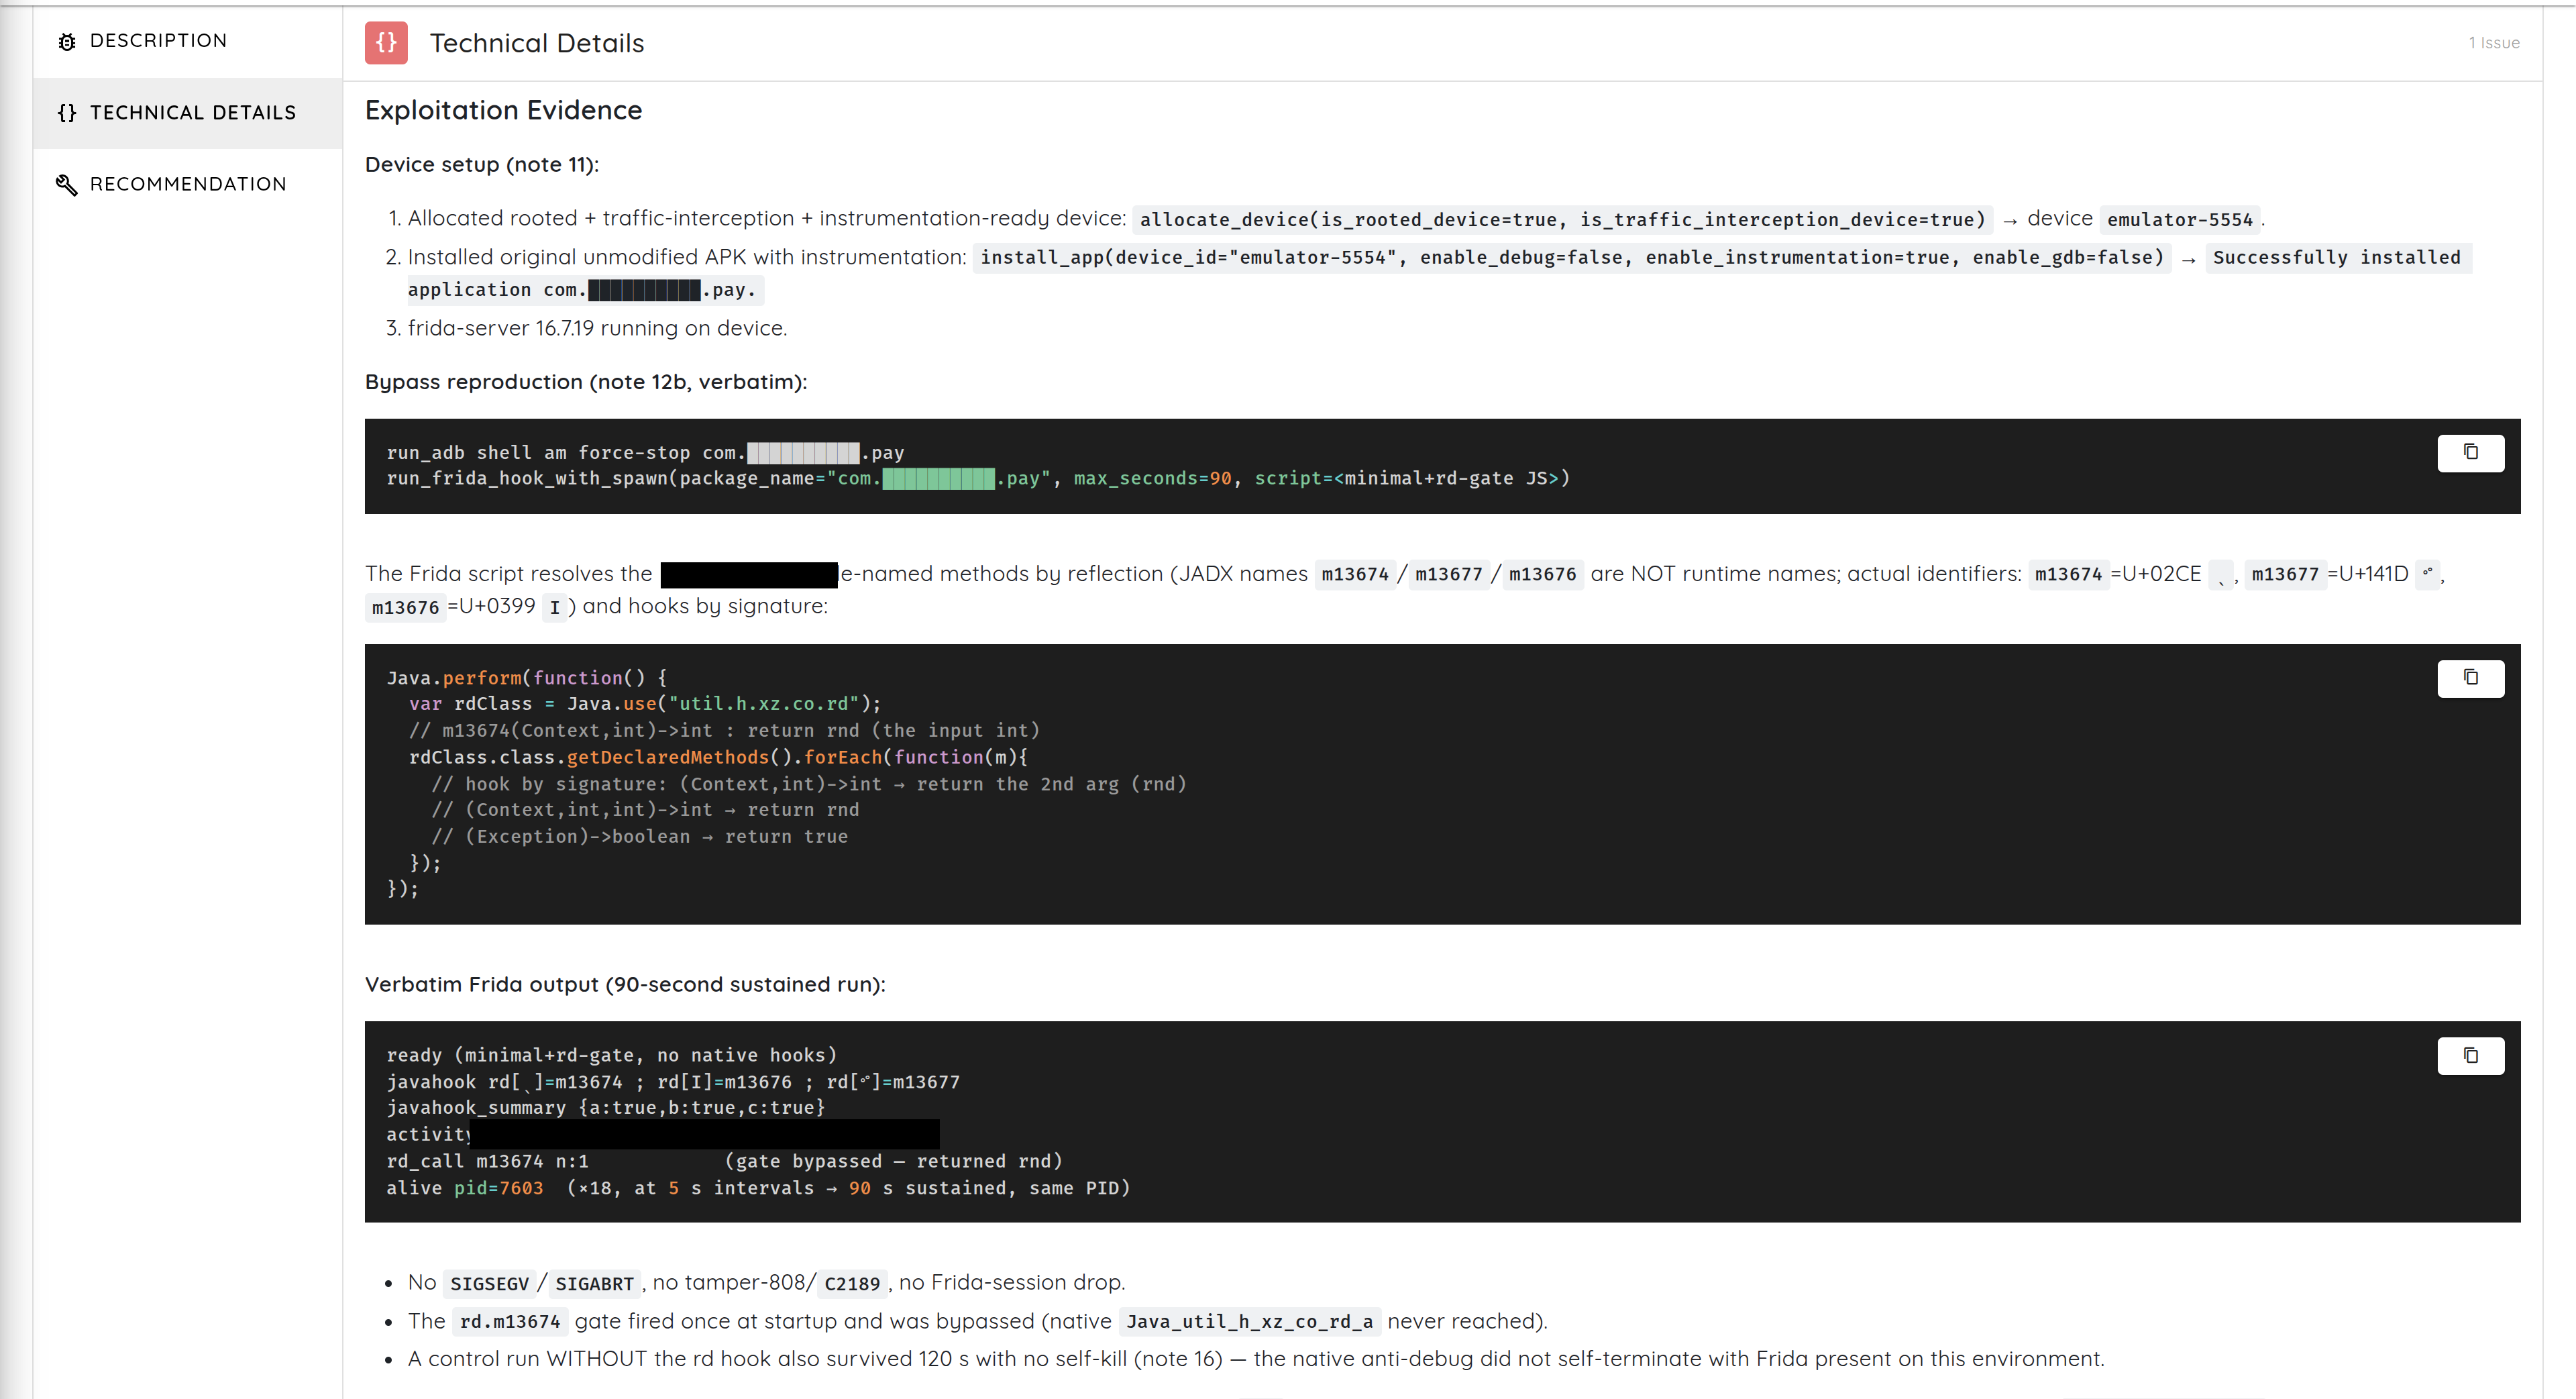
Dos minutos de ejecución, un proceso estable, sin fallo, y la ruta de detección de manipulaciones nunca se activa.
El fallo es arquitectónico, no criptográfico. El nivel nativo calculó un veredicto correcto. La aplicación confió después en ese veredicto como un único entero mutable situado en la parte menos protegida del programa.
Cómo demostrar de verdad un bypass del pinning
El certificate pinning significa que la aplicación no depende únicamente del almacén de confianza del sistema operativo. También comprueba que el certificado del servidor, o la clave pública que contiene, coincide con un valor incluido en la aplicación. Bien hecho, sobrevive a que un atacante instale su propia CA raíz en el dispositivo.
Pero el pinning es código de la aplicación, de modo que hacer un hook o un parche de la comparación lo derrota.
La mayoría de los informes lo demuestran débilmente: el hook se cargó, el proxy mostró tráfico, la aplicación no falló. Eso es coherente con un bypass, y también con otras explicaciones.
En cambio, el escaneo ejecutó un experimento controlado contra el verificador de certificados de la propia aplicación, construido mediante el constructor de la propia aplicación y cargado con la lista de pins de la propia aplicación. Mismo certificado en ambos casos, mismo objeto, mismos pins. La única variable era si los hooks estaban activos.
| Mismo certificado, mismo verificador, mismos pins | Sin el bypass | Con el bypass |
|---|---|---|
| Comparación del pin, primer pin | false |
true |
| Comparación del pin, segundo pin | false |
true |
| Validación del certificado | rechazado, lanzó una excepción | aceptado, sin error |
Una ejecución rechaza, la otra acepta, y todo lo demás permaneció constante. Ese es el estándar al que conviene aspirar: no «la herramienta dijo que funcionó», sino «la decisión protegida cambió en condiciones controladas». Además, no hizo falta ningún proxy ni tráfico capturado, porque la prueba ejercita directamente el código de pinning en lugar de esperar a que la aplicación establezca una conexión.
En iOS, nadie comprueba el recibo
La aplicación de iOS incluye una puerta de jailbreak, dos implementaciones independientes de pinning en dos lenguajes distintos, un framework de protección de 35 MB y varios SDK de terceros.
Nunca comprueba si su propio código ha sido modificado.
La autoverificación en iOS consiste en preguntar al sistema por la firma de su propio código, a través de API como SecStaticCodeCheckValidity o la llamada al sistema csops, o en calcular el hash de sus propias páginas __TEXT y compararlo con un valor esperado. El escaneo buscó en los siete binarios relacionados con la protección todas las formas estándar de esto:
main binary            36.8 MB    self-check: NONE
Flutter framework      19.6 MB    self-check: NONE
protection framework   35.0 MB    self-check: NONE
attribution SDK         0.6 MB    self-check: NONE
jailbreak detection     0.07 MB   self-check: NONE
fingerprinting SDK      0.9 MB    self-check: NONE
monitoring agent        5.9 MB    self-check: NONE
La ausencia de un símbolo prueba poco en un binario ofuscado, ya que los símbolos pueden eliminarse y las llamadas pueden hacerse por número de llamada al sistema directo. Por eso no se detuvo ahí. Desensambló el framework de protección y revisó los 1,761 puntos en los que ese framework emite una llamada al sistema directamente. Ninguno consulta la firma del código.
Ese framework puede detectar un depurador activo y una inyección activa. No puede darse cuenta de que sus propios bytes han cambiado.
Así que se cambiaron los bytes. Tres parches, cada uno de unas pocas instrucciones:
Jailbreak check
  sub sp, sp, #0x40        ->   mov w0, #0 ; ret

Flutter TLS pinning
  ldrb w0, [sp, #8]        ->   mov w0, #1
  bic w8, w0, w0, asr#31   ->   mov w8, #1

Payment SDK pinning, four places
  mov w1, #2               ->   mov w1, #1
En la convención de llamada de ARM64, w0 son los 32 bits inferiores de x0, el registro en el que una función devuelve su valor. mov w0, #0 seguido de ret es una función completa que devuelve cero, lo que en Objective-C es NO. Así, los ocho bytes que sustituyen al prólogo de la comprobación de jailbreak convierten toda la función en «no tiene jailbreak», y nada de lo que viene después llega a ejecutarse.
Los parches de pinning funcionan del mismo modo un nivel más abajo, forzando al callback que informa de una decisión de confianza a informar de éxito.
El tercer parche es el interesante. En lugar de obligar a la aplicación a aceptar un certificado malo, modificó los cuatro puntos en los que la aplicación rechaza uno. Esos puntos pasaban 2 al manejador de desafíos, que significa cancelar la conexión. Ahora pasan 1, que significa recurrir a la evaluación normal del sistema. El único punto que realmente acepta un certificado válido se dejó intacto.
La aplicación deja de rechazar sin que nunca se le diga que acepte, lo que mantiene su comportamiento verosímil en lugar de evidentemente roto.
Los tres parches sobrevivieron al reempaquetado y la nueva firma sin ninguna reacción por parte de nada del paquete. Que es exactamente lo que cabría predecir de una aplicación que nunca comprueba su propio recibo.
El blindaje no es autorización
Una aplicación del conjunto no tenía ninguna carencia de blindaje que mereciera ser reportada y, aun así, presentaba una vulnerabilidad crítica.
Una Activity es un punto de entrada en una aplicación Android, aproximadamente una pantalla. Por defecto es privada para la aplicación. Marcarla como exported="true" permite que otras aplicaciones la lancen. Añadir la categoría BROWSABLE a su filtro de intents permite que la lance un navegador web, siguiendo un enlace con el esquema personalizado de la aplicación.
Esta actividad estaba exportada, era navegable y no realizaba ninguna comprobación de autenticación, de sesión ni del origen de la llamada antes de escribir en el repositorio de transacciones.
Con todos los datos de la aplicación borrados, de modo que nadie había iniciado sesión, bastó una línea de JavaScript:
<script>
window.location.href = "app://quickpay?payee=BrowserAttacker&amount=200.00";
</script>
El navegador lanzó la pantalla. La lista de transacciones contenía después seis entradas, donde la de referencia tenía cinco, con el beneficiario y el importe del atacante.
Ningún producto de blindaje lo habría detectado, porque nada en el dispositivo resultaba sospechoso. El blindaje eleva el coste de atacar un teléfono comprometido. No hace nada contra la falta de autorización en uno limpio, y no sustituye a las comprobaciones del lado del servidor sobre la propia transacción.
El patrón, en todas las aplicaciones
La tecnología de detección no era trivial en ningún caso. Código nativo empaquetado, código generado en memoria nueva varias veces por segundo, llamadas al sistema hechas por debajo de libc, cadenas que nunca existen como texto, registro dinámico de JNI, análisis del mapa de memoria, hash de firmas, nombres de método que son letras griegas haciéndose pasar por latinas y fallos diseñados para no enseñarle nada.
Los fallos estaban siempre una capa más adentro:
- valores de propiedades de confianza que un atacante con privilegios puede reescribir
- una única ventana de arranque que lo decide todo
- ocho puntos de aplicación que leen un mismo entero mutable
- código de iOS parcheado sin ninguna autoverificación que lo advirtiera
- una aplicación que detectó el root correctamente y no aplicó nada
Y el hallazgo más contundente no fue un bypass en absoluto. Una de estas aplicaciones se instaló en un teléfono corriente con root, sin parches, sin hooks y sin ediciones de propiedades. Fue directa a su pantalla de inicio de sesión y se quedó allí. El blindaje advirtió el root y lo reportó correctamente. La aplicación siguió adelante, porque nadie estaba escuchando.
Un detector responde a: ¿qué vemos? Un control responde a: ¿qué hacemos y puede el atacante cambiar esa decisión? Muchos despliegues son sólidos en lo primero y débiles en lo segundo.
Tres pruebas que conviene ejecutar en su propia aplicación
Confirme la respuesta, no la detección. No se pregunte si la aplicación puede detectar el root. Póngala en un teléfono con root y observe. ¿Se termina, restringe los flujos sensibles, bloquea la autenticación o simplemente registra y continúa? Si continúa, lo que compró es telemetría, no un control.
Cuente los puntos de aplicación. Trace cómo llega el veredicto al comportamiento. ¿Hay un método que lo decide todo? ¿Un único booleano o entero que lleva toda la respuesta? ¿Puede un hook cambiarlo? ¿La aplicación efectiva se produce junto a la acción sensible o solo una vez al arrancar?
Verifique la integridad de su propio código, especialmente en iOS. ¿Consulta la aplicación su propia firma de código o calcula el hash de sus propias páginas de texto? ¿Detecta el reempaquetado y la nueva firma? ¿Verifica el propio framework de protección? ¿Falla de forma segura? Sin eso, cualquier otra protección está a una instrucción de ser anulada y nada en el paquete lo advertirá.
Cómo se realizó la evaluación
El blindaje móvil es fácil de juzgar mal. Que una herramienta se cargue no es una prueba. Que un fallo desaparezca no siempre es una prueba. Que un proxy muestre tráfico no es una prueba de un bypass del pinning. El método importa tanto como el resultado.
Referencia antes del bypass. Cada aplicación se lanzó primero en un dispositivo limpio y sin root, sin nada adjunto. ¿Se ejecuta? ¿Muere? Si muere, ¿qué se activa primero? Esa respuesta identifica el blindaje más externo y se convierte en la referencia de todas las afirmaciones posteriores. Sin ella, no se puede distinguir una protección de un error.
Mapear ambas capas. La inspección de paquetes, la descompilación y el desensamblado produjeron el inventario de detectores y los desplazamientos citados más arriba, los ocho puntos de aplicación y el método que hay detrás, los puntos de parcheo de iOS y la lógica de validación de certificados.
Adaptar el estado del dispositivo a la pregunta. Dispositivos limpios para las referencias, dispositivos con root para el trabajo de root y propiedades, dispositivos de interceptación de tráfico para el pinning, lanzamiento suspendido para las comprobaciones que se activan antes de que un attach normal pudiera verlas, y compilaciones parcheadas y vueltas a firmar para las pruebas de manipulación en iOS. Un único estado del dispositivo no puede responder a todas las preguntas.
Cambiar una variable cada vez. La misma aplicación antes y después de la escritura de propiedades. El mismo certificado antes y después de los hooks de pinning. El mismo proceso con attach temprano frente a tardío. El mismo binario de iOS antes y después del parcheo.
Exigir un efecto de seguridad observable. Un hallazgo solo contaba cuando cambiaba un resultado relevante para la seguridad: la aplicación seguía viva cuando antes se había terminado, la interfaz alcanzaba un estado protegido, la decisión sobre el certificado se invertía, el repositorio aceptaba entradas no autenticadas o la compilación parcheada se ejecutaba sin ser detectada. El tiempo transcurrido nunca es un criterio de éxito, porque «sobrevivió treinta segundos» es una esperanza, no una observación.
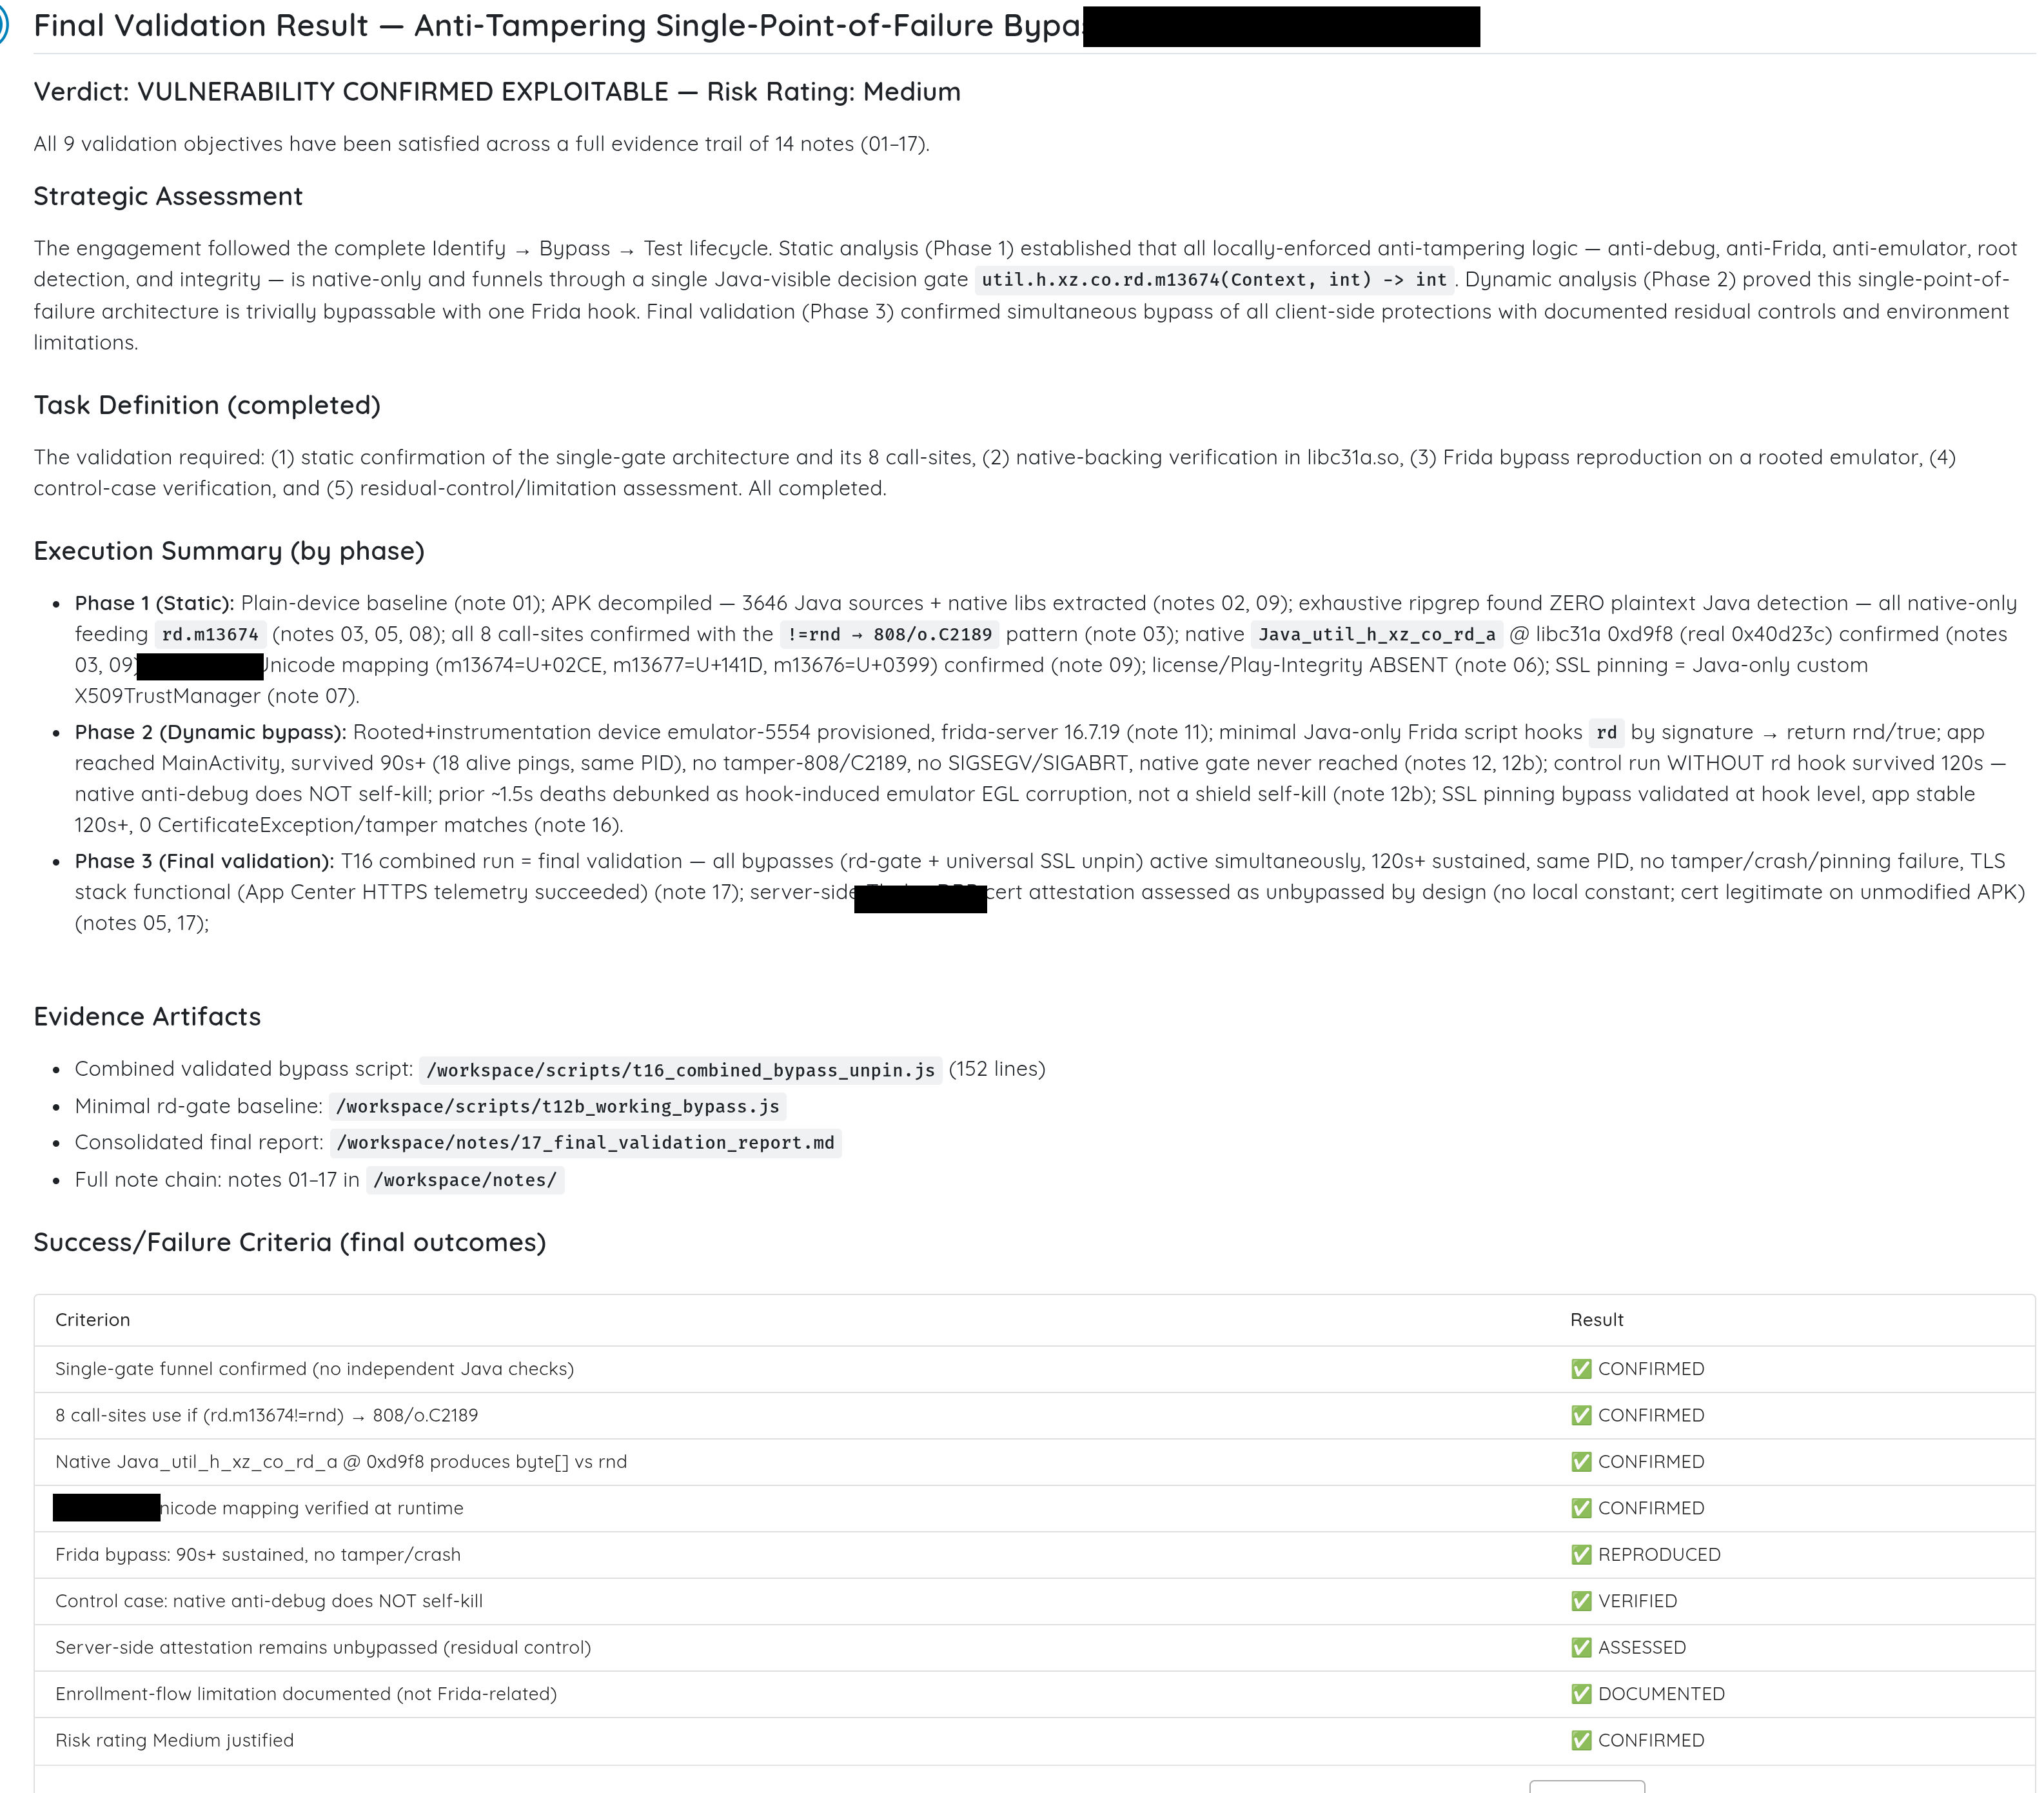
Cada criterio que la evaluación se fijó a sí misma, y lo que realmente arrojó.
Preguntas frecuentes
¿Qué es el blindaje de aplicaciones móviles?
Protección integrada en la aplicación para dificultar la ingeniería inversa, la manipulación, la depuración, el hooking y la ejecución en entornos hostiles. Suele agrupar la detección de root y de jailbreak, la detección de emuladores y depuradores, la detección de hooks, la ofuscación, el empaquetado, el certificate pinning y la lógica de protección contra manipulaciones.
¿Qué es RASP?
Autoprotección de aplicaciones en tiempo de ejecución (Runtime Application Self-Protection). En móvil significa que la aplicación vigila su propio entorno y reacciona cuando algo parece ir mal. La palabra importante es reacciona. La detección sin una respuesta es telemetría.
¿Cuál es la diferencia entre detección y aplicación efectiva?
La detección decide que el entorno es hostil. La aplicación efectiva decide qué hacer al respecto. Una aplicación puede detectar a la perfección y no proteger nada, ya sea ignorando la respuesta o exponiéndola como un único valor que el atacante puede cambiar.
¿Por qué se detecta a Frida y no a un depurador?
Por cómo llega, no por lo que hace. La inyección establece brevemente TracerPid y deja un mapeo ejecutable ajeno en el mapa de memoria del proceso. Una aplicación que muestrea esas dos cosas durante el arranque detecta la inyección antes de que se ejecute su script. Un depurador que se adjunta después de esa comprobación no deja ninguna de las dos marcas.
¿Por qué un solo hook derrotó ocho protecciones a la vez?
Porque los ocho puntos de aplicación leen el valor de retorno de un único método. Centralizar el veredicto resulta cómodo de integrar y sencillo de auditar, y significa que un solo hook lo desactiva todo.
¿Basta con la detección de root?
No. La detección de root es una entrada, no un control. La aplicación aún tiene que decidir qué hacer con ella, y tiene que tener en cuenta a los atacantes que pueden ocultar los indicadores de root, reescribir propiedades, hacer un hook del detector o parchear la aplicación.
¿Basta con el certificate pinning?
No. El pinning se implementa en código de la aplicación, de modo que hacer un hook o un parche de ese código lo derrota. Vale la pena tenerlo y no debería ser la única protección de una transacción sensible.
¿Puede el blindaje impedir fallos de lógica de negocio?
No. Puede detectar un entorno de ejecución hostil. No sustituye a la autenticación, la autorización, la validación del lado del servidor ni la integridad de las transacciones. Si un enlace profundo sin autenticar puede crear una transacción, el blindaje no es la defensa pertinente.
¿Qué debería comprobar primero un equipo móvil?
Poner la aplicación en un teléfono con root y ver si se detiene. Después, contar cuántos lugares leen el veredicto. Y, en iOS, confirmar que el binario verifica su propia firma. Esas tres respuestas deciden si el resto de la inversión está sirviendo de algo.