9 herramientas de pentesting con IA de código abierto comparadas (2026)
Comparamos PentestGPT, PentAGI, HexStrike AI, Strix, CAI, Nebula, NeuroSploit, Deadend CLI y RedAmon: características clave de cada agente de pentesting con IA, estrellas de GitHub y licencias.
Idea clave
En nuestra prueba práctica contra la aplicación bancaria vulnbank, Strix y RedAmon produjeron los mejores resultados. RedAmon llegó más lejos, encadenando un fallo del lado del servidor hasta obtener acceso de administrador completo a la aplicación. CAI también encontró vulnerabilidades críticas, pero desde entonces se ha archivado. PentestGPT y Deadend CLI seguían usando OpenAI por defecto en lugar del modelo que configuramos, la configuración compleja de PentAGI nos impidió ejecutarlo, y NeuroSploit no logró iniciarse. HexStrike AI necesita un modelo de IA independiente, como Claude o GPT, para operarlo, y Nebula asiste a un probador humano en lugar de probar por sí solo.
Los escáneres automatizados son rápidos y fiables para detectar problemas conocidos. Lo que no pueden hacer es ver cómo se comporta realmente una aplicación, encadenar varias debilidades en un único ataque o ajustar su enfoque a mitad de la prueba como lo haría una persona.
Una nueva ola de herramientas de pentesting con IA de código abierto está diseñada para cerrar esa brecha. Usan modelos de lenguaje grandes para explorar una aplicación, decidir qué atacar a continuación y ajustarse sobre la marcha.
Pero el término herramientas de pentesting con IA abarca cosas muy distintas: algunas son agentes totalmente autónomos, una es un backend que solo funciona cuando lo opera un modelo independiente como Claude o GPT, y otra es un asistente para un probador humano en lugar de una herramienta independiente.
La documentación por sí sola rara vez muestra el rendimiento de estas herramientas, así que evaluamos cada una de forma práctica. Instalamos las nueve y las ejecutamos contra la misma aplicación vulnerable, vulnbank.org (RedAmon contra una copia alojada localmente). Para cada herramienta, este artículo cubre qué hace, cómo se ve su proyecto en GitHub y los resultados que produjo en las pruebas.
Sobre esta comparación
Esta comparación la publica Ostorlab, que desarrolla un producto comercial de pentesting con IA. Los propios productos de Ostorlab no están entre las nueve herramientas comparadas aquí. Las descripciones de las herramientas y las características clave se basan en el repositorio público de GitHub y la documentación de cada proyecto. Las métricas de GitHub y la información del proyecto reflejan los repositorios públicos a fecha del 6 de octubre de 2026; los valores relativos como «Último commit» son relativos a esa fecha.
Criterios de evaluación: métricas de GitHub (estrellas, commits, contribuyentes, último commit, licencia y pila tecnológica), características clave documentadas, y si cada herramienta podía configurarse y ejecutarse contra el objetivo de prueba, vulnbank.org, y qué hallazgos produjo.
Lista de herramientas de pentesting con IA de código abierto
- Pentest GPT
- PentAgi
- Hexstrike AI
- Strix
- Cybersecurity AI (CAI)
- Nebula
- Neurosploit
- Deadend CLI
- RedAmon
Comparación de métricas de GitHub
| Herramienta | Estrellas | Commits | Contribuyentes | Último commit | Licencia | Pila tecnológica |
|---|---|---|---|---|---|---|
| PentestGPT | 15.7k+ | 307+ | 24+ | ~hace 3 meses | MIT | Python (94%), Shell (4%) |
| PentAGI | 25.2k+ | 950+ | 17+ | ~hace 2 días | MIT | Go (61%), TypeScript (36%) |
| HexStrike AI | 12.4k+ | 63+ | 2+ | ~hace 2 meses | MIT | Python (100%) |
| Strix | 66.7k+ | 900+ | 74+ | hace < 24 horas | Apache-2.0 | Python (77%), Go (11%), TypeScript (9%) |
| CAI ⚠ (Archivado) |
9.8k+ | 1065+ | 93+ | Archivado (ago. 2026) | MIT (código del SDK de OpenAI) + solo uso de investigación (código de Alias Robotics) | Python (97%) |
| Nebula | 1.1k+ | 1468+ | 7+ | hace < 24 horas | BSD-2-Clause | Python (61%), TypeScript (32%) |
| NeuroSploit | 1.4k+ | 268+ | 5+ | ~hace 2 días | MIT | Rust (84%), JavaScript (10%) |
| Deadend CLI | 311+ | 386+ | 5+ | ~hace 2 meses | AGPL-3.0 | Python (77%), Jinja (12%), TypeScript (7%) |
| RedAmon | 2.9k+ | 1343+ | 21+ | hace < 24 horas | MIT | Python (58%), TypeScript (36%) |
1. PentestGPT
PentestGPT es un marco de código abierto diseñado para automatizar partes del proceso de pruebas de penetración usando modelos de lenguaje grandes (LLM).
La herramienta utiliza tres módulos que interactúan para automatizar cadenas de ataque mientras mantiene el seguimiento del progreso general de la prueba:
Módulo de razonamiento: Actúa como el estratega principal. Mantiene un «árbol de tareas» para gestionar la visión de conjunto y decidir el siguiente paso lógico del ataque.
Módulo de generación: Funciona como el ejecutor. Toma la estrategia del módulo de razonamiento y crea los comandos de terminal o scripts específicos necesarios para realizar la tarea.
Módulo de análisis: Actúa como el analista de datos. Limpia la salida bruta y desordenada de las herramientas de seguridad, extrayendo solo los hallazgos más importantes para introducirlos de nuevo en el sistema.
Mediante este sistema de tres partes, PentestGPT puede gestionar ataques complejos y de múltiples etapas sin perder el rastro de resultados anteriores ni quedarse atascado en bucles repetitivos.
Características clave:
Las características de PentestGPT están diseñadas para automatizar las partes más difíciles de una prueba de penetración:
Motor de razonamiento automatizado: La plataforma utiliza la lógica de modelos de lenguaje grandes para resolver tareas complejas de pruebas de penetración y desafíos Capture The Flag (CTF).
Seguimiento dinámico de sesión: El sistema ofrece un recorrido en vivo que registra y muestra cada paso del proceso de pruebas en tiempo real.
Soporte de seguridad multidominio: Cubre múltiples categorías especializadas, incluyendo seguridad web, criptografía, ingeniería inversa, informática forense y explotación binaria (PWN).
Monitoreo de actividad en vivo: Los usuarios pueden observar el razonamiento y el progreso del agente mediante un bucle continuo de retroalimentación en tiempo real.
Diseño de marco modular: La arquitectura extensible permite la integración de nuevas herramientas de seguridad y módulos de prueba personalizados.
PentestGPT sufre de una documentación limitada y poco clara. Durante la configuración, intentamos ejecutarlo a través de OpenRouter usando un proveedor específico (MoonshotAI), pero la herramienta seguía usando por defecto el proveedor OpenAI. Después de forzar manualmente el cambio de proveedor a MoonshotAI, la herramienta se bloqueó durante la inicialización y permaneció sin respuesta durante un periodo prolongado, lo que impidió una prueba efectiva.
2. PentAGI
PentAGI es un sistema de código abierto y autónomo que coordina múltiples agentes de IA para realizar pruebas de seguridad complejas. Utiliza un enfoque «multiagente», en el que roles de IA especializados, como investigación, codificación e infraestructura, trabajan juntos para descubrir, analizar y explotar vulnerabilidades de forma independiente. La herramienta ejecuta todas las tareas en un entorno Docker seguro y aislado, usando su propio navegador y sistemas de búsqueda para recopilar inteligencia en tiempo real y adaptar su estrategia de ataque sin intervención humana.
Características clave:
Estas son las principales características que ofrece PentAGI:
Agente totalmente autónomo: Un sistema impulsado por IA que determina y ejecuta automáticamente los siguientes pasos en una prueba de penetración sin ayuda humana.
Sandboxing seguro: Todas las operaciones se ejecutan dentro de un entorno Docker aislado para mantener seguro el sistema anfitrión y evitar cualquier daño accidental.
Suite de seguridad integrada: Incluye más de 20 herramientas profesionales (como Nmap, Metasploit y Sqlmap) que la IA puede ejecutar e interpretar por sí sola.
Memoria y búsqueda inteligentes: Usa un sistema de memoria a largo plazo para almacenar investigaciones y se integra con motores de búsqueda web para encontrar los datos de CVE más recientes.
Equipo de especialistas: Usa un sistema de «delegación» en el que distintos agentes de IA se centran en tareas específicas como investigación, codificación o infraestructura.
Panel web moderno: Cuenta con una interfaz limpia y registros detallados para que pueda monitorear el progreso y los hallazgos de la IA en tiempo real.
Pentagi tiene una configuración larga y compleja, con documentación limitada e instrucciones poco claras, lo que dificultó ejecutar la herramienta contra vulnbank.org.
3. HexStrike AI
HexStrike AI es un servidor MCP que conecta LLM con más de 150 herramientas de seguridad. Permite que los agentes de IA ejecuten sus propias pruebas de penetración, encuentren vulnerabilidades y automaticen tareas de bug bounty sin intervención manual. En esencia, le da a modelos como Claude y GPT un conjunto de herramientas «prácticas» para realizar trabajo de seguridad ofensiva.
Características clave:
HexStrike AI MCP usa una arquitectura multiagente para gestionar las pruebas autónomas y los datos de vulnerabilidades.
Conexión de agentes: Modelos como Claude y GPT se conectan a través del protocolo FastMCP para ejecutar comandos.
Análisis de objetivos: El motor de decisión evalúa los objetivos para seleccionar estrategias y herramientas de prueba específicas.
Ejecución autónoma: Los agentes realizan evaluaciones de seguridad en distintos entornos sin intervención manual.
Adaptación del sistema: La plataforma actualiza su lógica de prueba en tiempo real según los resultados y las vulnerabilidades encontradas.
Informes técnicos: El sistema genera fichas de vulnerabilidades y datos de análisis de riesgo para el resultado final.
HexStrike AI es un servidor MCP, no un motor independiente. Necesita un cliente de IA externo como Claude o GPT para operarlo, por lo que no lo ejecutamos contra vulnbank.org como probador autónomo.
4. Strix
Strix es un marco de agentes autónomos diseñado para simular el comportamiento de un atacante humano ejecutando código en entornos dinámicos. Identifica fallos de seguridad y confirma su validez generando exploits de prueba de concepto funcionales. Este enfoque proporciona a los desarrolladores y equipos de seguridad resultados verificados, reduciendo el esfuerzo manual necesario para las pruebas de penetración y el ruido normalmente asociado con el escaneo estático.
Características clave:
Seguridad de aplicaciones automatizada: Strix utiliza un conjunto de herramientas de hacking integrado para detectar y validar dinámicamente vulnerabilidades críticas en su código. Al ejecutar las aplicaciones en tiempo real, encuentra fallos en tiempo de ejecución que las herramientas estáticas pasan por alto y los confirma con evidencia de prueba de concepto.
Pentesting rápido bajo demanda: Al desplegar equipos de agentes que colaboran entre sí, el sistema escala en infraestructuras completas para completar pruebas de penetración en horas en lugar de semanas. Esta escala autónoma permite a las organizaciones generar informes listos para auditoría y análisis de riesgo bajo demanda.
Investigación y validación de bug bounty: La plataforma automatiza todo el proceso de búsqueda de errores, desde el descubrimiento inicial hasta la generación de exploits. Elimina la sobrecarga manual de la investigación al encontrar errores de forma autónoma y crear las pruebas de concepto funcionales necesarias para informes y recompensas más rápidos.
Integración con DevSecOps y CI/CD: Una CLI orientada al desarrollador permite una integración fluida en los pipelines de CI/CD. Esto permite que el sistema bloquee de forma autónoma las vulnerabilidades antes de que lleguen a producción, ofreciendo sugerencias de corrección automática e informes accionables directamente al equipo de ingeniería.
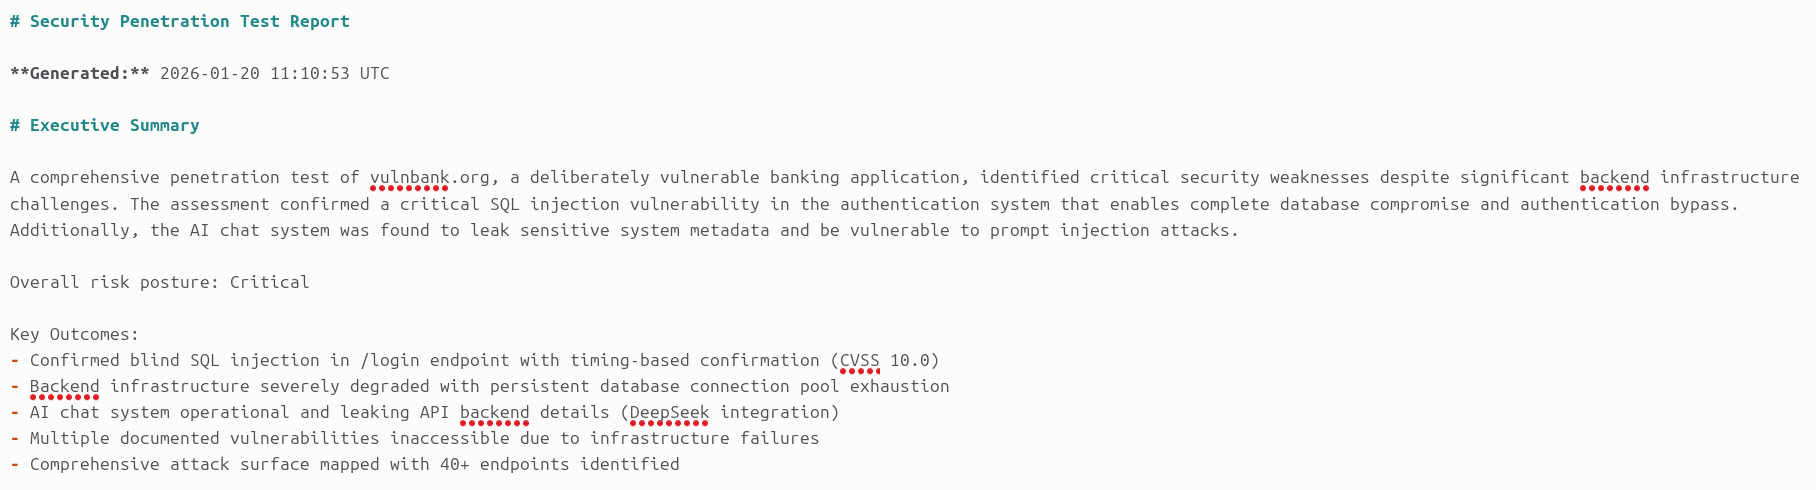
Ejecutamos el marco Strix contra vulnbank.org e identificamos múltiples vulnerabilidades críticas, entre ellas:
- Inyección SQL ciega confirmada en el endpoint /login con confirmación basada en tiempos. (CVSS 10.0)
- Infraestructura backend severamente degradada con agotamiento persistente del pool de conexiones a la base de datos.
- Sistema de chat de IA operativo que filtra detalles del backend de la API. (integración con DeepSeek)
- Múltiples vulnerabilidades documentadas inaccesibles debido a fallos de infraestructura.
- Superficie de ataque integral mapeada con más de 40 endpoints identificados.
5. Cybersecurity AI (CAI)
⚠ Actualización (octubre de 2026): Desde nuestra prueba, CAI ha sido archivado y relicenciado. Solo el código que tomó prestado del SDK de Agents de OpenAI sigue siendo MIT; todo lo escrito por Alias Robotics, la empresa detrás de CAI, es ahora solo para uso de investigación, sin permitirse ningún uso comercial o de producción sin una licencia comercial. Todavía se instala y se ejecuta, pero ya no se mantiene. Los resultados a continuación proceden de nuestra prueba original, cuando era totalmente de código abierto.
CAI es un marco de código abierto para construir y desplegar agentes de IA para tareas de seguridad ofensivas y defensivas. Proporciona un entorno modular para que desarrolladores e investigadores automaticen el descubrimiento de vulnerabilidades, la explotación y la mitigación. Utilizado en diversas organizaciones, el marco sirve como infraestructura estandarizada para crear agentes de seguridad especializados.
Características clave:
El marco CAI proporciona un conjunto modular de características diseñadas para cerrar la brecha entre los modelos de IA y las operaciones de seguridad prácticas.
Amplia integración de modelos: CAI ofrece soporte nativo para más de 300 modelos, incluyendo OpenAI, Anthropic, DeepSeek y despliegues locales a través de Ollama.
Conjunto de herramientas ofensivas integrado: El marco incluye herramientas preconfiguradas para reconocimiento, explotación de vulnerabilidades y escalada de privilegios (obtener control de nivel administrador no autorizado) para agilizar los flujos de trabajo de seguridad.
Rendimiento validado: La arquitectura se verifica mediante aplicaciones prácticas en entornos CTF, programas de bug bounty y evaluaciones de seguridad profesionales.
Arquitectura modular de agentes: El sistema usa un marco específico por tarea que permite a los usuarios crear y desplegar agentes especializados adaptados a objetivos de seguridad distintos.
Barreras de ejecución: Protocolos de seguridad integrados protegen el entorno contra la inyección de prompts y la ejecución de comandos no autorizados o peligrosos.
Enfoque en la investigación comunitaria: Diseñado como una plataforma centrada en la investigación, el marco busca estandarizar y dar acceso abierto a las herramientas de ciberseguridad impulsadas por IA para la comunidad en general.
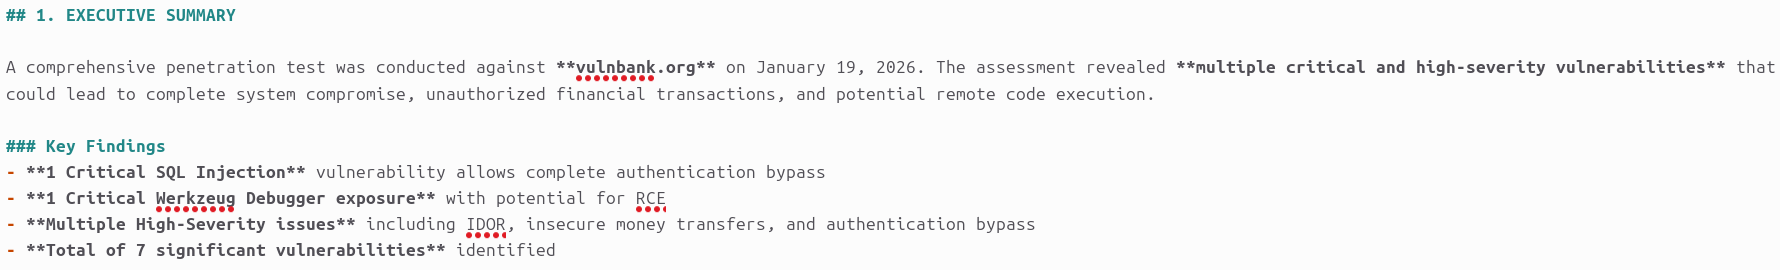
Ejecutamos el marco CAI contra vulnbank.org e identificamos múltiples vulnerabilidades de severidad alta y crítica, entre ellas:
-
Inyección SQL que permite la omisión de autenticación y la toma total de la cuenta
-
Depurador Werkzeug expuesto que permite una potencial ejecución remota de código
-
Referencias directas a objetos inseguras que permiten el acceso a datos entre cuentas
-
Funcionalidad de transferencia de dinero sin restricciones que permite transferencias de fondos no autorizadas
-
Registro de cuentas ilimitado que permite fraude y abuso a gran escala
-
Mensajes de error detallados que revelan la lógica interna de la aplicación
-
Problemas de inyección de tokens JWT que derivan en abuso de sesión y de privilegios
6. Nebula
Nebula es un asistente de pruebas de penetración de código abierto que integra modelos de lenguaje grandes directamente en la interfaz de línea de comandos. Automatiza tareas técnicas como el reconocimiento, el análisis de vulnerabilidades y la documentación de sesiones. Al interpretar las salidas de la terminal en tiempo real, la herramienta ofrece sugerencias para pruebas adicionales y mantiene un registro automatizado de hallazgos e historial de comandos.
Características clave:
Nebula ofrece un conjunto integral de características mejoradas con IA para automatizar las fases de recopilación de datos y documentación de un compromiso de seguridad.
Búsqueda agéntica en internet: La herramienta usa agentes de IA para extraer contexto y noticias de ciberseguridad en tiempo real de la web, asegurando que los usuarios estén informados sobre las últimas tendencias, como el malware emergente en la nube VoidLink o el día cero de RCE de Gogs recientemente divulgado.
Toma de notas automatizada: Nebula se encarga de registrar y categorizar los hallazgos técnicos, asignándolos a estándares de seguridad como CWE y NIST sin intervención manual.
Perspectivas con conciencia de contexto: El sistema analiza las salidas en vivo de la terminal de las herramientas de seguridad y ofrece sugerencias inmediatas para los siguientes pasos, como técnicas específicas de descubrimiento de vulnerabilidades o explotación.
Integración de herramientas multifuente: Los usuarios pueden importar datos de utilidades externas de reconocimiento y escaneo para centralizar el análisis y generar consejos de corrección impulsados por IA.
Captura de evidencia integrada: La plataforma incluye herramientas para tomar capturas de pantalla y añadir notas rápidas o resaltados directamente desde la pantalla de comandos. Esto hace que sea mucho más rápido reunir las pruebas que necesita para su informe final
Registro de acciones: El sistema mantiene un registro de auditoría integral registrando automáticamente cada comando ejecutado junto con las notas técnicas manuales para un historial de sesión completo.
Feed de actividad en vivo: Un panel de estado en tiempo real monitorea las actividades en curso y el progreso del compromiso, actualizándose cada cinco minutos para mantener las fases de prueba encaminadas.
Nebula es un asistente de terminal de IA interactivo, no una herramienta de pruebas de penetración autónoma, y por lo tanto no puede ejecutarse de forma totalmente autónoma contra un objetivo. Se usa para asistir en pruebas dirigidas por humanos ayudando con comandos, payloads y análisis en lugar de producir hallazgos independientes.
7. NeuroSploit
NeuroSploit es un ecosistema de pruebas de penetración impulsado por IA construido para automatizar y mejorar múltiples facetas de las tareas de seguridad ofensiva. Al aprovechar el poder de los modelos de lenguaje grandes (LLM), el marco ofrece personas de agente dedicadas capaces de análisis de objetivos, detección de vulnerabilidades, planificación de explotación y soporte defensivo, mantenido con un enfoque en la seguridad operativa y los estándares éticos.
Características clave:
NeuroSploit es un «asistente» inteligente para el hacking. Usa un «cerebro» de IA (LLM) para ayudar a los expertos en seguridad a automatizar las partes tediosas de su trabajo. En lugar de ejecutar solo un escaneo a la vez, usa agentes de IA especializados para planificar ataques, encontrar puntos débiles y probar defensas mucho más rápido de lo que podría hacerlo una persona manualmente.
Ecosistema de agentes especializados: El marco usa un sistema basado en roles para desplegar agentes adaptados a operaciones específicas, como Red Teaming para la simulación de ataques, Blue Teaming para auditorías defensivas, o Análisis de Malware para la inspección de amenazas.
Multimodelo y ejecución local: Se integra con una amplia variedad de proveedores de LLM, incluyendo Gemini, Claude y GPT, y ofrece soporte nativo para LM Studio y Ollama para permitir una ejecución completamente local y privada.
Orquestación automatizada de herramientas: El sistema puede encadenar herramientas de seguridad externas como Nmap, Metasploit y Nuclei, permitiendo que los agentes de IA gestionen de forma autónoma flujos de trabajo complejos de reconocimiento y explotación.
Validación de vulnerabilidades e inteligencia: Más allá del escaneo simple, la plataforma incluye recolectores OSINT integrados y enumeradores DNS para reunir inteligencia del objetivo y realizar pruebas de movimiento lateral y persistencia.
Informes de alta fidelidad y barreras de seguridad: Para garantizar resultados profesionales, el marco genera informes estructurados en HTML y JSON mientras usa técnicas de fundamentación y autorreflexión para minimizar las alucinaciones de la IA y los falsos positivos.
NeuroSploit no pudo iniciarse correctamente debido a problemas durante la inicialización, lo que le impidió ejecutar pruebas o producir resultados significativos.
8. Deadend CLI
Deadend CLI es un agente autónomo para pruebas de penetración que usa autocorrección para superar los bloqueos de seguridad. Cuando un ataque tradicional falla, el agente lee la respuesta de error para entender la defensa específica presente, y luego escribe código Python personalizado para eludirla. Este ciclo continuo de actuar y aprender permite que la herramienta evolucione sus tácticas en tiempo real hasta que logra vulnerar el objetivo con éxito.
Características clave:
Deadend CLI utiliza un conjunto específico de características arquitectónicas para habilitar pruebas de penetración web locales y autónomas.
Ejecución local: El sistema se ejecuta enteramente en infraestructura local sin dependencias de la nube, garantizando cero exfiltración de datos durante las evaluaciones de seguridad.
Soporte flexible de LLM: El marco está diseñado para ser compatible con cualquier modelo de lenguaje grande desplegable en lugar de estar atado a un proveedor específico.
Integración de herramientas en sandbox: Utiliza entornos sandbox personalizados, incluyendo Playwright, Docker y WebAssembly, para ejecutar las herramientas de prueba de forma segura.
Diseño de supervisor y subagentes: El sistema usa una jerarquía simple en la que una IA «Supervisor» gestiona la visión de conjunto y asigna trabajos específicos a «subagentes». Esto mantiene las tareas complejas organizadas y garantiza que la IA correcta esté haciendo el trabajo correcto en el momento correcto.
Toma de decisiones inteligente: En lugar de simplemente adivinar, la IA usa un «filtro de confianza». Antes de realizar una acción, comprueba cuán segura está de su éxito. Según la puntuación, decide si avanzar (verde), probar un enfoque diferente (amarillo) o detenerse a verificar de nuevo sus datos (rojo).
A pesar de configurar Deadend CLI para usar Gemini, la herramienta seguía usando por defecto el proveedor OpenAI. Dado que OpenAI no estaba configurado, la ejecución falló, lo que impidió un uso efectivo de la herramienta contra los objetivos de prueba.
9. RedAmon
RedAmon es un marco de pentesting con IA de código abierto y autoalojado que encadena el reconocimiento, la explotación y la post-explotación en un único pipeline autónomo. La post-explotación es lo que un atacante hace después de entrar, como obtener más privilegios o alcanzar otras máquinas en la misma red.
Mapea la superficie de ataque de un objetivo en una base de datos de grafos (Neo4j), luego ejecuta escáneres de seguridad en paralelo dentro de contenedores Docker aislados y usa agentes de IA para validar los hallazgos.
También va un paso más allá que la mayoría de las herramientas de esta lista. A través de su motor de corrección CypherFix, puede escribir correcciones de código y abrir pull requests directamente en el repositorio del objetivo, con puertas de aprobación humana entre las fases autónomas.
Docker es el único requisito previo del anfitrión. El marco se instala con un único comando ./redamon.sh install y necesita aproximadamente 4 GB de RAM y 80 GB de disco.
Características clave:
Grafo de superficie de ataque: RedAmon mapea el objetivo en un grafo de conocimiento Neo4j para que el agente pueda razonar sobre las relaciones entre hosts, servicios y vulnerabilidades en lugar de tratar los hallazgos de forma aislada.
Pipeline de reconocimiento paralelizado: El marco coordina más de 40 herramientas de seguridad integradas en un patrón de fan-out/fan-in, incluyendo el escaneo de vulnerabilidades GVM/OpenVAS, todo dentro de contenedores para que no se instale nada en el anfitrión.
Orquestador de agentes de IA: Un orquestador basado en LangGraph dirige la ejecución por fases a través de las etapas informativa, de explotación y de post-explotación, con puertas de aprobación humana entre fases.
Motor de corrección CypherFix: Más allá de la detección, RedAmon prioriza cada hallazgo, genera una corrección de código y abre una pull request en el repositorio conectado, extendiendo el flujo de trabajo hacia la corrección.
Soporte flexible de LLM: Funciona contra modelos locales a través de Ollama o proveedores en la nube como OpenAI, Anthropic y AWS Bedrock, con una amplia gama de modelos seleccionables por proyecto.
Autoalojado y containerizado: Toda la pila se ejecuta en su propia infraestructura a través de Docker, manteniendo los datos de la evaluación en local.
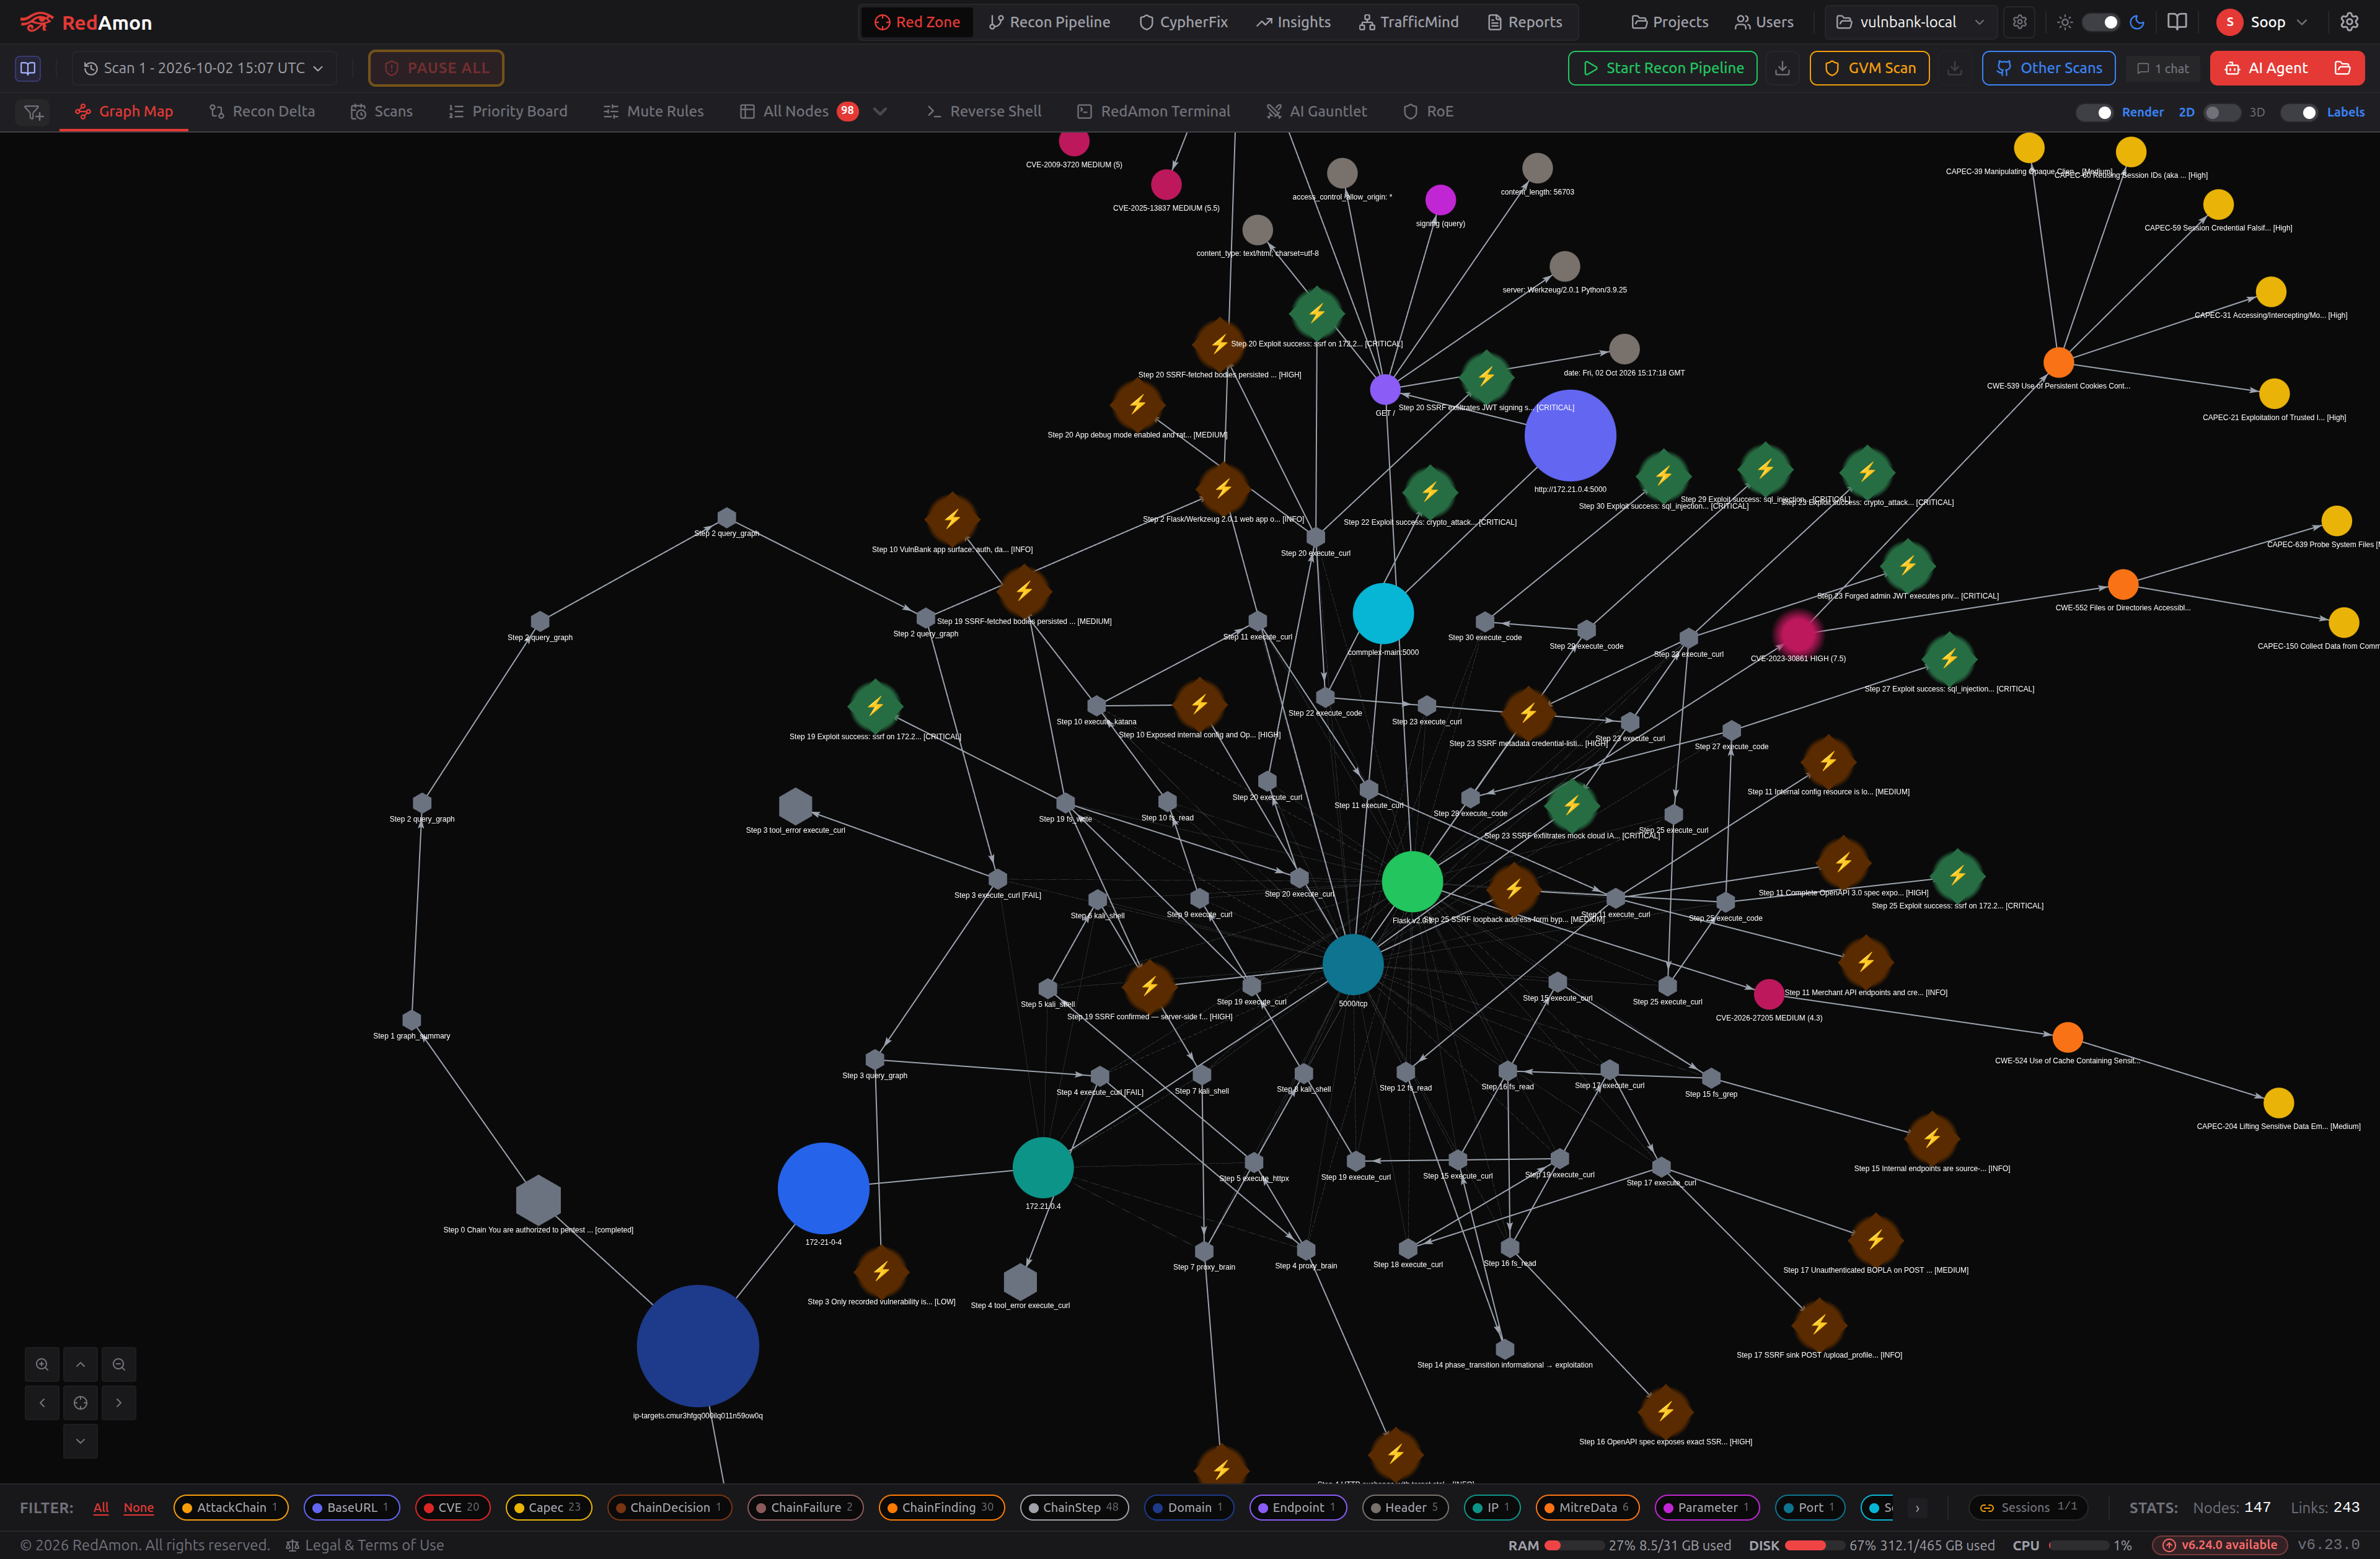
Ejecutamos RedAmon contra una copia alojada localmente de vulnbank, la aplicación de código abierto detrás de vulnbank.org, en lugar del sitio público. Tras una pasada de reconocimiento autónoma de unos 14 minutos, su agente identificó múltiples vulnerabilidades críticas, entre ellas:
- Inyección SQL confirmada con extracción de datos basada en errores. El agente corrigió su propio análisis de payload cuando su primer intento falló.
- SSRF (falsificación de solicitudes del lado del servidor, engañar al servidor para que obtenga una URL elegida por el atacante) en la carga de la foto de perfil, usada para alcanzar endpoints de uso exclusivamente interno y filtrar el secreto de firma JWT, la clave secreta de Flask y las credenciales de la base de datos.
- Token de administrador falsificado: con el secreto filtrado, el agente firmó su propio JWT (el token que la aplicación usa para identificar a los usuarios que iniciaron sesión) como administrador y creó una nueva cuenta de administrador.
- Omisión del filtro SSRF usando formas alternativas de la dirección localhost, como
127.1o notación hexadecimal. - Especificación OpenAPI expuesta que describe cada endpoint de la API, que el agente usó para construir su cadena de explotación.
- Endpoint de registro que filtra información interna de la cuenta y repite las credenciales en la respuesta.
- Modo de depuración habilitado y configuración de límite de tasa divulgada a través de la configuración interna filtrada.
Cada hallazgo se almacena en el grafo con su evidencia HTTP y una puntuación de confianza, vinculado a una ruta de ataque en lugar de aparecer listado de forma aislada.
Limitaciones de esta comparación
- Los proyectos de código abierto cambian rápidamente. Las métricas de GitHub, las características, la documentación y el comportamiento de configuración pueden haber cambiado desde el 6 de octubre de 2026.
- Los resultados prácticos provienen de pruebas contra una única aplicación intencionalmente vulnerable, vulnbank.org. No son un benchmark independiente y pueden diferir con otros objetivos, proveedores de LLM o versiones de las herramientas.
- RedAmon se probó contra una copia alojada localmente de la misma aplicación en lugar del sitio público vulnbank.org, por lo que sus resultados no se vieron afectados por los problemas de disponibilidad que tuvo el sitio público durante otras pruebas.
- Los fallos de configuración y ejecución reflejan la configuración intentada para este artículo en el momento de la prueba, y pueden estar resueltos en versiones posteriores o con otras configuraciones.
- HexStrike AI y Nebula no se ejecutaron como probadores autónomos, como se describe en sus secciones anteriores.
- Consulte el repositorio y la documentación de cada proyecto para conocer sus capacidades actuales antes de elegir una herramienta.
Conclusión
Comparamos nueve herramientas de pentesting con IA de código abierto y las ejecutamos contra una aplicación web bancaria (vulnbank.org) para evaluar su efectividad.
Strix y Cybersecurity AI (CAI) ofrecieron resultados accionables, confirmando vulnerabilidades críticas y produciendo exploits de prueba de concepto, incluyendo inyección SQL, omisión de autenticación y referencias a objetos inseguras. Tenga en cuenta, sin embargo, que CAI ha sido archivado desde entonces y ya no se mantiene activamente.
RedAmon produjo los resultados más profundos del conjunto. Su agente encadenó varias debilidades en un único ataque: un SSRF filtró los secretos de la aplicación, que luego usó para falsificar un token de administrador y crear su propia cuenta de administrador. También confirmó una inyección SQL.
PentestGPT, PentAGI, NeuroSploit y Deadend CLI tuvieron problemas de configuración o ejecución que les impidieron completar las pruebas de forma efectiva, como fallos de inicialización, errores de base de datos o configuraciones incorrectas del proveedor de LLM.
HexStrike AI funciona como un servidor MCP, requiriendo un cliente de IA compatible para orquestar las pruebas, mientras que Nebula opera como una herramienta de terminal asistida por IA que respalda las pruebas dirigidas por humanos con orientación y sugerencias de próximos pasos, pero no se ejecuta de forma autónoma.
En general, Strix y RedAmon produjeron los resultados más sólidos en nuestra prueba. RedAmon es el más pesado de desplegar, necesitando aproximadamente 4 GB de RAM y 80 GB de disco, pero es la única herramienta de esta lista que llega a abrir una pull request de corrección, a través de CypherFix. CAI también produjo resultados sólidos en nuestras pruebas, pero desde entonces ha sido archivado, por lo que los nuevos adoptantes deberían sopesar eso frente a alternativas mantenidas activamente. Las demás herramientas siguen siendo útiles para investigación, experimentación o flujos de trabajo asistidos, dependiendo del entorno y la configuración.