显微镜下的 Swift:动态插桩实战
关于 Swift 动态插桩的文章。本文讲解对基于 Swift 的应用进行动态分析的步骤,涵盖名称修饰(name mangling)、Swift ABI 以及在 Swift 中提取函数参数。
引言
安全专家可以在运行时深入探查程序的行为,以识别安全缺陷和恶意活动。即便是 iOS 应用,作为一名安全研究人员,您也可以拦截和检查系统调用、跟踪内存分配,并将自定义代码注入到正在运行的进程中。从而揭露隐藏的漏洞,迅速(swiftly,一语双关)识别并消除新出现的威胁。
动态插桩详解
与在执行前检查代码的传统静态分析方法不同,动态插桩是实时工作的。它在程序运行时与之建立连接,以便监控、调整和增强其行为。
研究人员可以在操作开始时,将专门的插桩代码(也称为探针或 Hook)精心插入目标应用的二进制文件或字节码中,从而监控系统调用、内存访问和网络交互等重要事件。
当被插桩的程序运行时,这些 Hook 会在预定情形出现时释放数据或触发操作,从而实现实时监控、性能剖析、调试和安全分析。可以把它们看作您插入代码中的断点,当代码执行到断点时就会触发一个回调。最后一步是分析收集到的数据,以洞察应用的运行时行为。值得一提的是,这种分析并不局限于安全分析,根据您的目标,它也可能涉及调试和性能剖析。
让我们开始吧
整个过程的完整流程可以简要描述如下:
1. 找到目标应用。
2. 识别监控点,也就是 Hook。
3. 使用任意插桩框架编写插桩代码。
4. 注入插桩代码。
5. 最后,分析结果和堆栈跟踪。
识别 Hook
一个应用会有数千个函数。其中只有少数几个对安全研究人员来说是有意思的,因此整个过程的第一步就是识别出应当被监控的函数。接着,我们需要找到用于 Hook 的符号。
我们可以使用 nm 这个专门用于列出目标文件中符号的 CLI 工具来做到这一点。
假设我们想要对 DummyModule.swift 内的一个 dummyFunction 进行插桩:
public class Dummy {
    public class AnotherDummyClass {
        public func dummyFunction(intDummyArg: Int, stringDummyArg: String, booleanDummyArg: Bool) -> String {
            return "I am just a dummy function."
        }
    }
}
我们编译并运行 nm -g DummyModule 命令,得到的符号如下所示:
$s11DummyModule0A0C07AnotherA5ClassC13dummyFunction03intA3Arg06stringaH007booleanaH0SSSi_SSSbtF
Swift 名称修饰
在编译器设计中,符号解析是链接器的职责之一;它将一个文件中声明的符号与另一个文件中对这些符号的引用相匹配,从而解析目标文件之间的符号引用。
在像 C 这样的语言中,名称修饰是不必要的,因为任何给定名称(一个符号)只可能对应一个函数或数据项。而在那些允许在同一个类上以不同签名对相似选择器进行重载和模板化的语言中,情况就变得棘手了。
例如:
    int add(int a, int b)

    float add(float a, float b)
编译器会修饰(mangle)这些符号,也就是说,它会给这些函数赋予链接器能够理解的唯一标识符。
第一个直觉上的想法是使用完整的签名:add(int, int)->int,但这会在链接器中引入大量额外代码,并且当多个类型名称映射到同一个底层类型(例如 unsigned 和 unsigned int)时会造成混乱。
由于 Swift 中的名称修饰并非本文的主题,我们尝试通过前面的
dummyFunction 示例来解释它的一些规则:
public class Dummy {
    public class AnotherDummyClass {
        public func dummyFunction(intDummyArg: Int, stringDummyArg: String, booleanDummyArg: Bool) -> String {
            return "I am just a dummy function."
        }
    }
}
它修饰后的符号是:
$s11DummyModule0A0C07AnotherA5ClassC13dummyFunction03intA3Arg06stringaH007booleanaH0SSSi_SSSbtF:
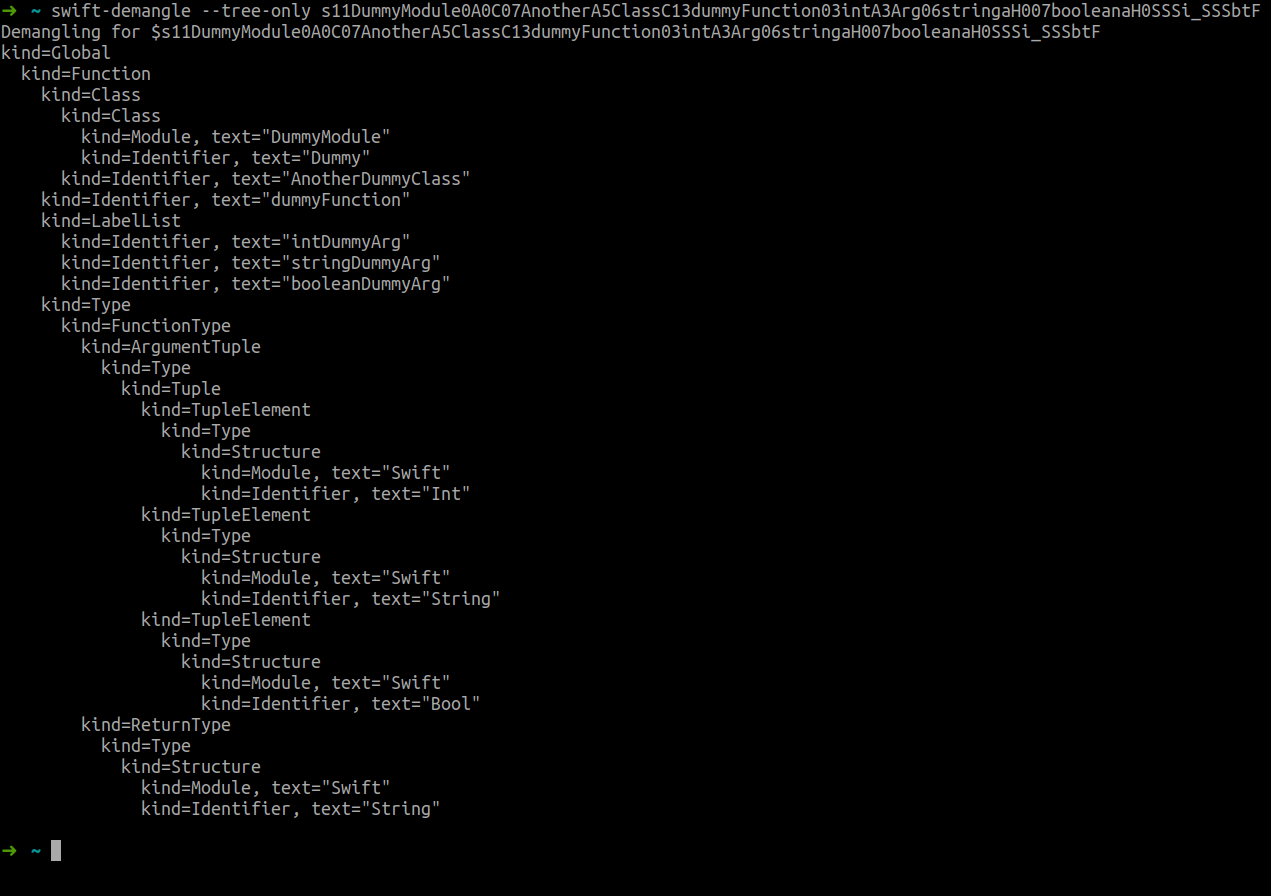
$s:全局 swift 符号前缀;11DummyModule:模块名称——长度为 11 个字符;0A0C:该标识符以0开头,因为将使用替换(Substitution);单词Dummy在后续出现时将用字符A表示。由于Dummy是最后一个标识符,我们用另一个0结束其修饰版本,最后,C表示我们处理的是一个Class;07AnotherA5ClassC:0表示该标识符有单词替换,Another——7 个字符,A替换Dummy,Class——5 个字符,与前一个标识符类似,C表示我们处理的是一个类;13dummyFunction:函数名dummyFunction——长度为 13 个字符;03intA3Arg:0表示替换,int-3 个字符,A替换Dummy,最后Arg为 3 个字符;06stringaH0:与前一个参数类似,唯一的区别是Arg将被替换;007booleanaH0:与前一个参数类似;SS:返回类型Swift.String;Si:参数类型Swift.Int;SS:参数类型Swift.String;Sb:参数类型Swift.Bool;F:最后一个符号表示这是一个Function(函数)的符号。
下面是 swift-demangle 的输出,它是一个专为对 Swift 符号进行反修饰(demangling)而设计的程序。
准备应用
借助 Frida 这样的框架,我们通过引入必要的库并启用 FridaGadget 来为应用做好插桩准备。 下面的设置允许注入自定义代码并监控应用行为。
- 从主发布页面下载与您架构相对应的 FridaGadet.dylib;
- 将 FridaGadget.dylib 移动到您应用的
Frameworks文件夹中; - 为该 gadget 插入一条 load 命令;
insert_dylib:“一个用于将 dylib load 命令插入 Mach-O 二进制文件的命令行工具”; - 当您运行该应用时,它预计会卡住;它正在等待 frida-client 附加;
- 在这里,可以使用多种方法:
- 用于快速原型开发:
frida-ps - 对于监控自己应用的开发者,可以使用一个简单的 Python 脚本来附加到应用;
- 用于快速原型开发:
    import frida
    def on_frida_message(message, data):
        # Callback to execute when a frida-message is received.

    device_id = "your-device-id"
    frida_device = frida.get_device(device_id)
    frida_session = frida_device.attach("gadget")
    script_path = "path/to/instrument.js"
    with open(script_path, "r") as f:
        frida_script = frida_session.create_script(f.read())
        frida_script.on("message", on_frida_message)
        frida_script.load()
- 根据使用场景的不同,
on_frida_message回调的主体可以从简单地在终端上打印、将堆栈跟踪持久化到文件,到将它们传入安全规则进行分析,范围各不相同; - 拼图中缺失的部分是
instrument.js的内容。当我们的函数被拦截时,我们究竟要做什么?要回答这个问题,我们需要理解几个要点。
插桩代码
Swift ABI —— 应用二进制接口
在运行时,Swift 程序的二进制文件通过 ABI(即“应用二进制接口”,Application Binary Interface)与其他库和组件交互。它是独立编译的二进制实体为了能够被链接在一起并执行而必须遵循的规范。
这些二进制实体必须就许多底层细节达成一致:如何调用函数?它们的数据在内存中如何表示?乃至它们的元数据位于何处以及如何访问。函数之间还必须知道如何相互调用,这涉及诸如调用栈的布局、哪些寄存器被保留,以及所有权约定等问题。
调用约定
下面是 ARM64 和 x86-64 寄存器使用表的一个片段,完整列表和更多细节请查看 swift GitHub 代码仓库:
ARM64
| 寄存器 | 特殊 | 用途 | Swift |
|---|---|---|---|
| x0 | 整型参数 1(第 1 个返回值) | ||
| x1 | 整型参数 2(第 2 个返回值) | ||
| x2 - x7 | 整型参数 3-8 | ||
| x8 | 间接结果位置寄存器 | ||
| x16 | ip0 | 临时寄存器 | |
| x17 | ip1 | ||
| x18 | 保留,请勿使用 | ||
| x19 | 被调用者保存的寄存器 | self | |
| .. | .. | ..... | .. |
X86-64
| 寄存器 | 用途 | Swift |
|---|---|---|
| rax | 返回值;此外,对于可变参数,是所用 xmm 寄存器的数量 | |
| rbx | 被调用者保存的寄存器 | |
| rdi | 整型参数 1 | |
| rsi | 整型参数 2 | |
| rdx | 整型参数 3(第 2 个返回值) | |
| rcx | 整型参数 4(第 3 个返回值) | |
| .. | ..... | .. |
参数
现在我们知道了函数的参数将存放在何处,让我们来尝试提取它们。
布尔值
布尔值可以通过直接读取存放该参数的寄存器来访问。
/** Get the boolean argument of a function.
 *
 * @param context Frida context giving access to register values.
 * @param argIndex Argument index to determine which offset is the arg pointer.
 * @returns The boolean value of the argument as an integer.
 */
function GetSwiftBoolArgument(context, argIndex, swiftRegisterShiftingIndex) {
    argIndex+=swiftRegisterShiftingIndex
    let register = getSwiftArgumentCorrespondingRegisterForARM64(context, argIndex);
    return Boolean(register.and(0x1).toInt32())
}
整数
与布尔值一样,整数只需访问寄存器的值即可获取。
/** Get the integer argument of a function.
 *
 * @param context Frida context giving access to register values.
 * @param argIndex Argument index to determine which offset is the arg pointer.
 * @returns The integer value of the argument.
 */
function GetSwiftIntArgument(context, argIndex, swiftRegisterShiftingIndex) {
    argIndex+=swiftRegisterShiftingIndex
    let register = getSwiftArgumentCorrespondingRegisterForARM64(context, argIndex);
    return  register.toInt32();
}
字符串
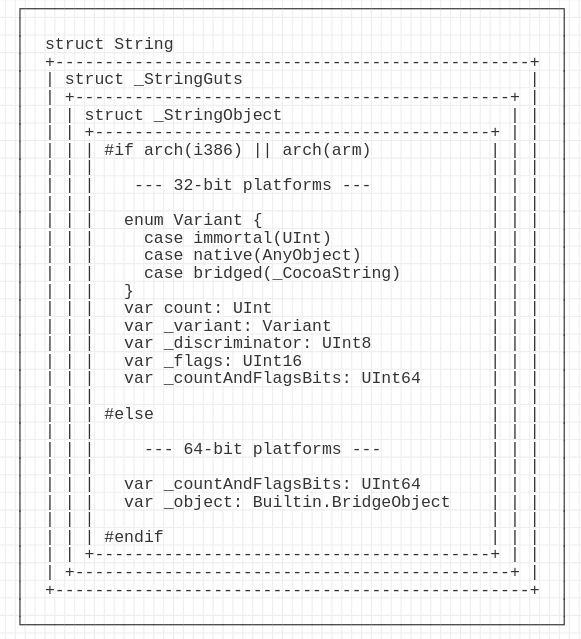
当 Swift 字符串被传递给函数时,根据其大小可以有两种传递方式。如果大小小于 16 字节,字符串在栈上传递,否则将在堆上传递。 不过,无论大小如何,对象本身都会遵循下图所示的结构。
小于 16 字节
字符串的长度最多为 16 字节。在 64 位架构上,寄存器是 64 位的,这意味着我们需要 2 个寄存器来存放这个字符串。
这一信息改变了我们对之前所见的调用约定表的整体理解。如果一个函数接受 2 个参数,其中第一个是 Swift.String 类型,第二个是 Swift.Int 类型,那么规则是否只适用于整型参数呢?
    ```
    rdi:  Integer argument 1
    rsi:  Integer argument 2
    ```
如果规则不只适用于整型参数,那么我们是否用第一个寄存器来存储字符串?是否要移位?如果我们有不止一个参数,它们是否全部都要移位?
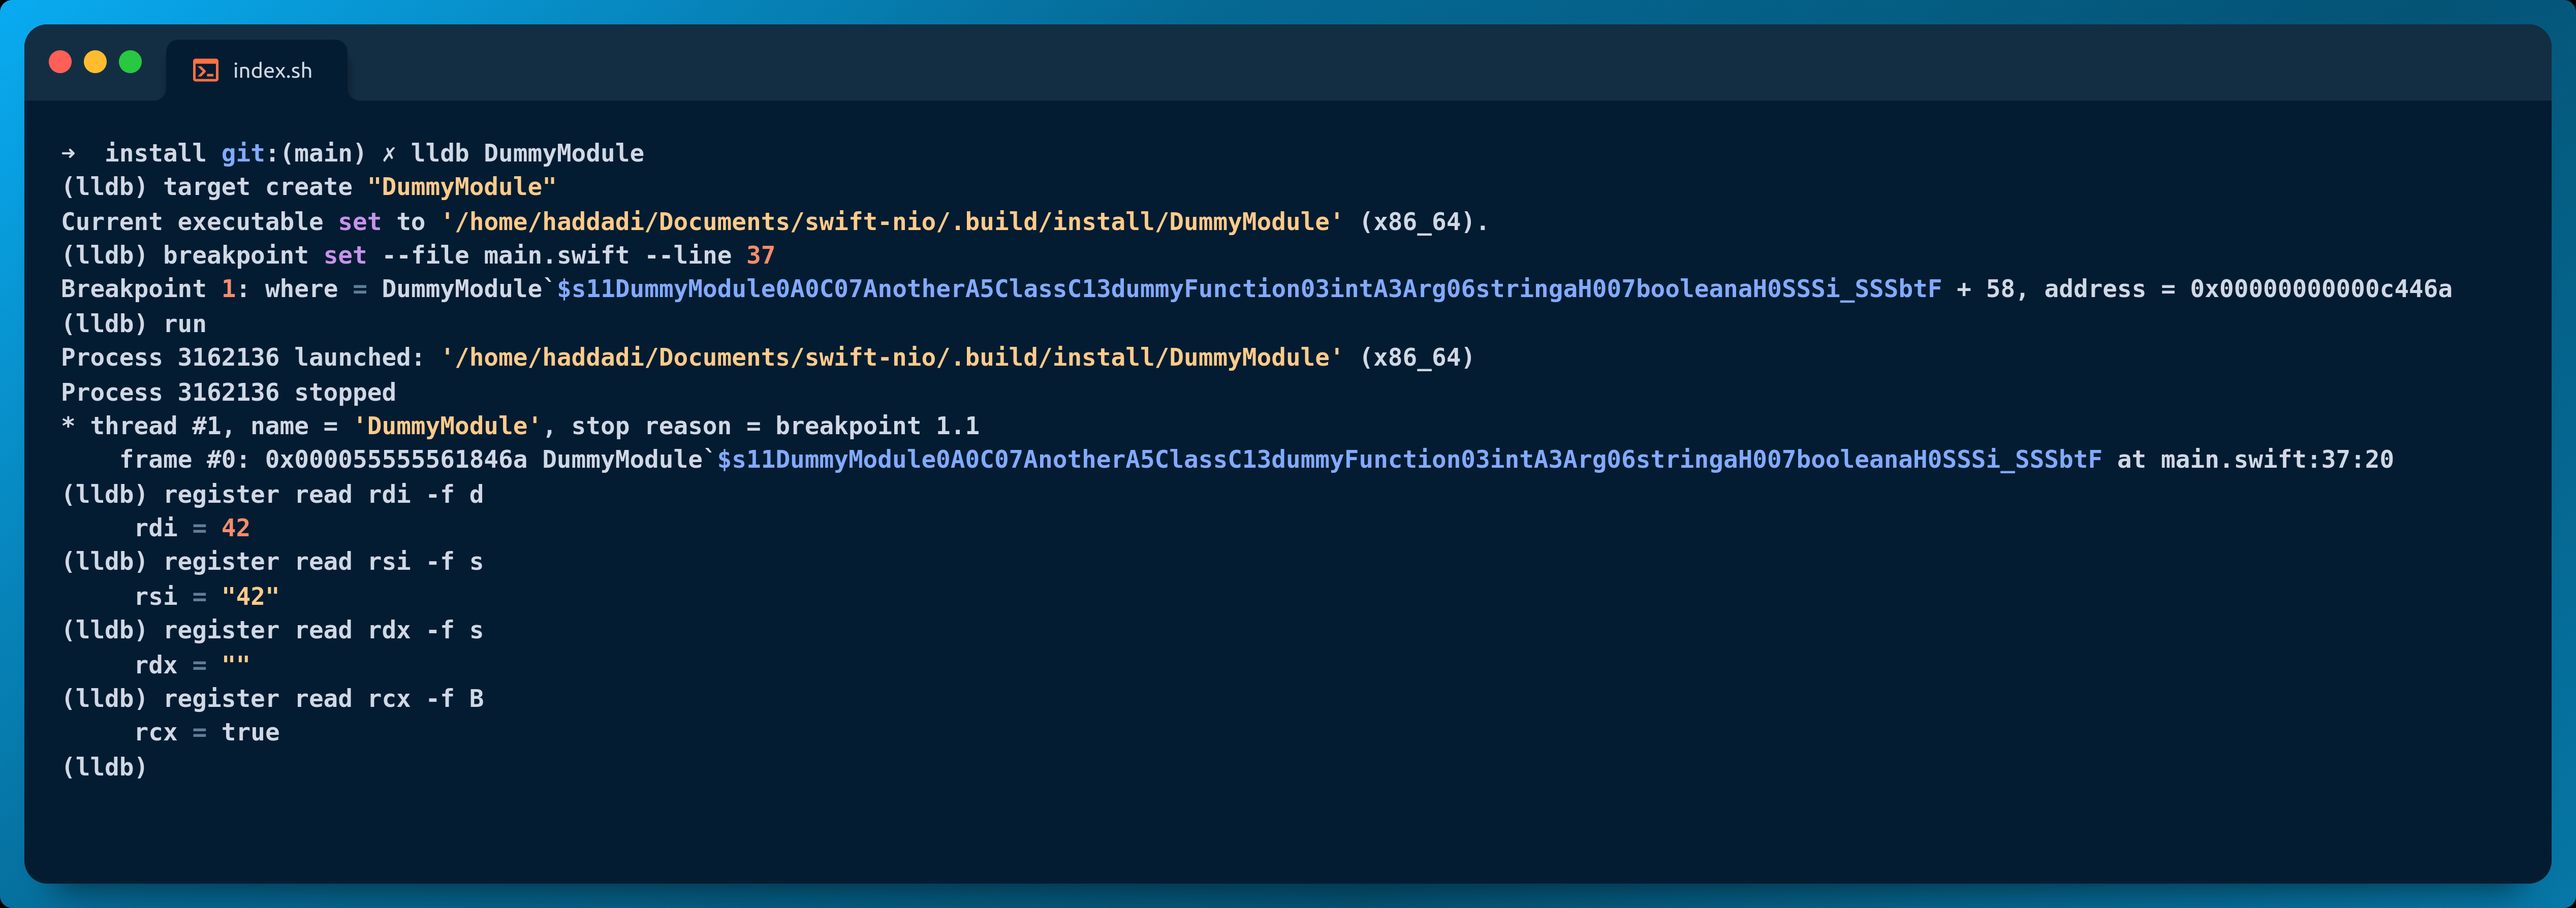
为了回答这个问题,我们可以简单地运行一个应用,使用 LLDB 附加,然后窥探一下寄存器的值。
- 首先,我们对在修饰章节中所见的 dummy 模块运行
lldb;
-> ~ lldb DummyModule
(lldb) target create "DummyModule"
- 我们在 “dummyFunction” 函数上设置一个断点;
(lldb) breakpoint set --file main.swift --line 37
Breakpoint 1: where = DummyModule`$s11DummyModule0A0C07AnotherA5ClassC13dummyFunction03intA3Arg06stringaH007booleanaH0SSSi_SSSbtF + 58 address = 0x00000000000c446a
- 运行程序;
(lldb) run
Process 3162136 launched: '/home/haddadi/Documents/swift-nio/.build/install/DummyModule' (x86_64)
Process 3162136 stopped
* thread #1, name = 'DummyModule', stop reason = breakpoint 1.1
    frame #0: 0x000055555561846a DummyModule`$s11DummyModule0A0C07AnotherA5ClassC13dummyFunction03intA3Arg06stringaH007booleanaH0SSSi_SSSbtF at main.swift:37:20
- 第一个参数是整型,应当位于 “rdi” 寄存器中;
(lldb) register read rdi -f d
    rdi = 42
- 第二个参数是字符串类型,位于第二个寄存器 “rsi”;
(lldb) register read rsi -f s
    rsi = "42"
- 接下来的寄存器 “rdx”;
(lldb) register read rdx -f s
    rdx = ""

(lldb) register read rdx -f b
    rdx = 1110001000000000000000000000000000000000000000000000000000000000
第一个字节 11100010 保存着关于我们对象的元数据:
b63:isImmortal;Swift 运行时是否应跳过 ARC。小字符串只是值,始终是不朽的(immortal);b62:(大字符串)isBridged/(小字符串)isASCII;b61:isSmall:专门用于表示小字符串的位;b60:isForeign:也就是 is low,无法提供对连续 UTF-8 的访问;- 最后 4 位表示计数:0010 => 2。
为了证实这一假设,负责存放 Integer argument 4(见上表)的 rcx 寄存器,我们将以布尔格式 -f B 读取它的值。
(lldb) register read rcx -f B
    rcx = true
大于 16 字节
字符串字面量被分配在堆上,相应的寄存器(取决于该字符串参数的索引)保存着该字符串的元数据以及指向堆上字面量的指针。 _object 的 8 个字节按照下图存储在第二个寄存器中。
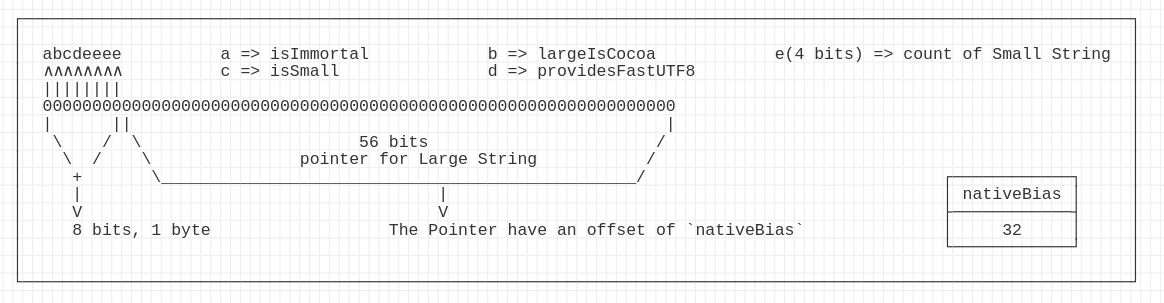
这对应于
/** Extract the string value of the argument; case of strings with length > 16 bytes.
 *
 * @param secondRegister The second register used to hold the _object value.
 * @returns The string value of argument.
 */
function GetSwiftLargeStringArgument(secondRegister) {
      const ptr2hex = '0x' + secondRegister.toString(16);
      let ptr2value = BigInt(ptr2hex);

   // low 56 bits (check drawing above)
      let strAddress = '0x' + (ptr2value & 0xFFFFFFFFFFFFFFn).toString(16);
      let strPtr = new NativePointer(strAddress);
      let cstrPtr = strPtr.add(32); // Skip the offset (check drawing above)
      const message = cstrPtr.readCString() ?? "";

      return message
}
这种基于字符串大小的处理差异,对于在插桩过程中准确提取数据至关重要。通过理解并运用这些约定,研究人员可以有效地读取和操作字符串参数,从而更深入地洞察应用的运行时行为。
结论
总之,Swift 动态插桩为安全自动化提供了一种前沿的方法,能够对软件行为进行实时分析和控制。
我们在前面的段落中尝试讲解了动态插桩的主要步骤,并通过梳理名称修饰、Swift ABI、函数原始类型参数存放的位置以及重要的存放方式,将其适配到 Swift 的使用场景。
在下一篇文章中,我们将扩展到非原始类型的参数,以及如何处理在 Objective-C 运行时中运行的函数,并以 UIKit 和 AppKit 为例。